


一、Index-TTS2简介:
IndexTTS2是一款备受瞩目的新一代文本转语音(TTS)大模型,它以其能达影视级水准的高质量语音合成效果而引人注目。IndexTTS2语音克隆技术,支持情绪控制,实现语音的情感表达和时长调节。该技术可通过上传音频样本进行单人或双人语音克隆,并提供多种情绪控制方式,包括情感参考音频、文本提示和情感向量控制。
github地址:https://index-tts.github.io/index-tts2.github.io/
IndexTTS2的优势
1.完全本地化+开放权重:开发者狂喜的“自由度”
对于开发者来说,最头疼的莫过于技术门槛高、依赖云端服务、成本居高不下。而IndexTTS2直接给出了解决方案——完全本地化部署+开放模型权重!这意味着,无论是个人开发者还是企业用户,都能在自己的设备上轻松运行模型,无需联网、无需付费订阅,想怎么用就怎么用。这种“零束缚”的体验,不仅降低了使用成本,更让TTS技术能快速落地到各种场景中,比如虚拟主播、智能客服、有声书制作等,真正实现了“技术普惠”。
2.零样本语音克隆:10秒音频,还原你的“专属声线”
传统TTS模型想要克隆一个人的声音,往往需要大量训练数据,耗时又费力。但IndexTTS2直接“开挂”——零样本语音克隆技术,只需提供一段10秒左右的音频(支持任意语言),模型就能精准捕捉音色、风格、节奏,甚至方言口音,克隆出几乎一模一样的声音。
据测试,它的效果已经超越了当前最先进的本地化TTS模型(如MaskGCT和F5-TTS),无论是温柔女声、磁性男声,还是搞怪卡通音,都能轻松搞定。这对于需要个性化配音的场景(比如短视频创作、游戏角色配音)来说,简直是“神器”级别的存在。
3.全球首创:情绪克隆+文本情绪控制,让声音“有血有肉”
声音的魅力,不仅在于“说什么”,更在于“怎么说”。IndexTTS2在情绪表达上玩出了新花样——零样本情绪克隆和文本情绪控制双管齐下。
- 零样本情绪克隆:你只需提供一段带有情绪的音频(比如愤怒的咆哮、温柔的低语),模型就能学会这种情绪,并在后续生成语音时完美复现。
- 文本情绪控制:更厉害的是,你甚至不需要音频参考,直接在文本里标注情绪(比如“[愤怒]你为什么迟到?”),模型就能自动调整语调、语速、音量,生成符合情绪的语音。
这种“情绪自由”的能力,让语音不再是冰冷的机器声,而是能传递喜怒哀乐的“活人音”。无论是电影配音、动画角色,还是情感类AI助手,都能因此更具感染力。
二、Index-TTS2安装(文末网盘附模型):
comfyui插件地址:https://github.com/yolain/comfyui-Easy-IndexTTS2
- 克隆项目
cd ComfyUI/custom_nodes
git clone https://github.com/yolain/ComfyUI-Easy-IndexTTS2
- 安装依赖
cd ComfyUI-Easy-IndexTTS2
..\..\..\python_embeded\python.exe -m pip install -r requirements.txt
V2模型下载:(文末网盘有合集)
模型手动下载到 ComfyUI\models\TTS 下的指定文件夹:
-
https://hf-mirror.com/nvidia/bigvgan_v2_22khz_80band_256x/tree/main
-
https://hf-mirror.com/funasr/campplus/tree/main
-
https://hf-mirror.com/IndexTeam/IndexTTS-2/tree/main
-
https://hf-mirror.com/amphion/MaskGCT/tree/main/semantic_codec
-
https://hf-mirror.com/facebook/w2v-bert-2.0/tree/main
transformers版本4.51.3 轮子安装(本地环境推荐大家更新到torch2.7+cuda12.8):
-
pynini轮子安装:https://github.com/billwuhao/pynini-windows-wheels/releases/tag/v2.1.6.post1 -
deepspeed轮子重新安装:https://github.com/6Morpheus6/deepspeed-windows-wheels/releases
本地环境推荐大家更新到torch2.7+cuda12.8,因为现在很多轮子是对这个支持比较好,上面deepspeed轮子最低要求也是这个。
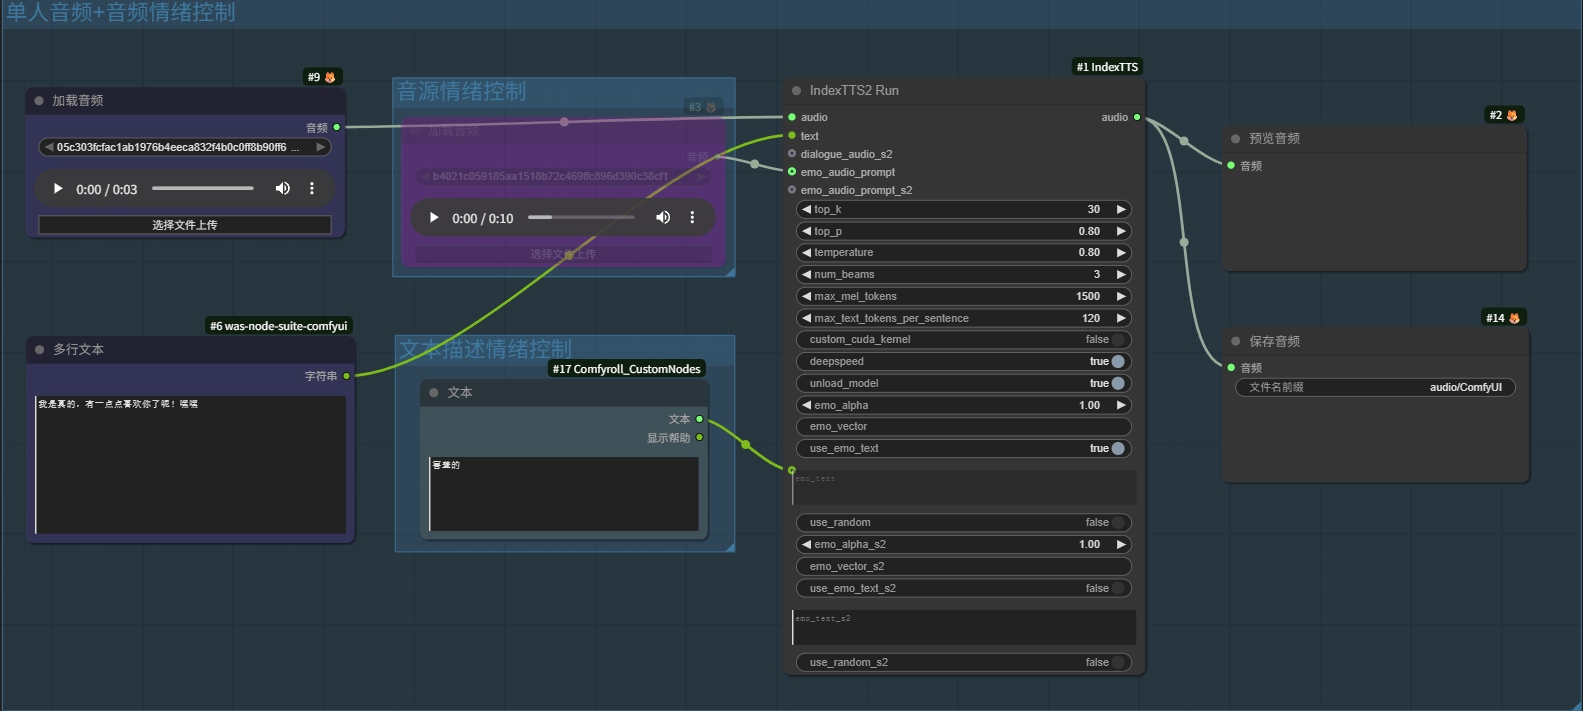
V2重要参数说明(全是可选的):
deepspeed: 是否开启 deepspeed 加速(需要先安装deepspeed)。
emo_audio_prompt: 第一个说话人,情绪音频参考。
emo_alpha: 第一个说话人,情绪强度。
emo_vector: 第一个说话人,情绪控制向量,英文格式输入类似这样的列表 [0, 0, 0, 0, 0, 0, 0.45, 0](每一个强度范围0-1,表示惊喜强度 0.45),数字分别对应 : [Happy, Angery, Sad, Fear, Hate, Low, Surprise, Neutral], 几乎无限组合。
use_emo_text: 第一个说话人,是否开启提示词控制情绪。如果使用提示词控制,情绪参考音频失效。
emo_text: 第一个说话人,情绪控制提示词。随便写,例如 哭哭。。。苦苦。。。
use_random: 第一个说话人,是否开启随机性。
emo_audio_prompt_s2: 第二个说话人,同上。
emo_alpha_s2: 第二个说话人,同上。
emo_vector_s2: 第二个说话人,同上。
use_emo_text_s2: 第二个说话人,同上。
emo_text_s2: 第二个说话人,同上。
use_random_s2: 第二个说话人,同上。
所有 TTS 节点的说话者音频全部统一放到 ComfyUI\models\TTS\speakers 路径下, 这些节点包括 IndexTTS, CSM, Dia, MegaTTS, QuteTTS, SparkTTS, StepAudioTTS 等.
三、工作流体验
效果参考:
四、总结:TTS技术的“新标杆”,未来已来
IndexTTS2的出现,无疑为TTS领域树立了新的标杆——影视级音质、零样本克隆、情绪自由、精准时长控制,这些功能不仅解决了传统模型的痛点,更打开了无数新的应用场景。无论是专业影视制作、虚拟角色开发,还是日常语音交互,它都能带来颠覆性的体验。
如果你对TTS技术感兴趣,或者正在寻找更强大的配音工具,不妨直接下载IndexTTS2到comfyui。毕竟,能让声音“活”起来的黑科技,谁不想试试呢?