
一、P-H3-Image是什么
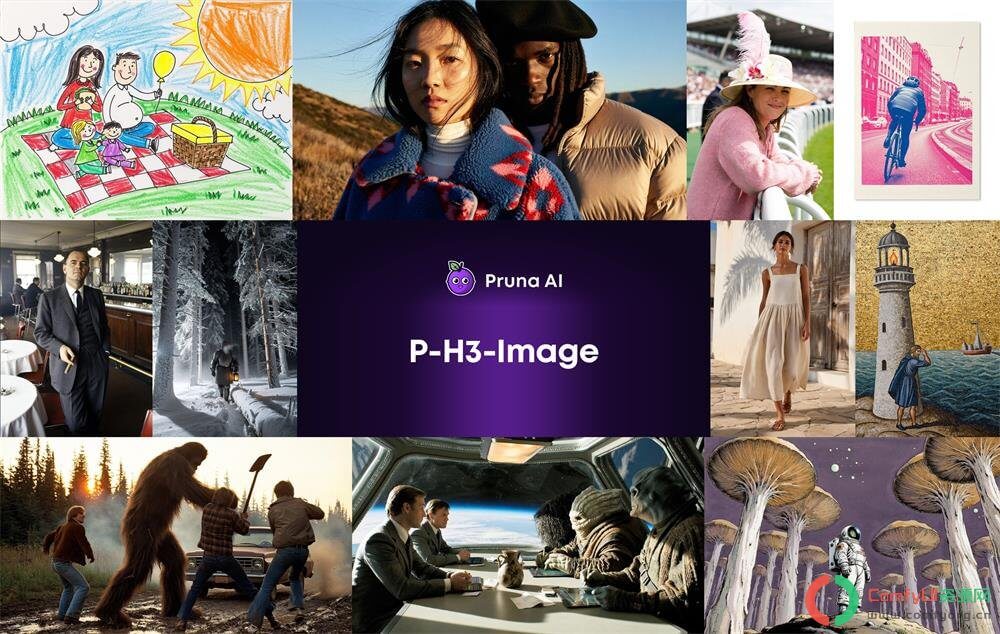
P-H3-Image 是 Pruna AI 开源的图像生成与编辑模型,由视频模型 MiniMax-H3 改造而来,主打高分辨率快速生图。P-H3-Image的底子不是图像模型。它由视频模型MiniMax-H3改造而来,被Pruna AI开源,用来做静态图像生成。这个出身直接决定了它的长板:动态感和场景氛围。P-H3-Image现在交出的是一份“质感换速度”的答卷:氛围和层次拿得出手,皮肤细节和生成效率还得再磨。对需要批量出图的工作流来说,19.33秒和153秒之间隔着的不是几秒钟,是能不能跑通的问题。
🖼️ 核心特点
- 速度与体积:推理步数从 50 步压到 8 步,生成一张 400 万像素图仅需 2.6 秒,比原路径快约 5 倍;模型体积比 H3 缩小 7 倍,普通消费级显卡即可运行。
- 画质定位:擅长照片写实、电影剧照、杂志编辑风格及带简短文字的画面。
- 分辨率与参考图:支持 2MP 到 16MP 输出,编辑时最多可参考 8 张输入图像。
- 技术架构:33.1B 参数 transformer,配 4B 文本编码器、VAE 和提示词上采样器,在 bf16 下约 100GB,是 MiniMax H3 的微调版本。
二、相关安装
1.Comfyui更新v0.44.0
模型路径
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 diffusion_models/
│   │   └── minimax_h3_fl2va_pruned_int8_convrot.safetensors
│   ├── 📂 text_encoders/
│   │   ├── p-h3-image_text_encoder_int8_convrot.safetensors
│   │   └── p-h3-image_prompt_upsampler_w4a8.safetensors
│   ├── 📂 vae/
│   │   └── p-h3-image_vae_int8_convrot.safetensors
│   └── 📂 loras/
│       └── p-h3-image_lora_bf16.safetensors
三、工作流
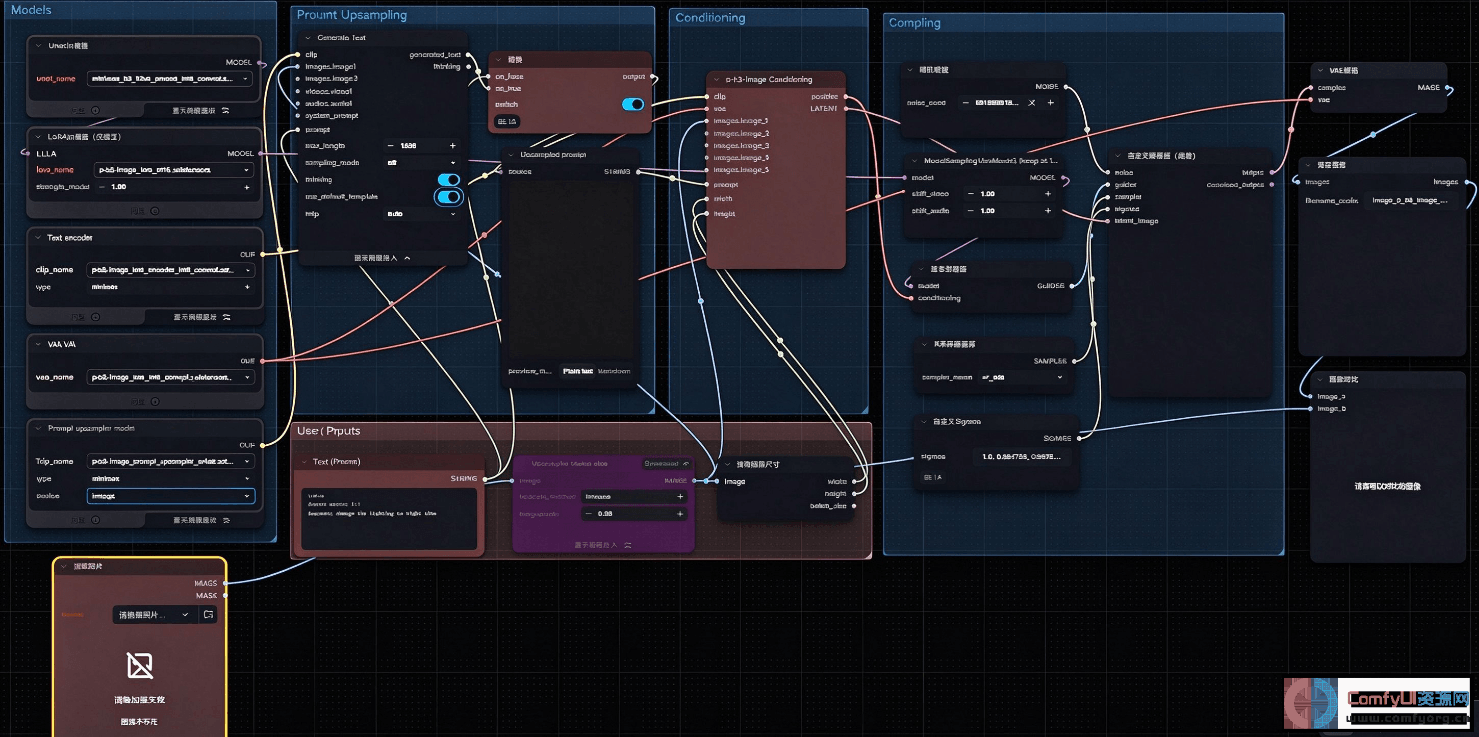
四、效果展示
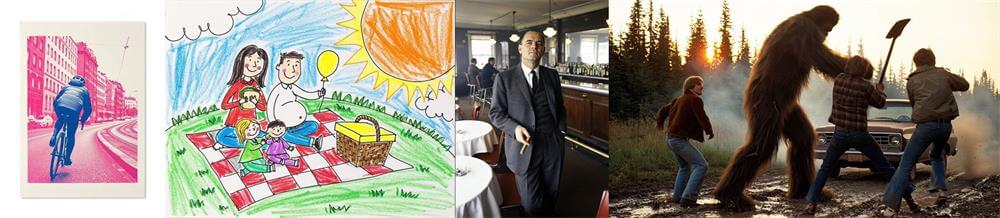
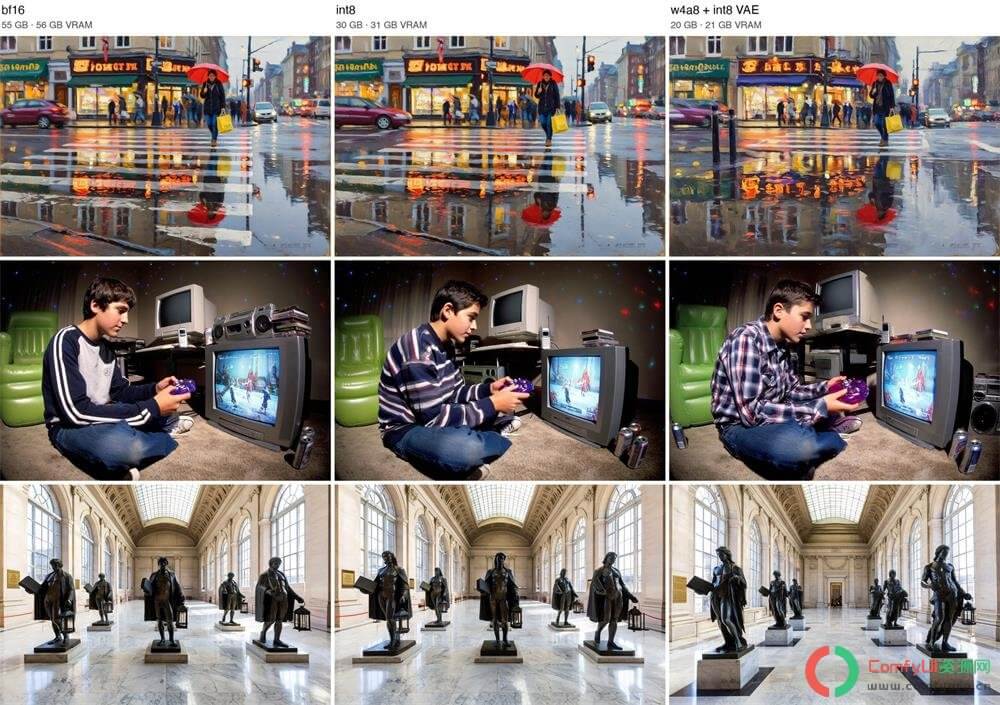
最多八张图片的编辑
一次编辑会把要修改的图像作为 image_1,再加上最多七张参考图,它们在 批量图像 中和条件节点上的顺序必须一致,并在上采样器输入中为每张图提供一个 <Picture N> 块。请求可以用任何方式指代它们,因此“第二张照片里的帽子”会解析到第二张图像。只有图片 1 会被编辑,其余仅作为上下文。
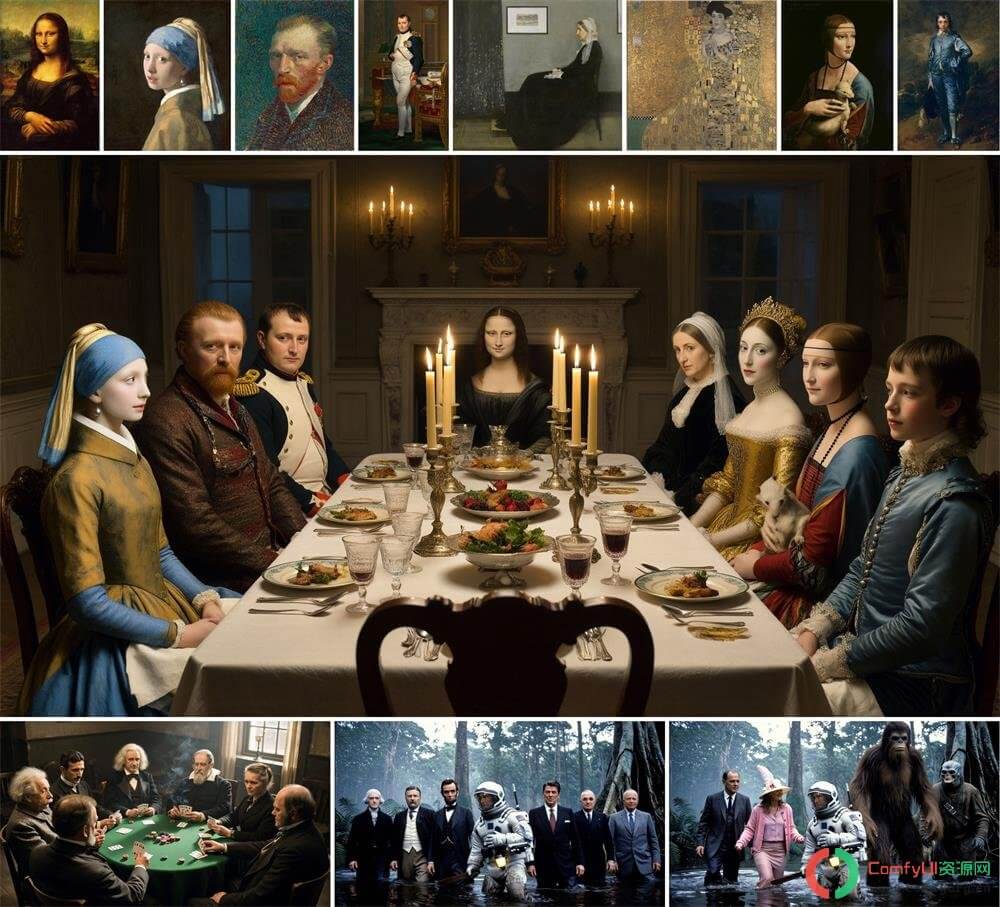
八张公有领域肖像,以及 P-H3-Image 在一次请求中由此合成的晚宴场景。
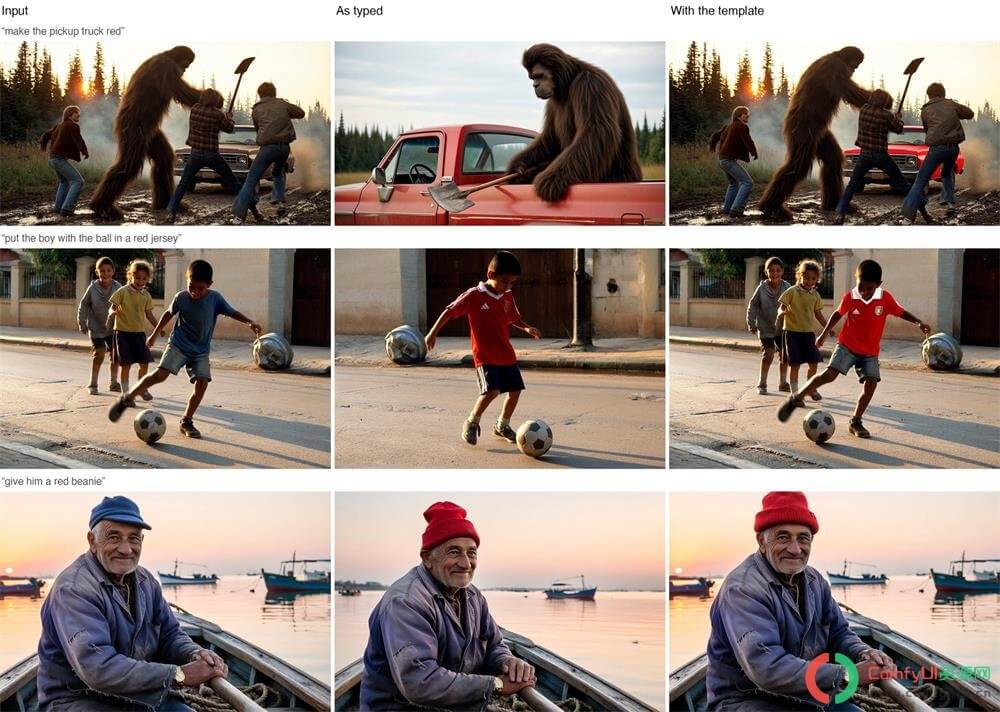
官方模型卡中的编辑输出。
五、总结
能明显感觉到 ComfyUI 在快速收拢 MiniMax H3 生态,从图像到视频、编辑、镜头控制、对口型一整条链路慢慢成型。 后续我会继续跟进 H3 相关工作流、显存调优方案,感兴趣可以关注,不错过后续教程和整合包。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。