


一、Qwen-Image-2.1-Turbo介绍
Qwen-Image-2.1-Turbo 是通义千问团队 2026 年 10 月 9 日发布的官方加速版图像模型,主打 8 步出图,同时把文生图和图像编辑合并到一个模型里,并原生支持透明图和多图参考。
它基于 Qwen-Image-2.1 的 7B 架构,去噪步数从常规几十步压到 8 步,速度提升明显。实测中,生成一张 1K 图片约快 2—4 倍,比如原版约 55 秒的任务,Turbo 约 24 秒;2K 海报从约 217 秒降到约 54 秒。
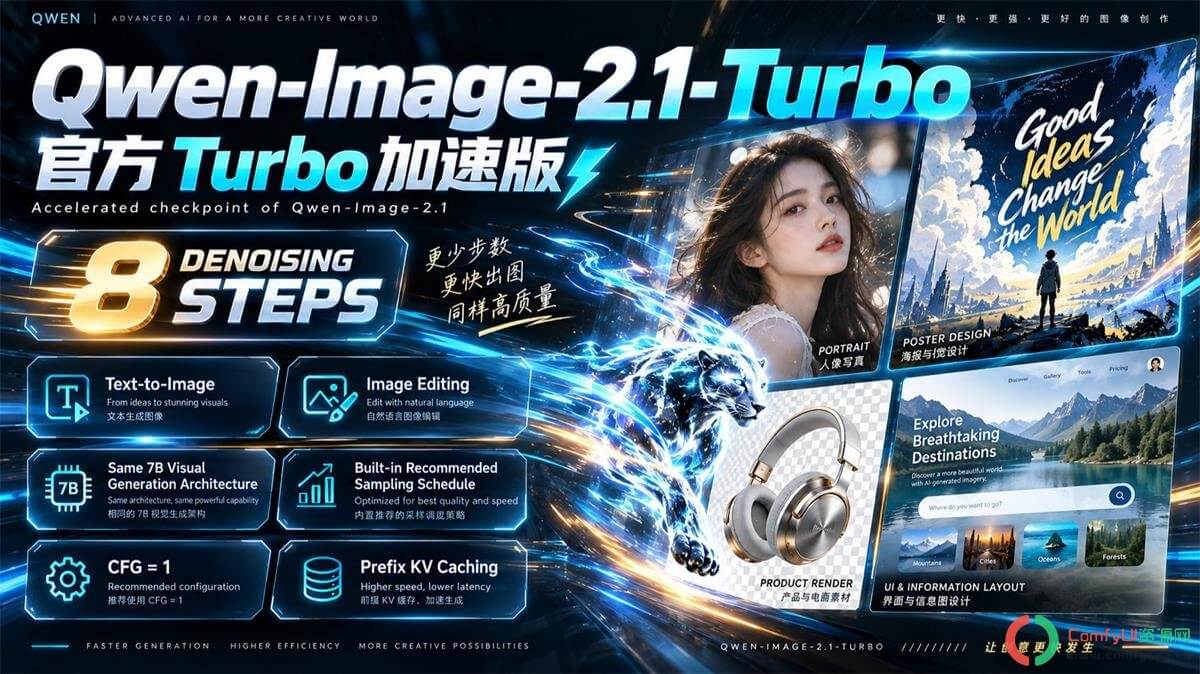
🚀 核心能力
- 生成与编辑一体:文生图、图生图、局部重绘都在同一个模型里完成,不用来回切换模型。
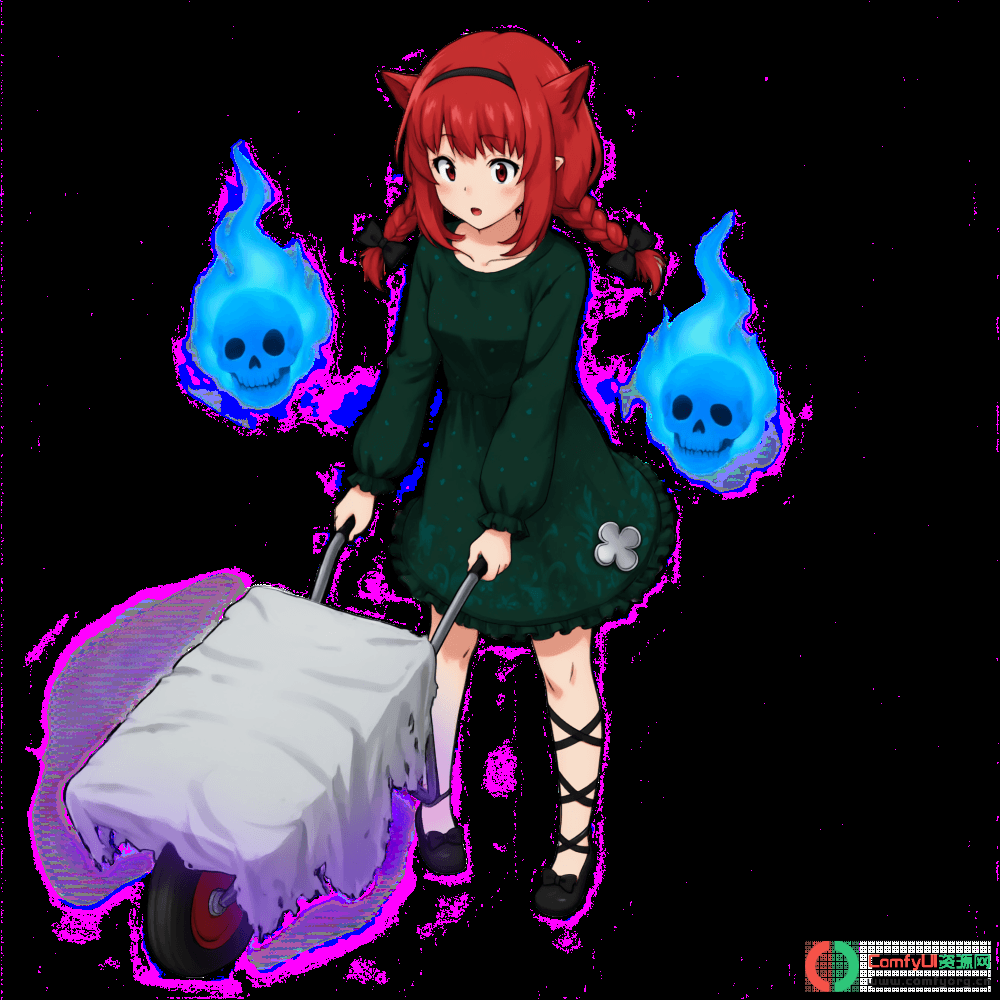
- 原生透明图:直接生成带 Alpha 通道的 PNG,也能从照片里抠出主体,省掉后期抠图。
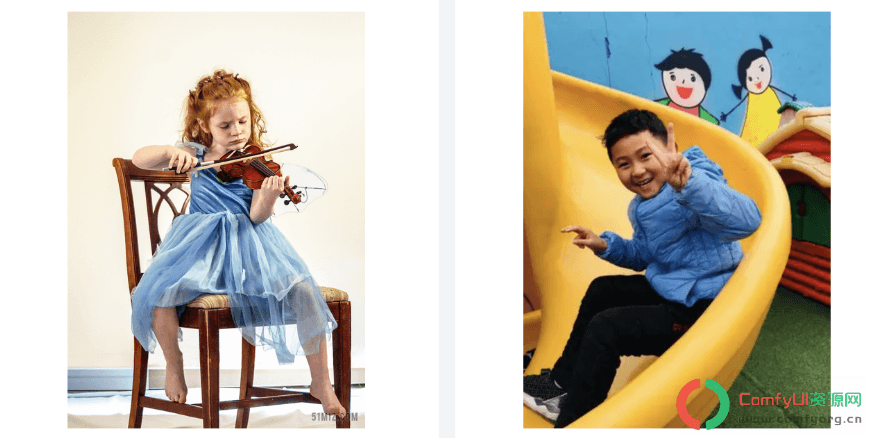
- 多图参考:最多输入 10 张参考图,适合把不同人物、服饰、场景组合到一张画面里。
- 局部精修:支持圈选、涂抹和独立蒙版指定修改区域,改一处不会崩掉整张图。
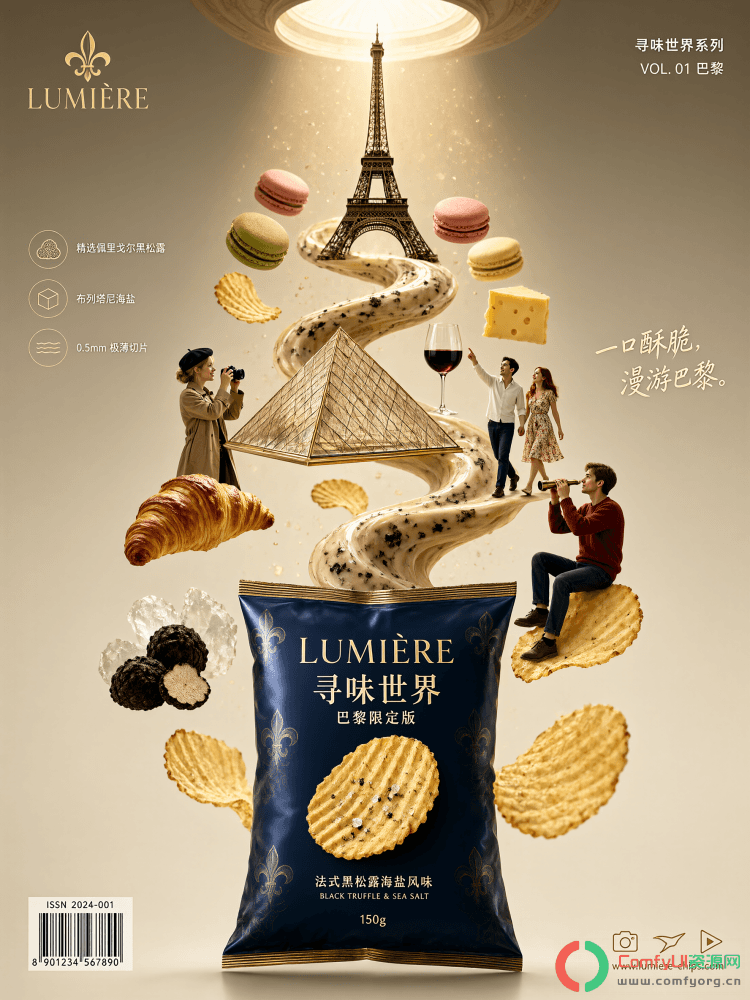
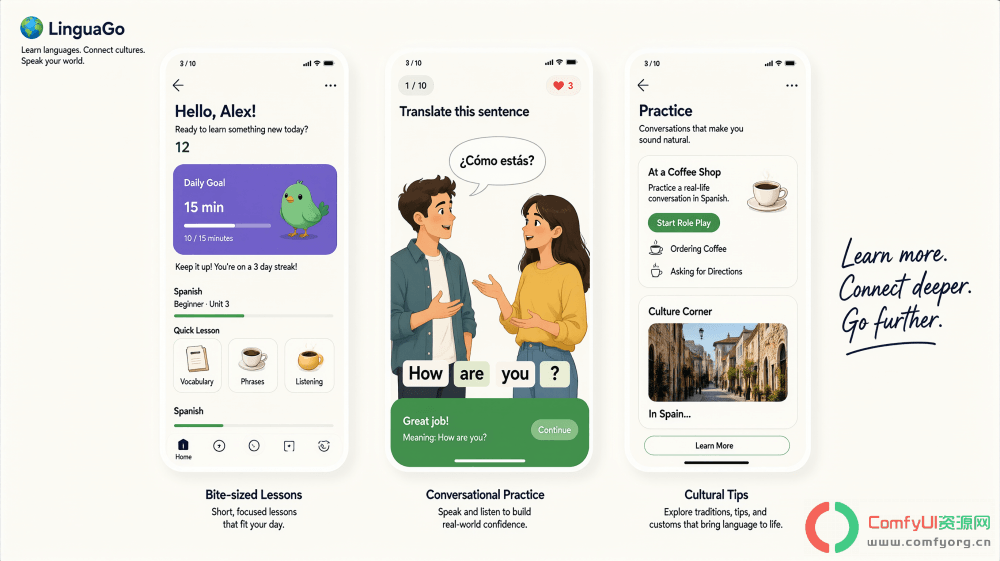
- 文字排版强:海报、信息图这类带大量文字的图,文字渲染和版式保持得比较稳。
二、相关安装
📂 ComfyUI/
├── 📂 models/
│ ├── 📂 diffusion_models/
│ │  └── qwen_image_2.1_turbo_int8_convrot.safetensors (本期新增Turbo版主模型)
│ ├── 📂 unet/
│ │  └── qwen_image_2.1_turbo_Q5_K_M.gguf        (本期新增Turbo版GGUF备用版)
│ ├── 📂 text_encoders/
│ │  └── qwen3vl_8b_int8_convrot.safetensors       (文本编码模型)
│ ├── 📂 loras/
│ │  └── 📂 qwenimage2.1/
│ │   └──VNCCS_QI2_PoseStudioV1.1.safetensors       (自由姿势lora)
│ └── 📂 vae/
│   └── qwen_image_2.1_vae_bf16.safetensors        (vae模型)
└── 📂 custom_nodes/
  └── 📂 ComfyUI-Fisher-Pose             [新增:Fisher Pose编辑器插件]
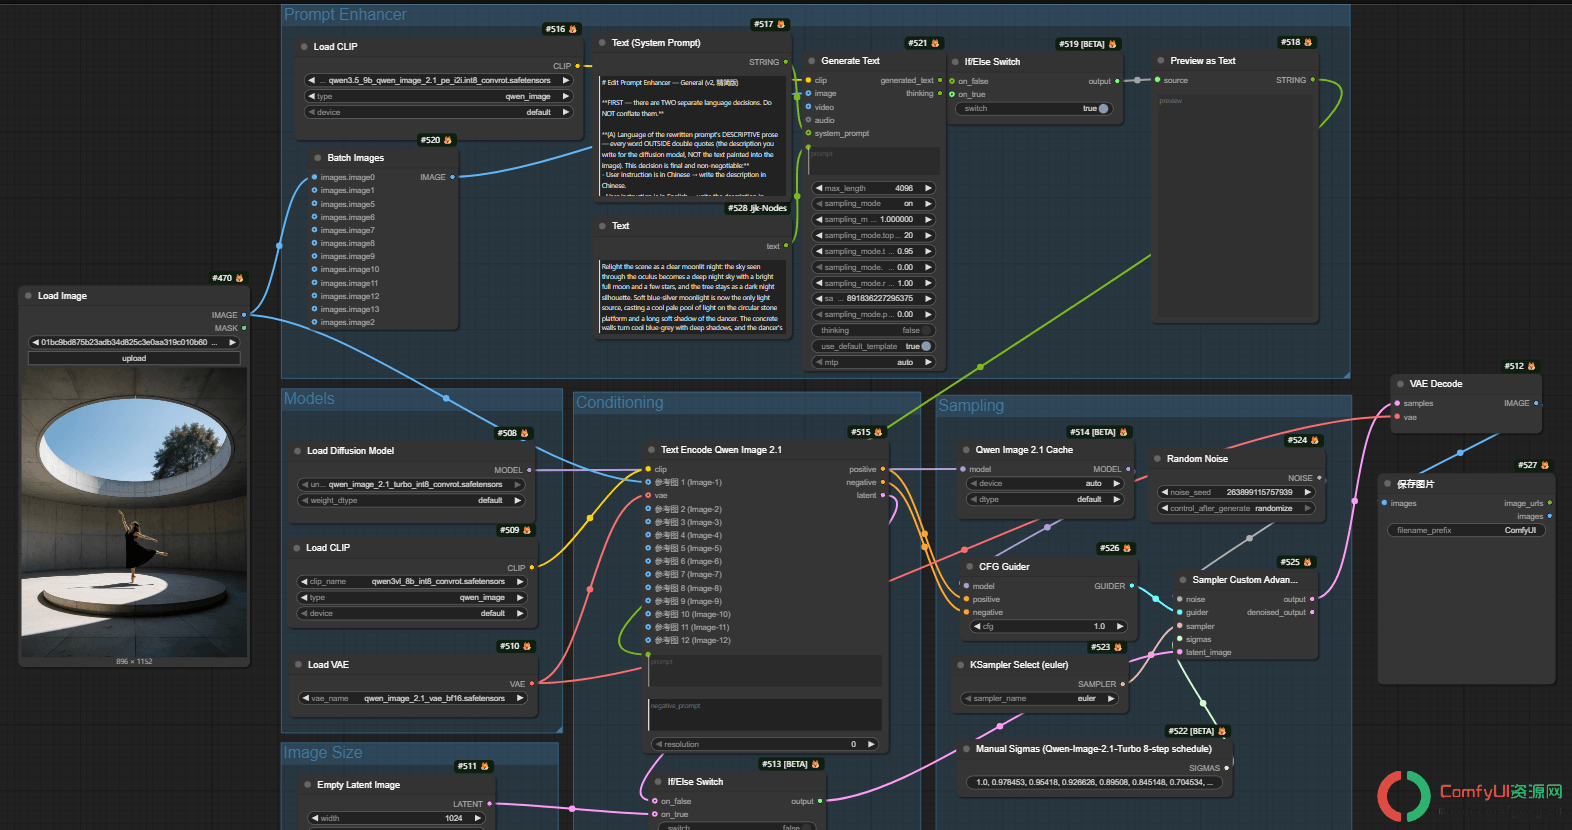
三、工作流
四、展示
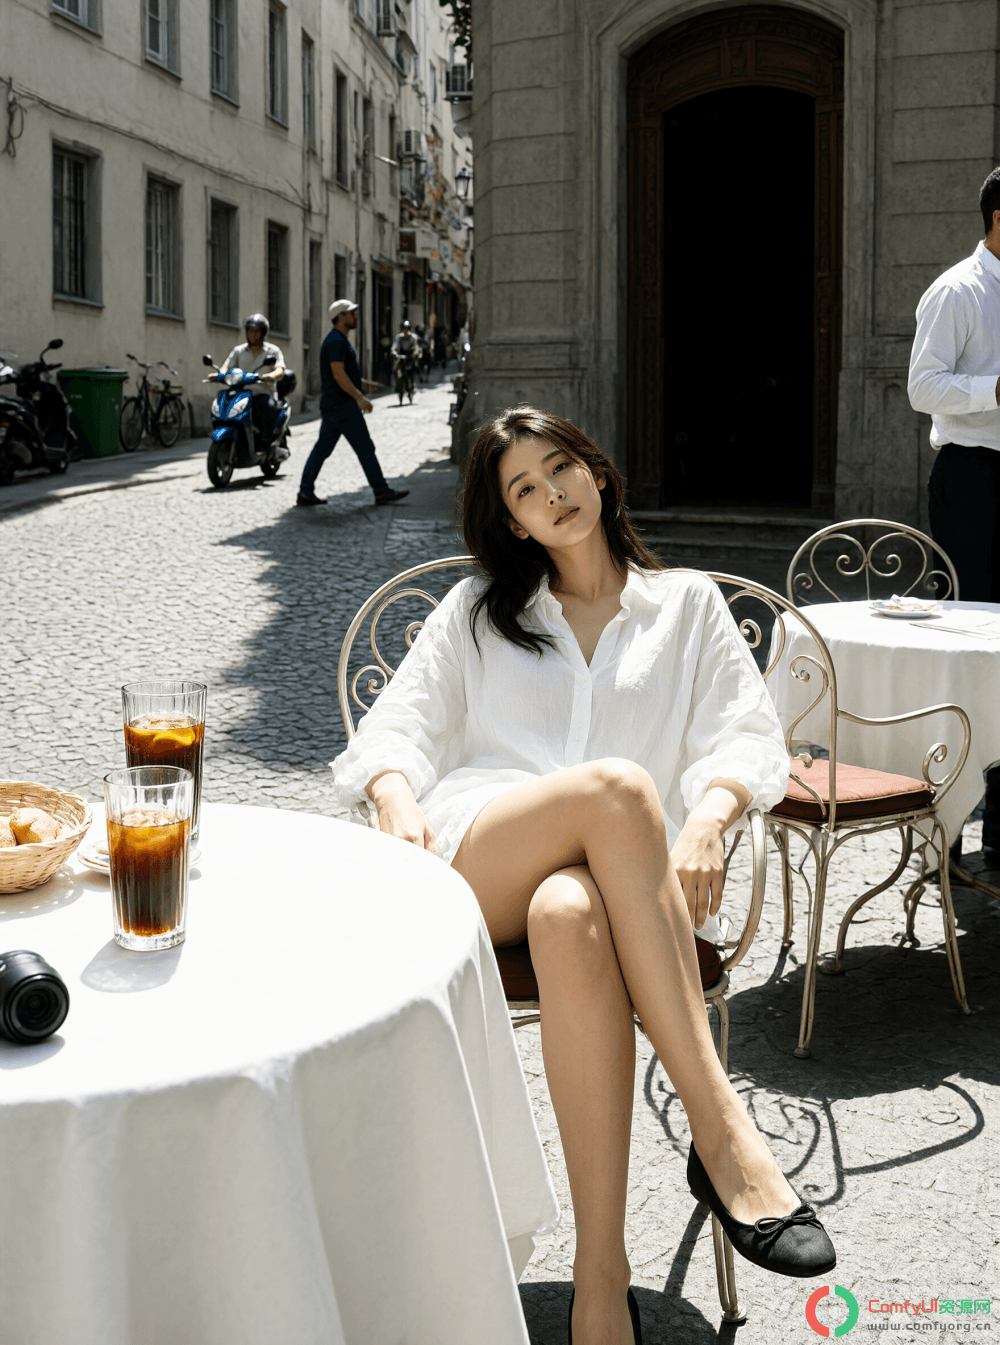
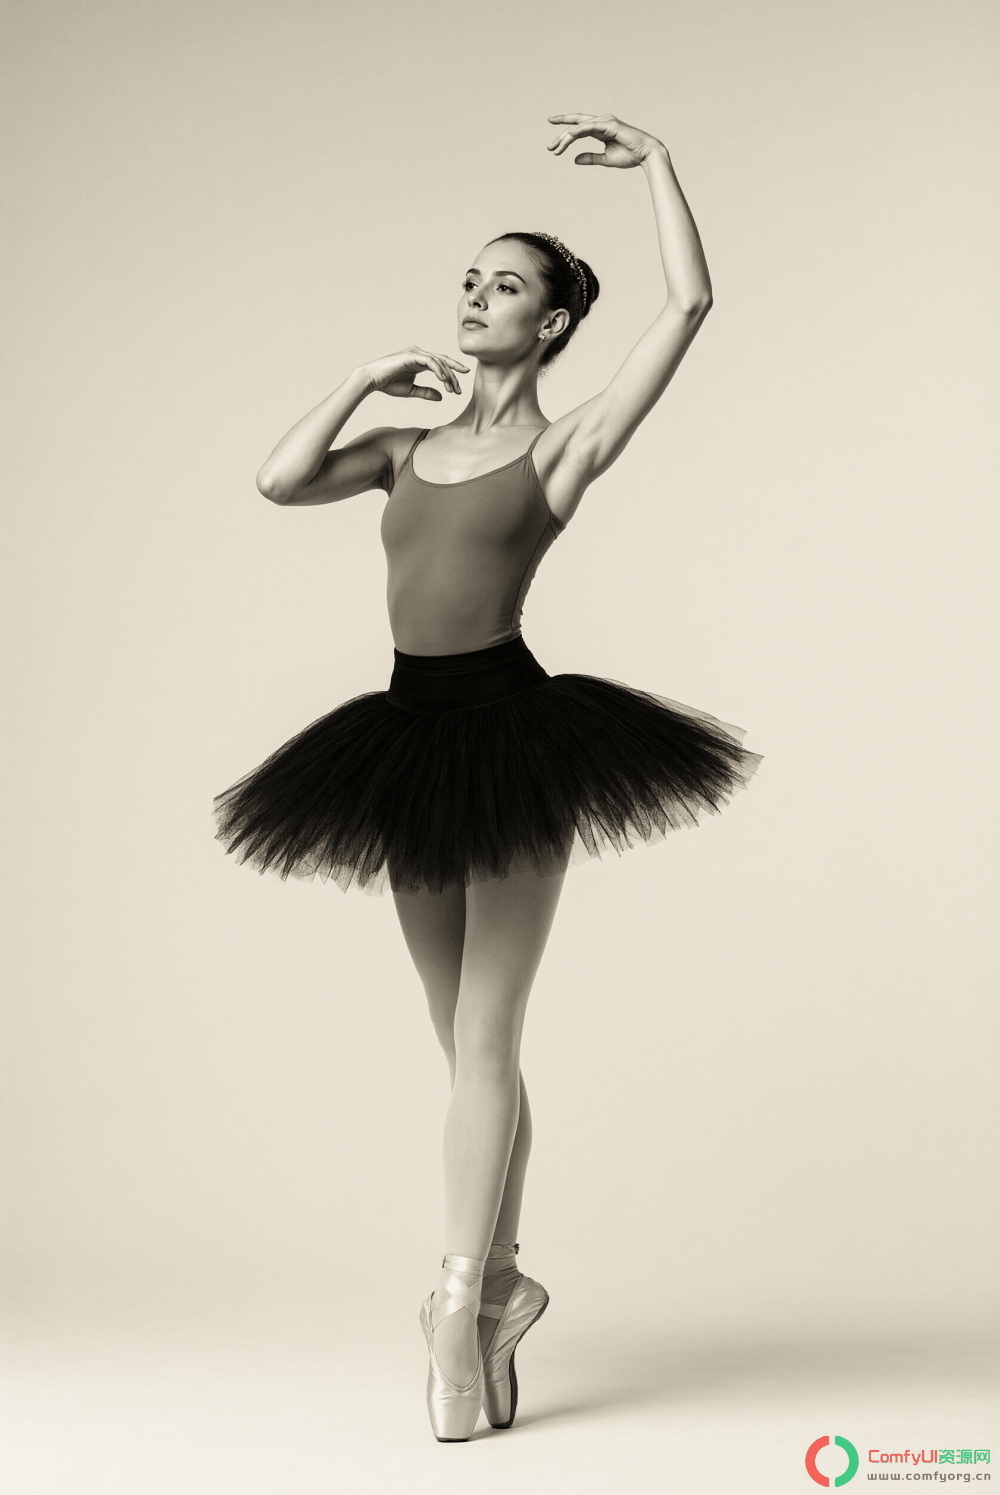
以下是我们 Turbo 展示中来自 8 步输出的示例。每个类别展示一个示例。
| 人像摄影 | 人物姿态与动作 |
 |
 |
| 透明图像生成 | 排版与海报设计 |
 |
 |
UI 与信息布局
多参考合成
| 输入 | 输出 |
 |
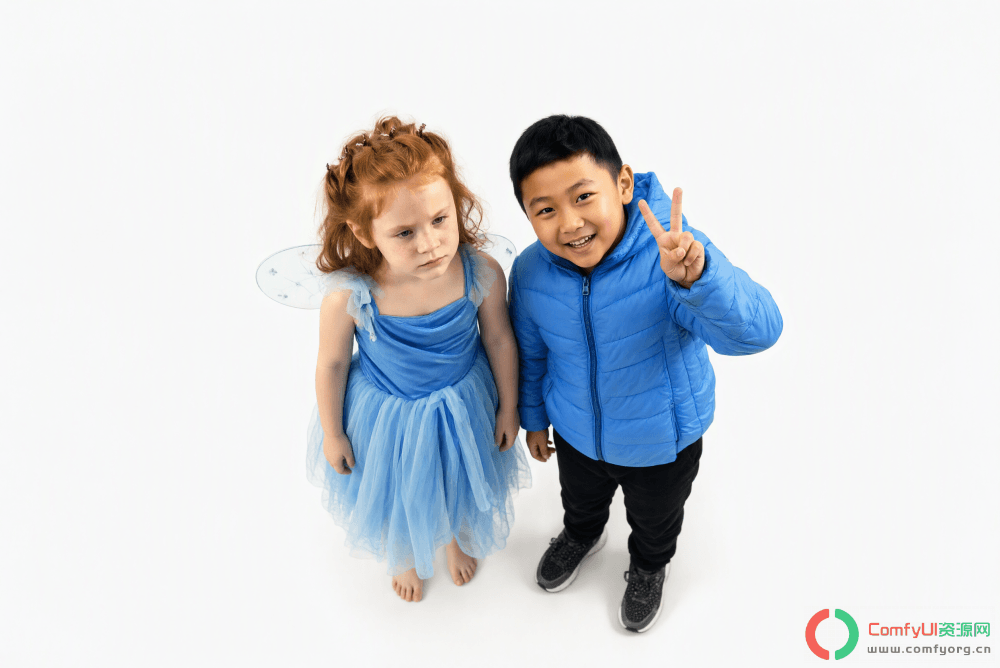 |
四图室内合成:
| 输入 | 输出 |
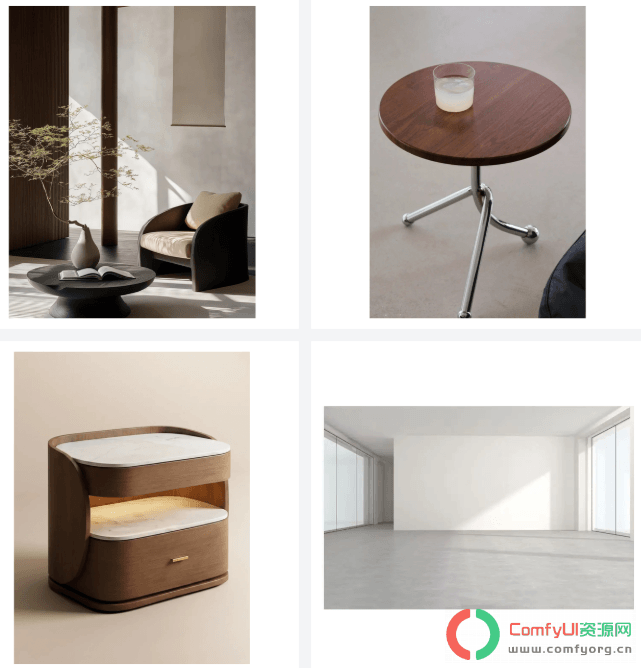 |
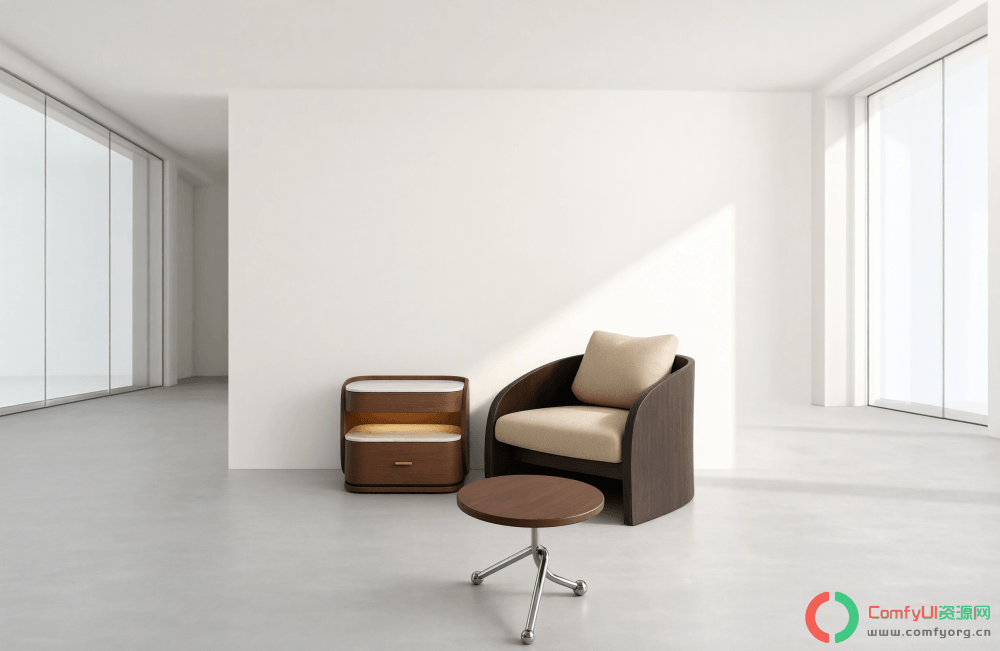 |
五、总结
从行业视角看,这次发布的真正看点是开源阵营对成本曲线的持续攻势:当旗舰闭源模型还在按张计费时,开源社区已经把同等能力的推理成本压到了零边际软件费用的水平。对国内设计、电商与内容产业来说,本地部署一套8步出图的工作流,正在成为中小团队的默认选项。
图像生成的竞争下半场,比拼的不再只是单张画质,而是整套生产关系的成本结构,通义这次又把标杆往前挪了一格。阿里 Qwen 多模态生态面向产业落地的关键一步。 Qwen-image-2.1-Turbo 追求速度 + 开源的产品分层,精准匹配电商、设计两大高需求场景,为开发者提供公有云调用与本地私有化两套方案。短期会加速国内 AI 素材生产工具普及;中长期有助于构建国产图像生成开源生态
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。