


一、MOSS-Image 是什么
MOSS-Image 是 OpenMOSS 团队(复旦大学自然语言处理实验室、上海创智学院和摩斯智能联合组建)在 2026 年 10 月 16 日开源发布的 5B 参数文生图模型,主打文字渲染和布局控制。
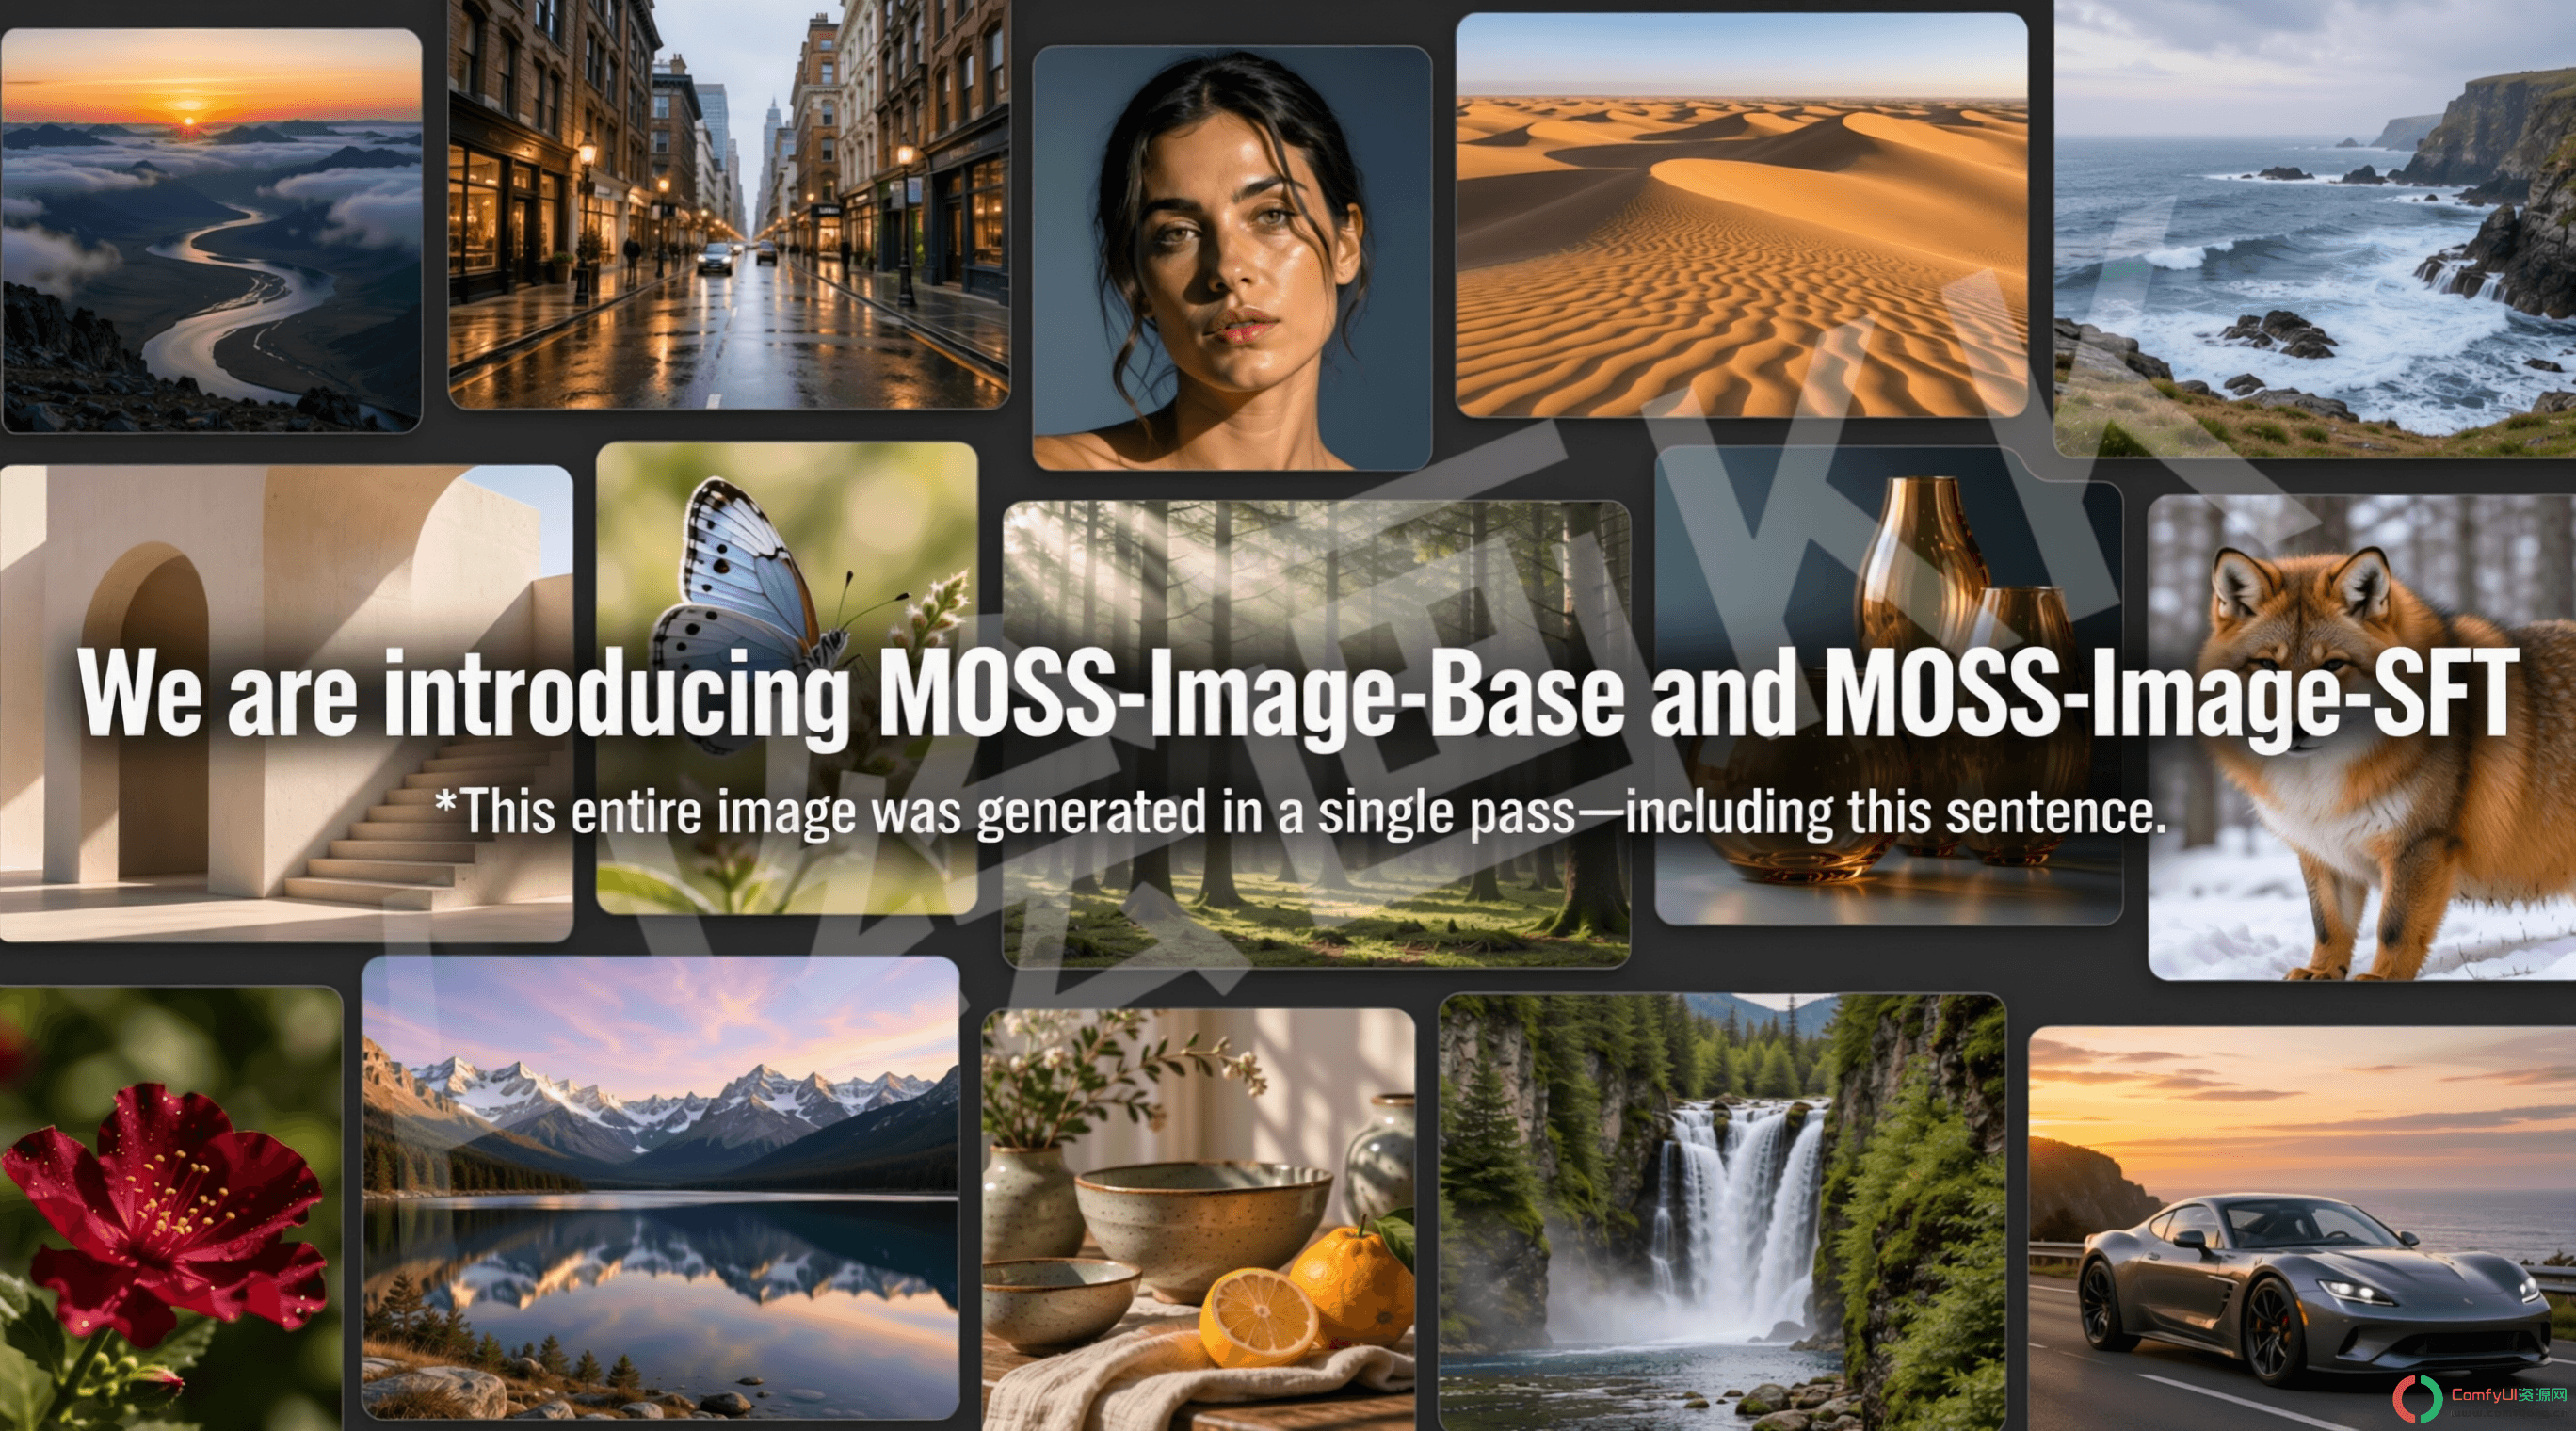
它的核心特点在于:
- 精准文字与排版:支持中英文文字渲染,可以用 JSON 指令控制画面里文字的内容、位置和排版,适合海报、界面图文排版这类需要固定元素布局的场景。
- 灵活的控制方式:除了自然语言提示词,还支持标签序列和 JSON 格式输入,能精细控制画面中各个物体的坐标位置。
- 两种版本:提供 Base 基座模型(适合继续微调)和 SFT 微调版(适合日常直接生成)。
- 生态支持:已支持 ComfyUI,可以直接下载模型权重和工作流在本地运行。
二、相关安装
- 将 ComfyUI 更新至 0.41.3 或更高版本
- 下载 工作流中列出的模型
模型路径:
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 diffusion_models/
│   │      ├── moss_image_sft_int8_convrot.safetensors
│   │      └── moss_image_base_int8_convrot.safetensors
│   ├── 📂 text_encoders/
│   │      └── qwen3.5_9b_w4a8_gptq.safetensors
│   └── 📂 vae/
│          └── flux2-vae_small.safetensors
提示技巧
- 描述最终图像,而不是提出请求。 该模型是在描述文本上训练的,因此请写出画面看起来是什么样,而不是写“帮我做一张海报”这样的指令。上采样器遵循同一规则,所以简短提示词仍然有效。
- 关闭上采样器以控制措辞。 在子图节点上将
enable_prompt_upsampler设为false,提示词就会原样传给模型。两种设置都会在Preview Any中显示结果,因此可以对比。 - 自行控制换行。 自动换行可能不会落在你期望的位置。当换行位置很重要时,在要渲染的文本中放入实际换行符或
\n。 - 位置很重要时,使用布局工作流。 框会为每个元素和每个文本块向模型提供明确的位置,这比用文字描述位置更可靠。
- 将画布保持在推荐范围内。
ResolutionSelector选择宽高比和像素数(默认 1 MP)。MOSS-Image 针对 1 MP 至 2 MP 训练,并可在约 0.25 MP 至 4 MP 的范围内外推;宽度和高度必须是 16 的倍数。 - 从模板设置开始,然后为官方效果放慢速度。 模板使用
er_sde采样器、以 CFG 2.5 运行 25 步,以求速度。官方设置是 CFG 3、50 步,因此如果结果效果不足,可以尝试这些设置。 - 保持负面提示词简短。 模板默认附带
nsfw, worst quality, bad anatomy, watermark, jpeg artifact。 - 跳过层引导默认开启,位于第 22 层。 子图节点上有一个
SLG开关,引导使用官方的第 22 层。关闭它可能看起来更真实,但可能丢失细节;其他层只能在子图内部调整。 - 基础模型用于微调。 在 MOSS-Image 上训练 LoRA 时,请冻结文本编码器。
三、工作流
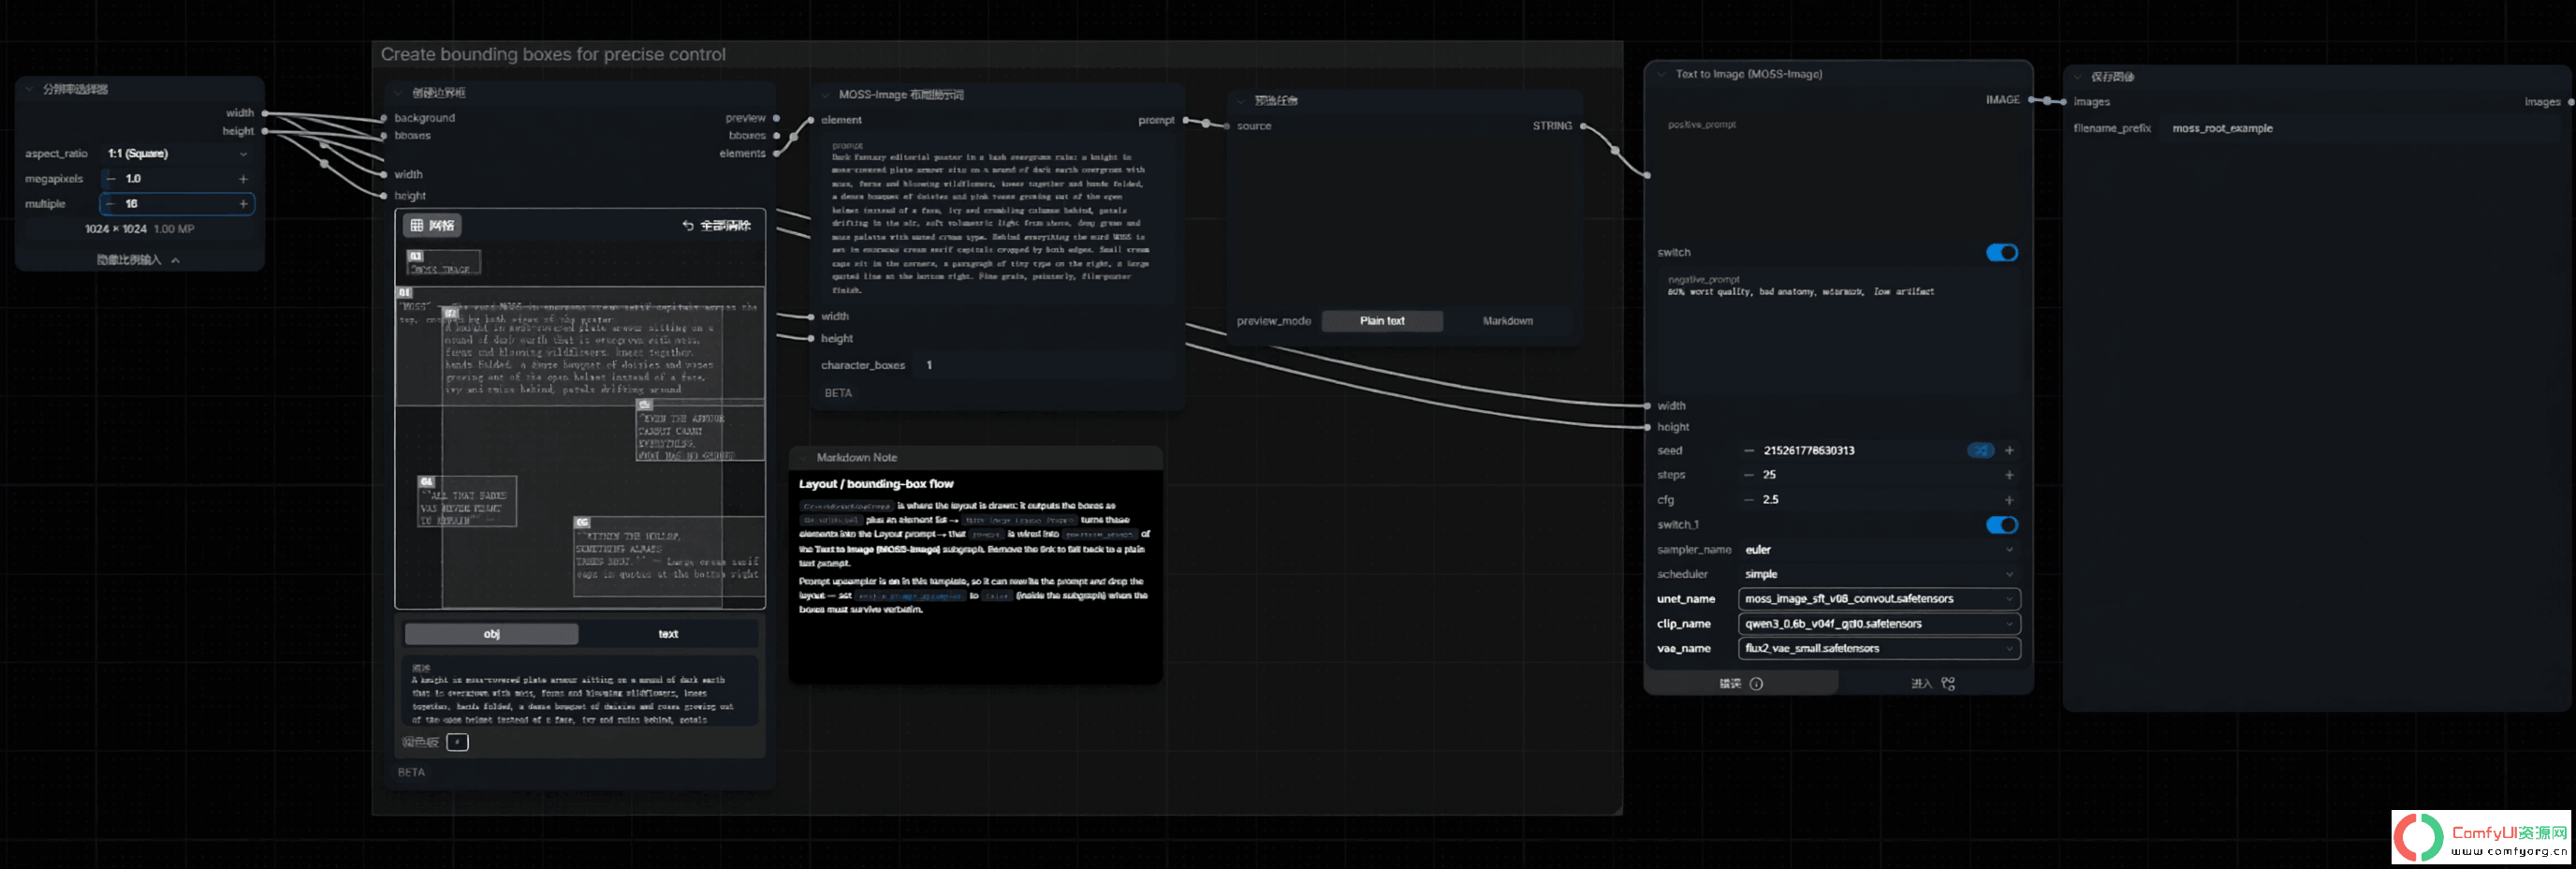
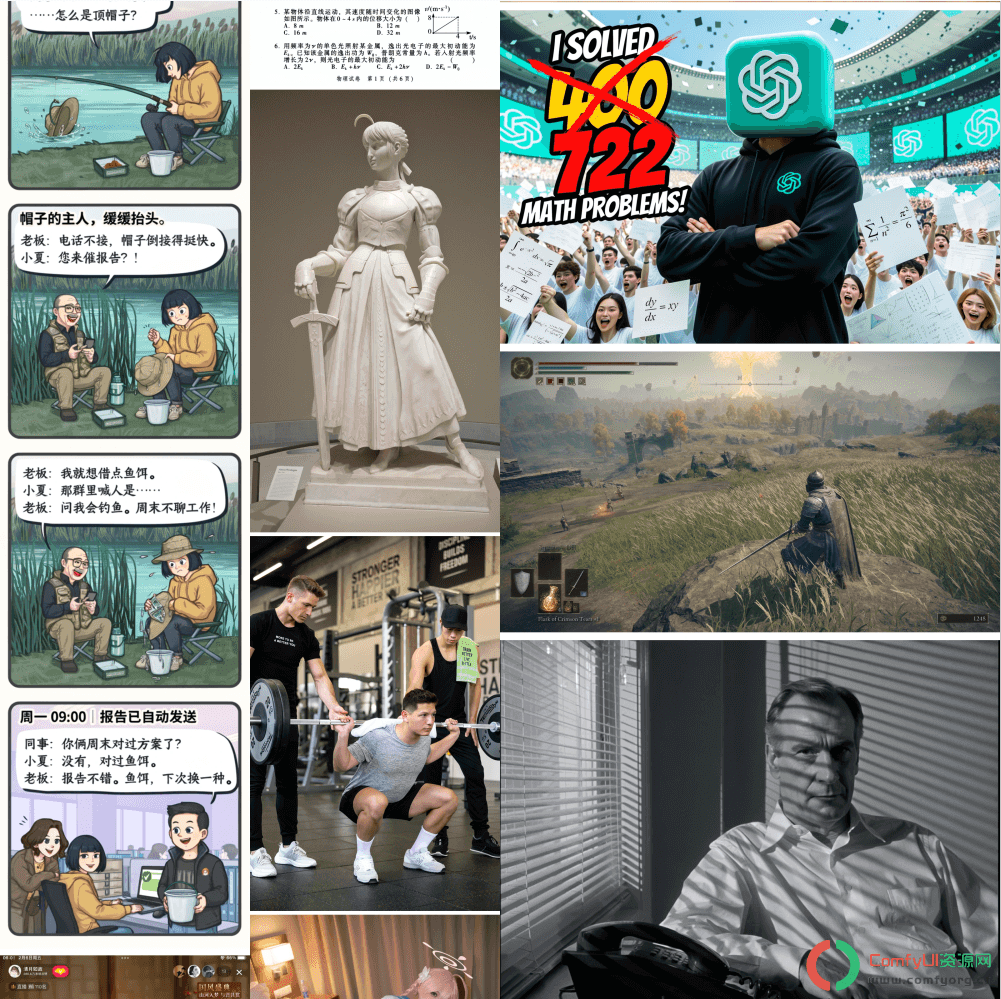
四、生图示例
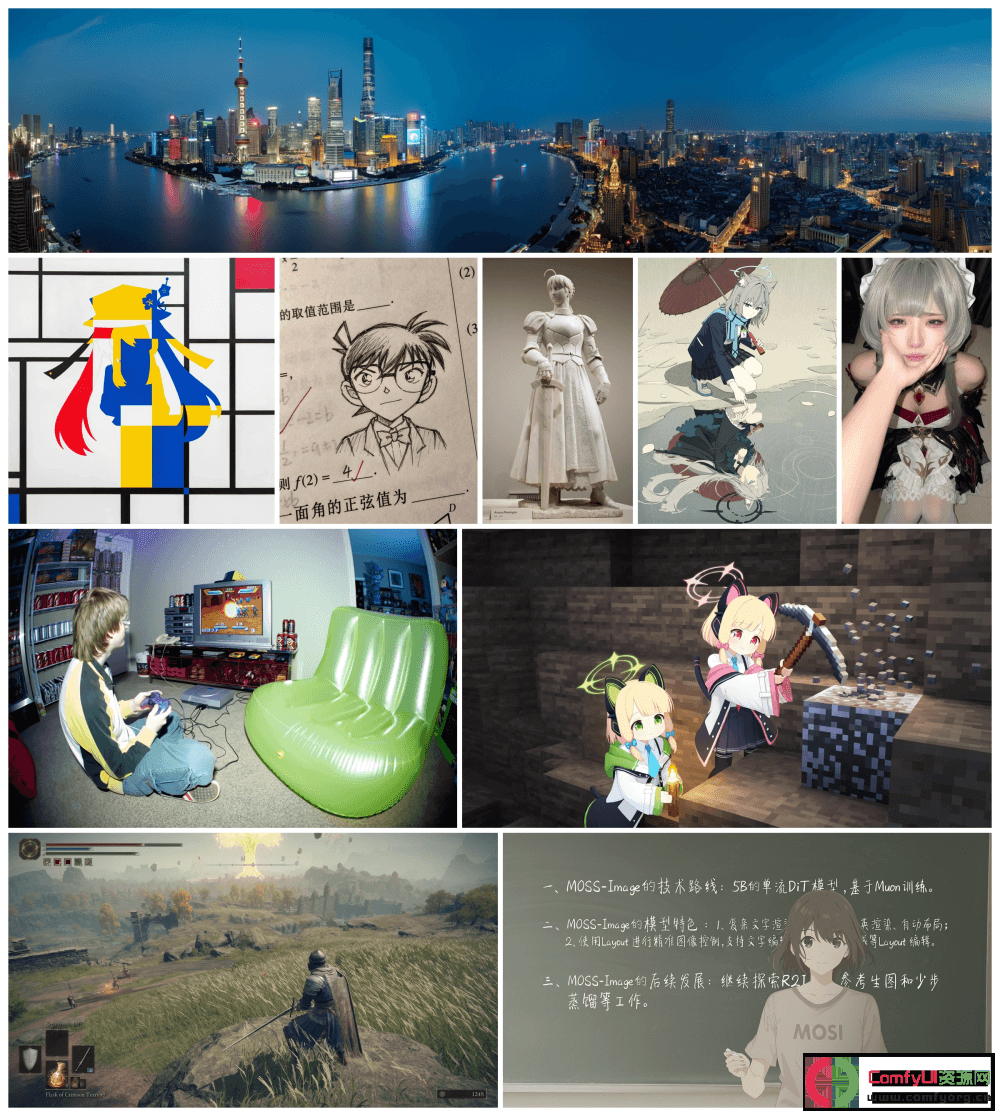
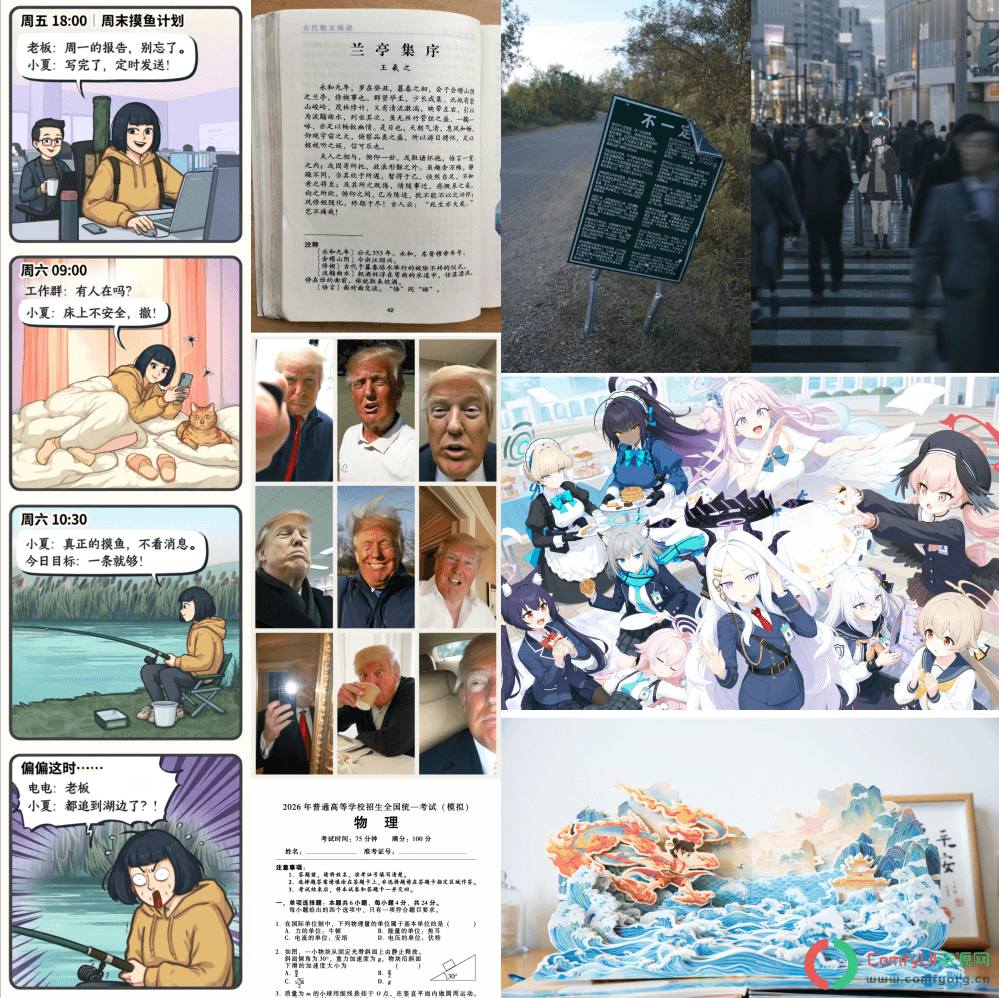
四、总结
MOSS-Image的意义在于它把“精准文字渲染”和“布局控制”这两项长期被视为图像生成短板的难点,做成了开源模型的核心能力,并迅速接入了主流工具链,这对整个AI绘画生态的后续发展方向有直接影响。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。