


一、FLUX 3介绍
FLUX 3 是德国 Black Forest Labs(黑森林实验室)2026年7月发布的多模态基础模型,把图像、视频、音频和动作预测统一到了一个架构里,不再只是画图工具。可在 ComfyUI 里直接运行,既能按提示词生成图像,也能用多张参考图做编辑。它借鉴了家族在图像、视频和音频模型间共享的训练成果,保留了大尺寸 FLUX 3 Image 的控制特性,包括边界框。
简单说,它和之前 FLUX 系列最大的区别是:FLUX.1 解决“怎么把图画好”,FLUX.2 解决“怎么把生成塞进创作工作流”,而 FLUX.3 想做的是让模型理解“世界是怎么运转的”。模型提供两个版本:
- Base:未经蒸馏的完整检查点,适合微调、继续训练和研究。
- Distilled:延迟更低的 turbo 版本,生成速度大幅提升。
模型亮点
- 原生 4K:直接按 4K 分辨率生成
- 提示词上采样:由独立模型进行提示词扩写
- 5.6B 参数:在消费级显卡上就能使用。
- 多参考生成与编辑:输入多张参考图,人物和主体经过多轮编辑、反复输入后依然清晰可辨。
- 边界框:使用区域标记,实现精准编辑
- 文字渲染与编辑:文字生成或精准编辑图像中文本
- 基于参考图的风格迁移:生成符合参考图风格的新图像
二、相关下载
1. 把 ComfyUI 更新到最新版本。
2.模型目录
📂 ComfyUI/
└── 📂 models/
  ├── 📂 Diffusion_models/
  │  ├── flux3_image_klein_bf16.safetensors
  │  ├── flux3_image_klein_int8_convrot.safetensors
  │  ├── flux3_image_klein_nvfp4.safetensors
  │  ├── flux3_image_klein_sd_bf16.safetensors
  │  ├── flux3_image_klein_sd_int8_convrot.safetensors
  │  └── flux3_image_klein_sd_nvfp4.safetensors
  ├── 📂 text_encoders/
  │  ├── qwen3.5_9b_flux3_prompt_upsampler_int8_convrot.safetensors
  │  ├── qwen3vl_4b_bf16.safetensors
  │  └── qwen3vl_4b_int8_convrot.safetensors
  └── 📂 vae/
    └── flux2-vae.safetensors
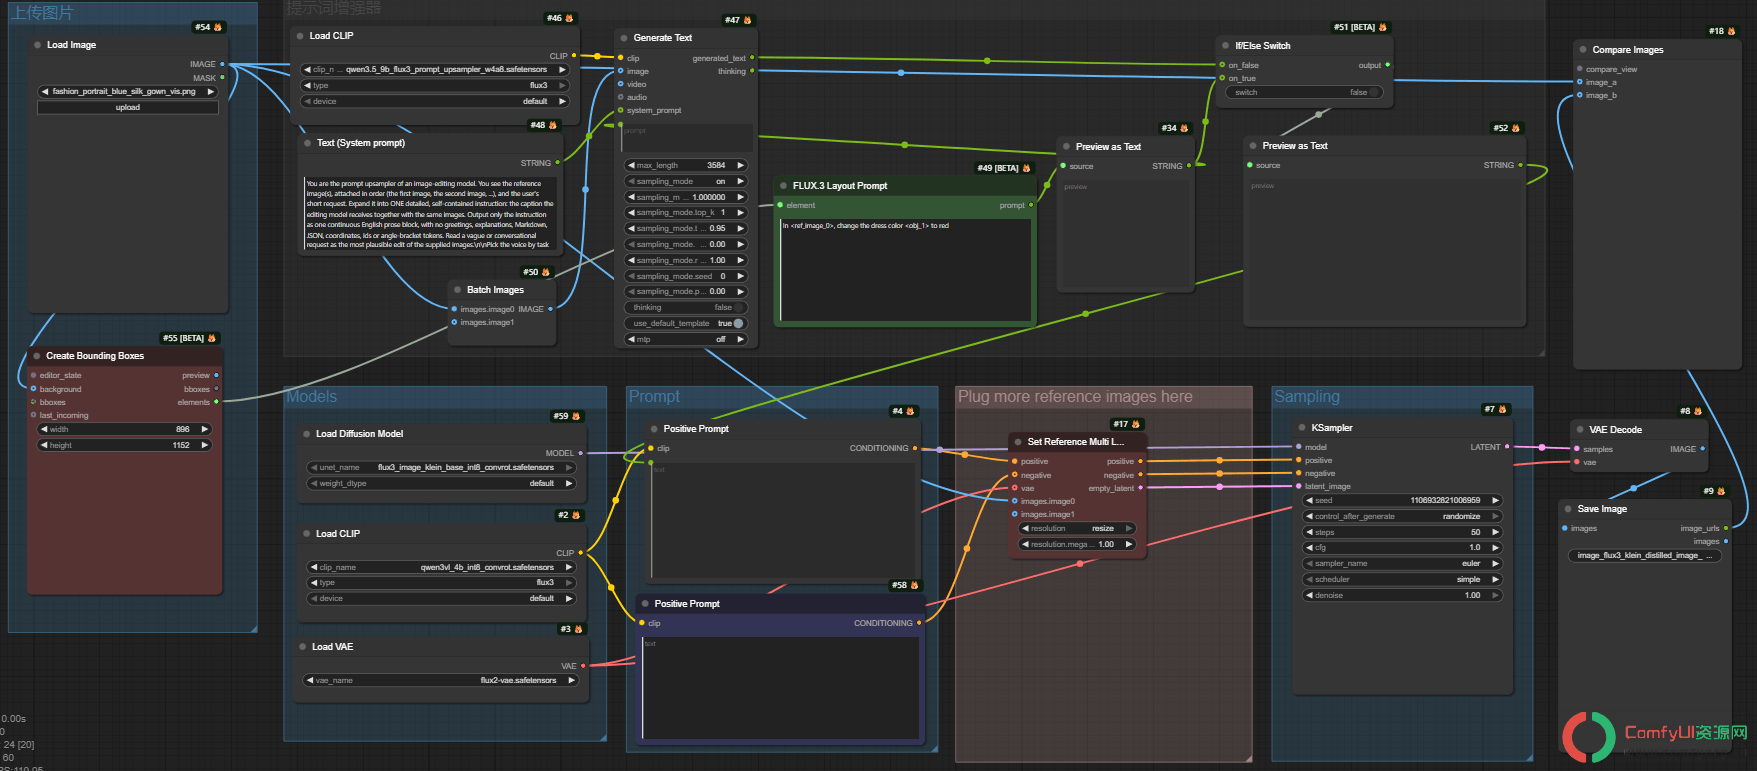
三、工作流
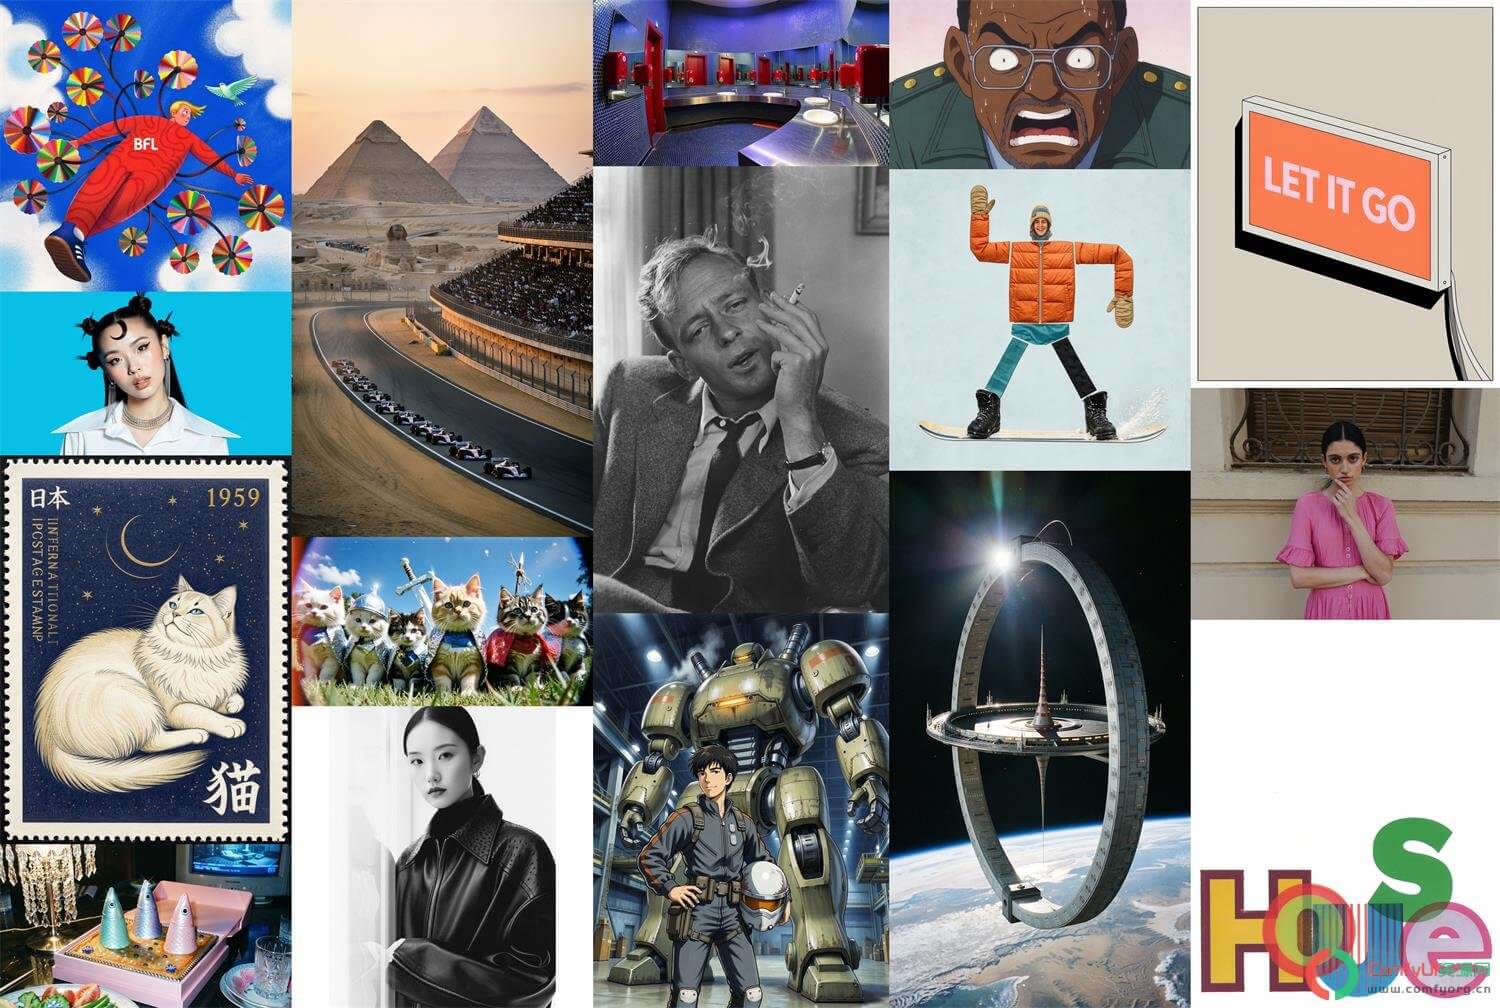
四、生图示例
五、总结
FLUX 3 Image 的发布,不仅是 Black Forest Labs 在多模态领域的一次秀肌肉,更是 AI 图像生成赛道走向成熟的标志。它证明了,AI 绘画的终局不是让机器取代人类的随机灵感,而是让机器成为人类意志的精准延伸。当“对每个像素的控制”成为现实,属于专业创作者的 AI 视觉工业化时代,才刚刚拉开帷幕。从 Stable Diffusion 到 FLUX.1 再到 FLUX 3,Robin Rombach 的路线图始终清晰:从静态图像到动态视频,从生成内容到理解世界,从数字创作到物理操控。FLUX 3 是这条路线上第一个真正意义上的多模态里程碑。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。