


一、Sa2VA模型是什么
Sa2VA 是首个统一的图像和视频密集型语言理解模型。与现有多模态大型语言模型通常局限于特定模态和任务不同,Sa2VA 支持广泛的图像和视频任务,包括指称分割和对话,且只需极少的单次指令调优。Sa2VA 模型通过结合基础视频分割模型 SAM-2 和高级视觉语言模型 LLaVA,将文本、图像和视频统一到共享的 LLM 标记空间中。这种架构设计使得 Sa2VA 能够在最少指令微调的情况下,执行多种任务,包括图像对话、视频对话、图像指称分割、视频指称分割和基于单次指令调整的字幕生成。
Sa2VA,这是第一个用于对图像和视频进行密集基础理解的统一模型。基于 Qwen2-VL 和 InternVL2/2.5 构建的 Sa2VA 系列,在问答基准上实现了与 Qwen2-VL 和 InternVL2.5 相当的性能。使用 LLM,Sa2VA 生成指令标记,指导 SAM-2 生成精确的掩码,从而实现对静态和动态视觉内容的扎实、多模态理解。
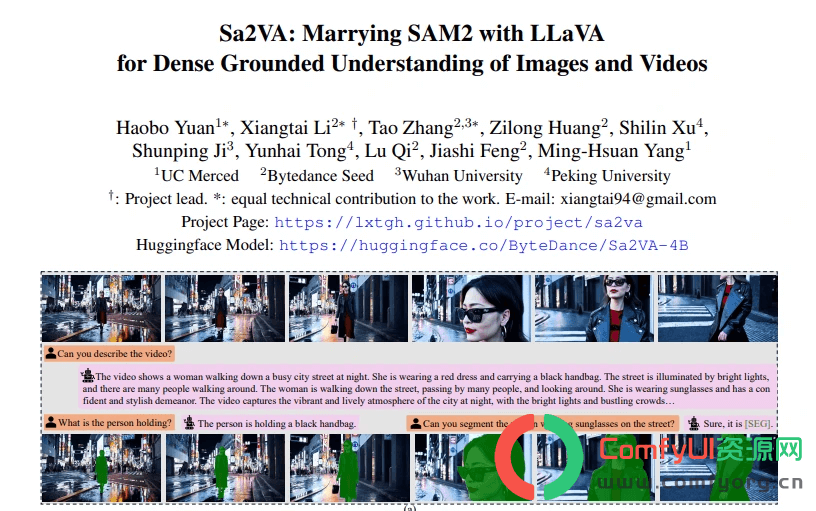
项目链接:https://lxtgh.github.io/project/sa2va/
论文链接:https://arxiv.org/pdf/2501.04001
HuggingFace: https://huggingface.co/ByteDance/Sa2VA-4B
- 🎥 Sa2VA 是字节跳动推出的新模型,结合了 LLaVA 与 SAM-2的优点,实现了视频内容的理解与分割。
- 🔗 该模型通过 “暗号” 系统有效连接语言理解与图像分割,提升了交互能力。
- 🌍 Sa2VA 的开放资源为开发者提供了丰富的工具,促进了多模态 AI 技术的研究
二、相关安装
目前comfyui有配套的插件支持,不过暂时就只支持图片,视频的我结合以前那个Sec来一起使用。
插件地址:https://github.com/adambarbato/comfyui-Sa2VA
这个插件要求(本地要安装的同学记得先备份python包)
- Python 3.8+
- PyTorch 2.0+
- transformers >= 4.57.0 (关键!)
- CUDA 11.8+ (用于 GPU 加速)
- 建议 8GB+ VRAM 用于 4B 模型
- 20GB+ VRAM 用于全精度
较旧版本的 transformers 会导致"没有名为'transformers.models.qwen3_vl'的模块"的错误。
模型地址:
https://huggingface.co/ByteDance/models
支持的模型
ByteDance/Sa2VA-Qwen3-VL-4B(推荐 - 4B 参数)ByteDance/Sa2VA-Qwen2_5-VL-7B(7B 参数)ByteDance/Sa2VA-InternVL3-8B(8B 参数)ByteDance/Sa2VA-InternVL3-14B(14B 参数)ByteDance/Sa2VA-Qwen2_5-VL-3B(3B 参数)-
ByteDance/Sa2VA-InternVL3-2B(2B 参数)
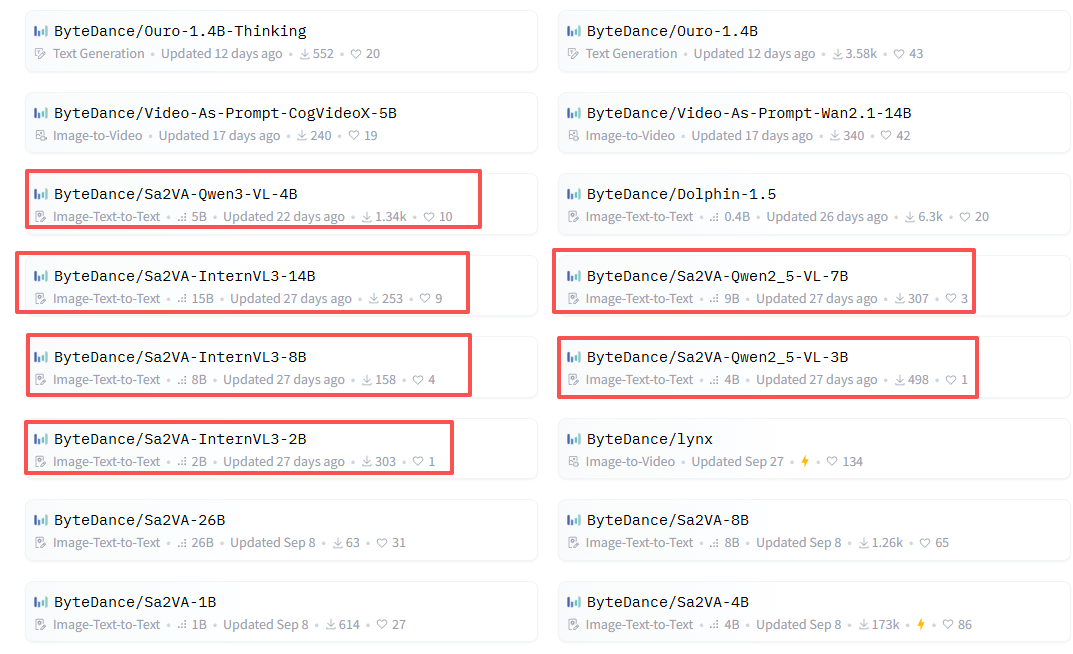 模型存放路径:
custom_nodes/comfyui-sa2va/.cache/huggingface/hub/models--ByteDance--Sa2VA-Qwen3-VL-4B
三、工作流
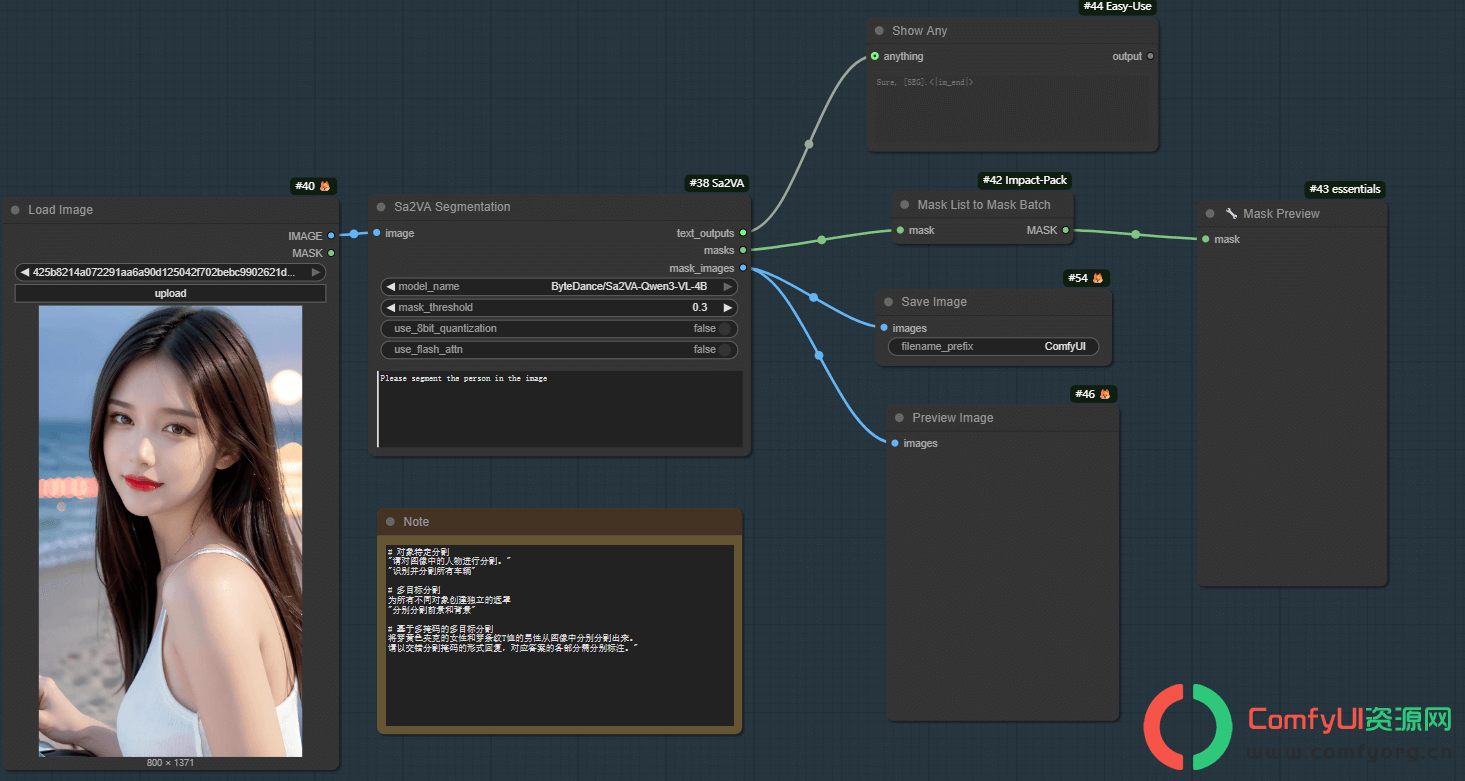
图像示例:
视频示例:
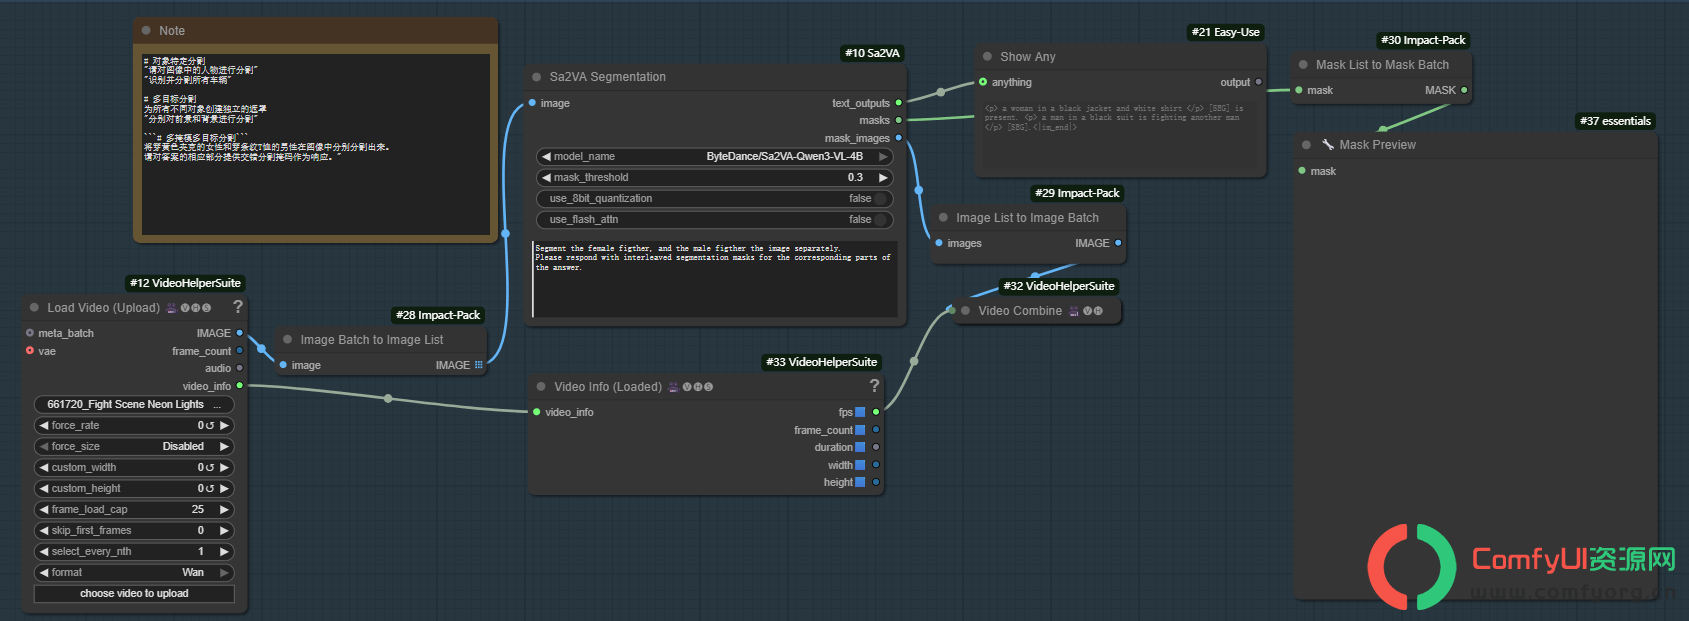
工作流使用详解:
它在短提示方面优于 Grounding DINO:
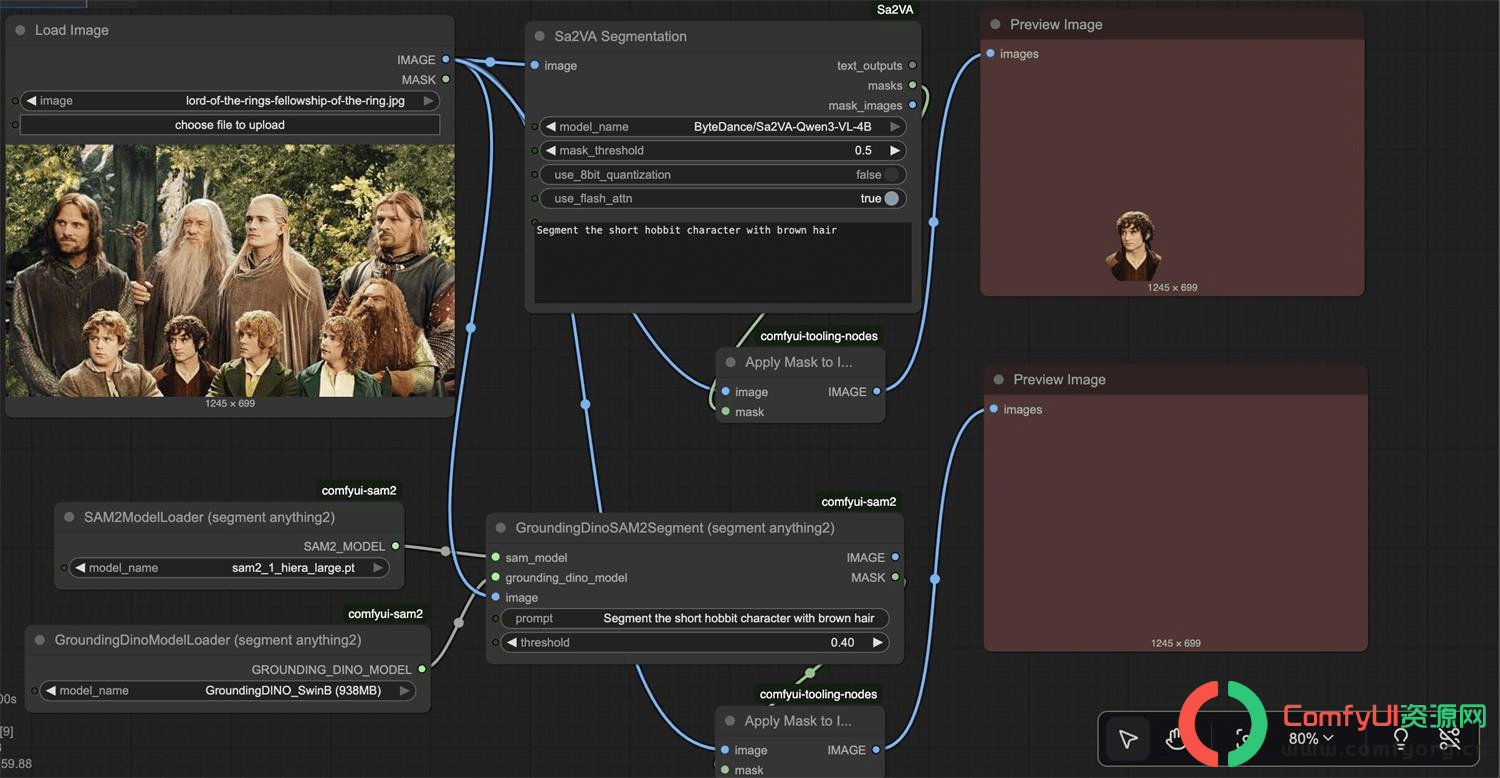
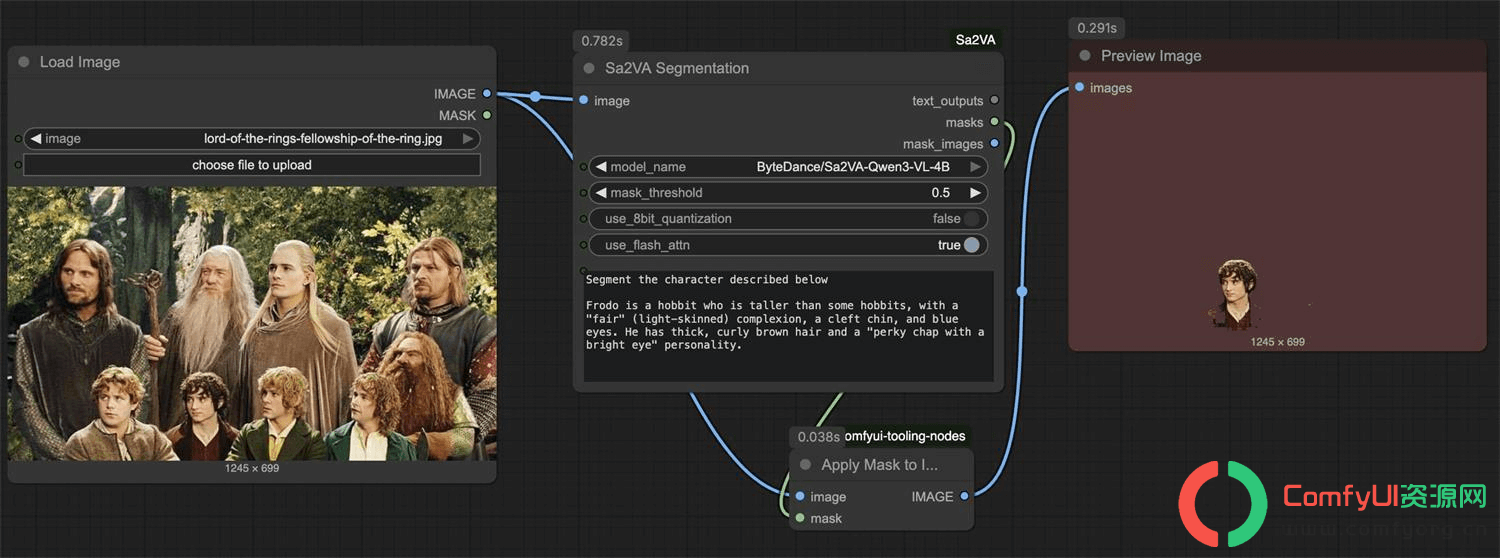
并且能够很好地遵循较长的指令,例如描述一个角色的一般特征,而不是图像中他们的位置或特征。这使得它非常适合自动生成或代理分割提示:
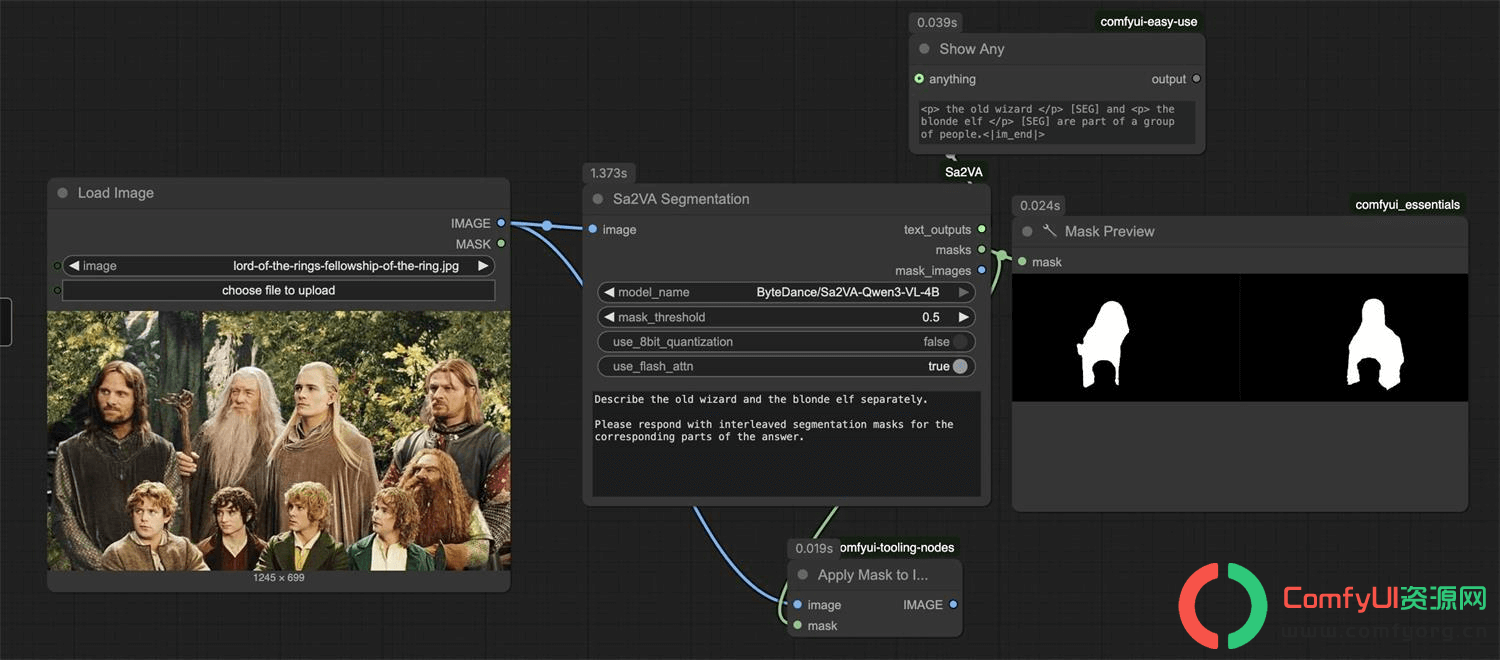
它还可以同时分割多个掩码,但提示需要精确:
常见问题
"没有名为 'transformers.models.qwen3_vl' 的模块"
pip install transformers>=4.57.0 --upgrade
这是最常见的问题——你的 transformers 版本太旧了。没有名为 'qwen_vl_utils' 的模块
pip install qwen_vl_utils
这个依赖项是 Sa2VA 模型工具所必需的。'NoneType' 对象不可索引
模型加载失败(请查看控制台错误信息)
通常由过时的 transformers 版本引起
验证网络连接以进行模型下载CUDA 内存不足
使用 8 位量化
使用较小的模型变体(2B 或 3B 参数)
减少批处理大小模型加载错误
检查初始下载的网络连接
确保足够的磁盘空间(每个模型 20GB+)
验证 CUDA 兼容性
尝试使用 torch.cuda.empty_cache() 清理 VRAM分割质量差
使用更具体的提示:"请分割人物"
尝试不同的模型变体
调整遮罩转换器的阈值
使用更高分辨率的图片
总结:
Sa2VA代表了人工智能向通用智能迈出的重要一步。它不仅仅是一个技术产品,更是一种新的人机交互方式的体现。通过将精确的像素级理解与自然的语言交流结合起来,Sa2VA让AI系统变得更加直观和易用。虽然现在还有一些技术挑战需要克服,但我们有理由相信,随着技术的不断进步,Sa2VA这样的多模态AI系统将在不久的将来成为我们日常生活中不可或缺的助手。对于关注AI发展的读者来说,Sa2VA的成功经验和未来发展方向都值得持续关注。