


一、Qwen-Image 2.1介绍
本周日,阿里千问正式开源图片生成模型 Qwen-Image-2.1,以小模型的体量解决了大部分生产力难题:它实现了文生图与图像编辑一体化,原生支持透明图生成,最高可以接收 10 张参考图,还进一步强化了局部编辑、人像与商品保真。
Qwen-Image-2.1,千问图像系列当前兼顾生成效果、推理效率与使用成本的开源图像模型。Qwen-Image-2.1 将文生图与图像编辑整合在同一模型中,视觉生成部分仅有 7B 参数,并原生支持透明图像的生成与编辑。
本次更新的主要特色包括四个方面:
- 小模强效,极致价比:轻量的模型结构与推理优化,在生成质量和计算成本之间取得平衡。
- 原生透明,创改一体:根据提示词生成普通图像或透明图像,并支持透明图层编辑与抠图。
- 全能编辑,多局保全:支持最多 10 张参考图,增强局部编辑、人像与商品保真,并覆盖多种编辑任务。
- 真实质感,字雅人美:提升文字排版、人物光影与细节表现,让生成结果更具美感。
二、相关安装
更新Comfyui内核开发版到最新版
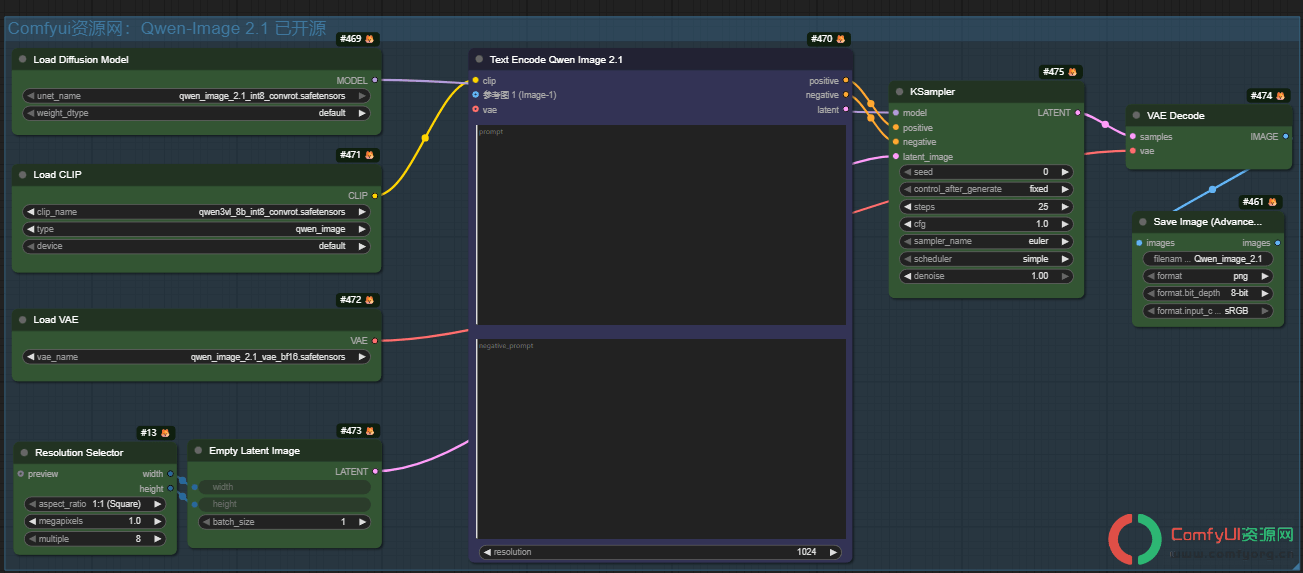
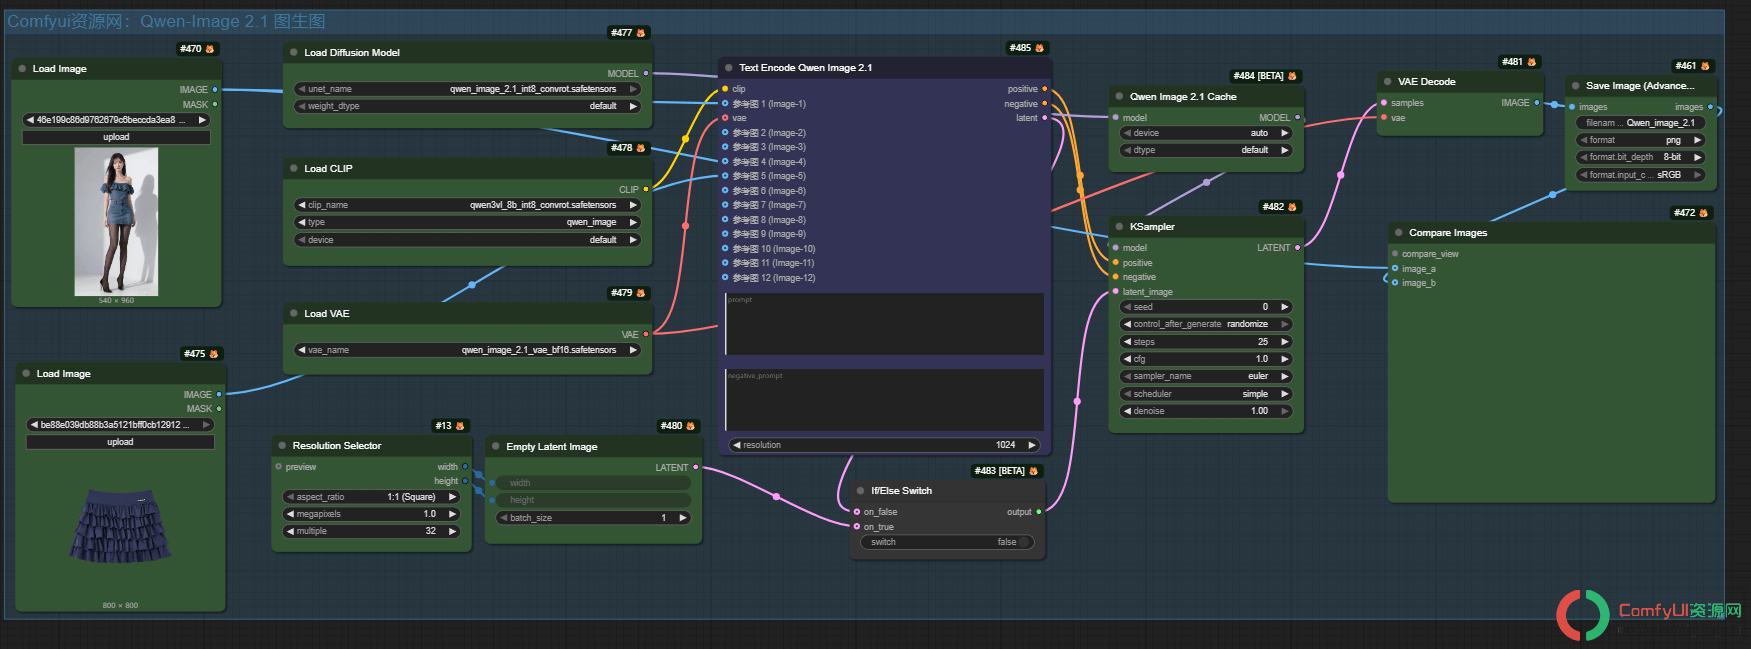
两个工作流加载相同的文件。两个模板默认都使用 int8 版本的扩散模型。text_encoders
- qwen3vl_8b_bf16.safetensors
diffusion_models
- qwen_image_2.1_int8_convrot.safetensors(模板默认加载,内存占用更低)
- qwen_image_2.1_bf16.safetensors(完整精度,需要更多内存)
vae
- qwen_image_2.1_vae_bf16.safetensors
模型保存位置
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 text_encoders/
│   │      └── qwen3vl_8b_bf16.safetensors
│   ├── 📂 diffusion_models/
│   │      ├── qwen_image_2.1_int8_convrot.safetensors
│   │      └── qwen_image_2.1_bf16.safetensors
│   └── 📂 vae/
│          └── qwen_image_2.1_vae_bf16.safetensors
三、工作流
Qwen Image 2.1 文生图:
Qwen Image 2.1 图生图
四、效果示例
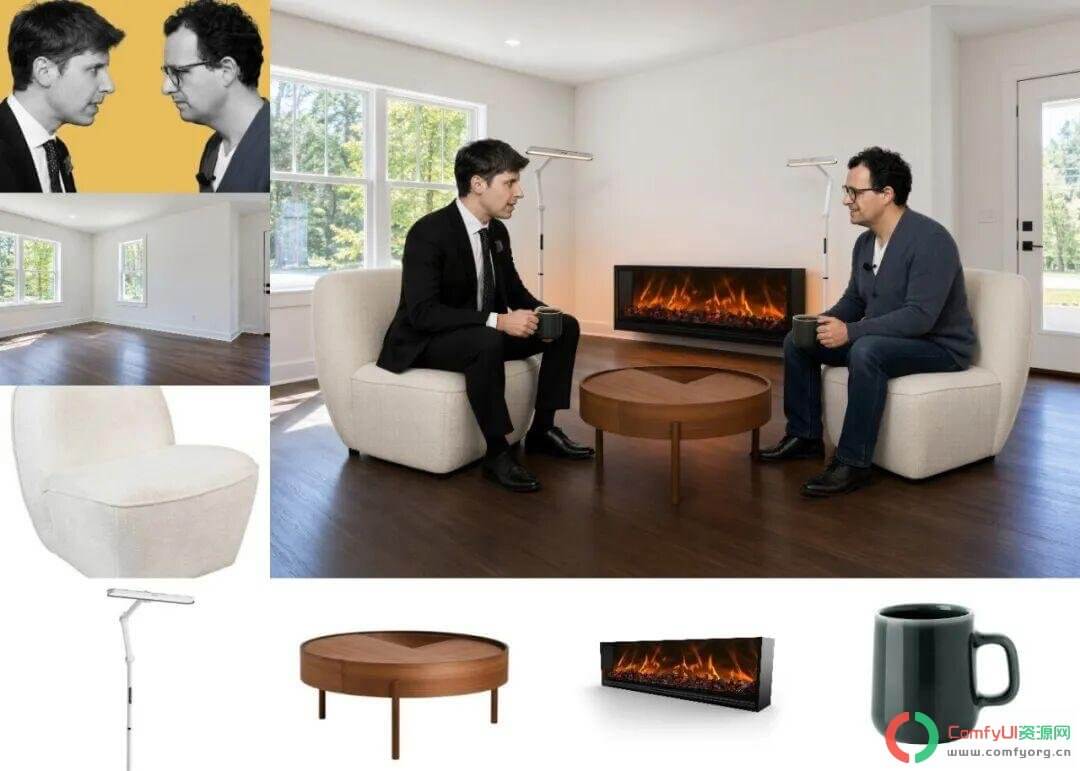
Qwen-Image-2.1 最高支持 10 张参考图输入。我们试了试,让奥特曼和达里奥坐下来谈谈。使用了 7 张图片:两个人对峙的照片(改个表情)、背景房间、单人沙发、咖啡杯(倒上咖啡)、落地灯、电壁炉、矮桌,最终生成一张完整的效果图。
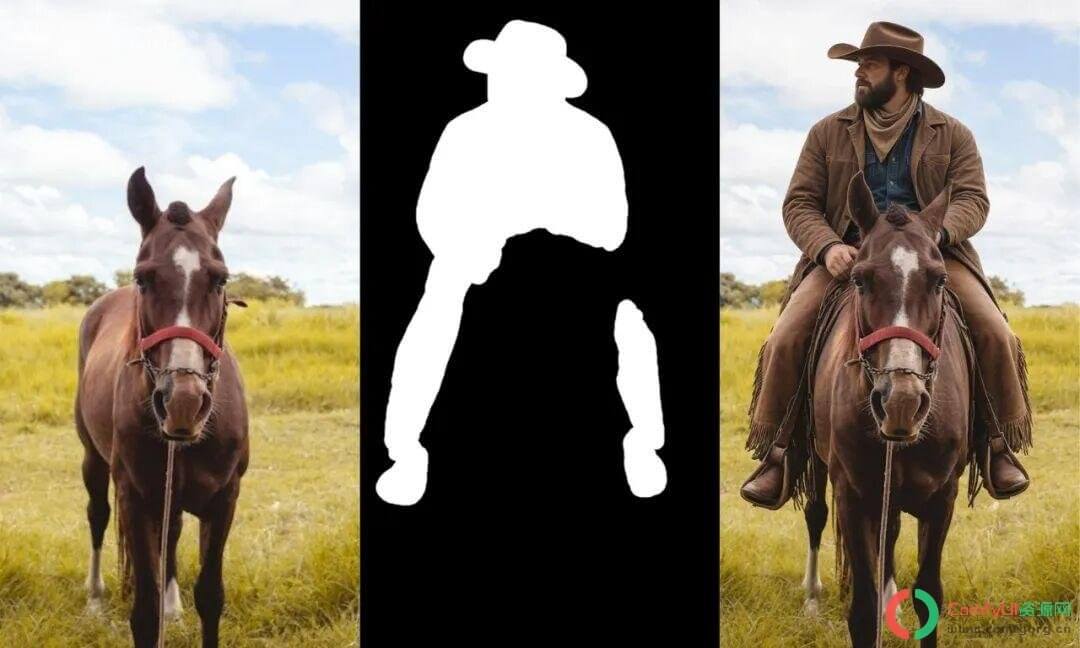
涂抹方式则适合直接标出新增对象的位置,但直接在原图上圈选或涂抹也会遮住一部分画面。为此,模型还支持通过额外的掩码图片指定编辑区域,这让原图信息能够完整地输入模型。对于包含人物和商品的设计来说,这种保留能力尤为关键。
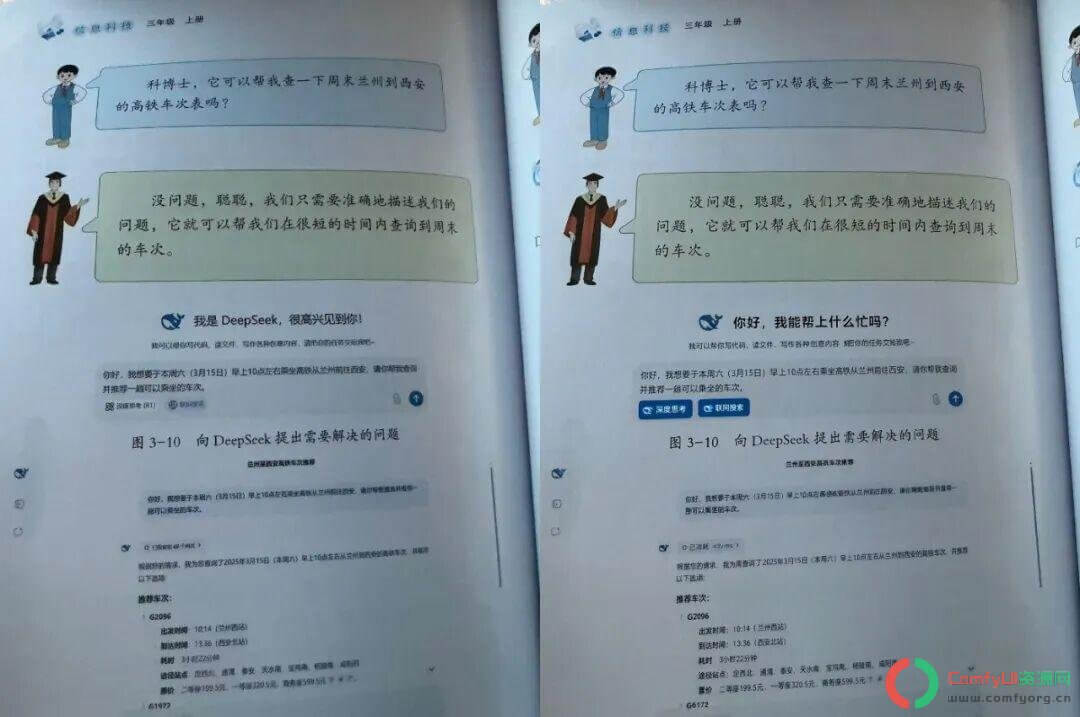
我们尝试了一下,比如让它把小学《信息科技 三年级上册》的这页截图里面,DeepSeek 的欢迎语「我是 DeepSeek,很高兴见到你!」改成「你好,我能帮上什么忙吗?」,再把深度思考(R1)改成最新版本的深度思考按钮,再点亮:
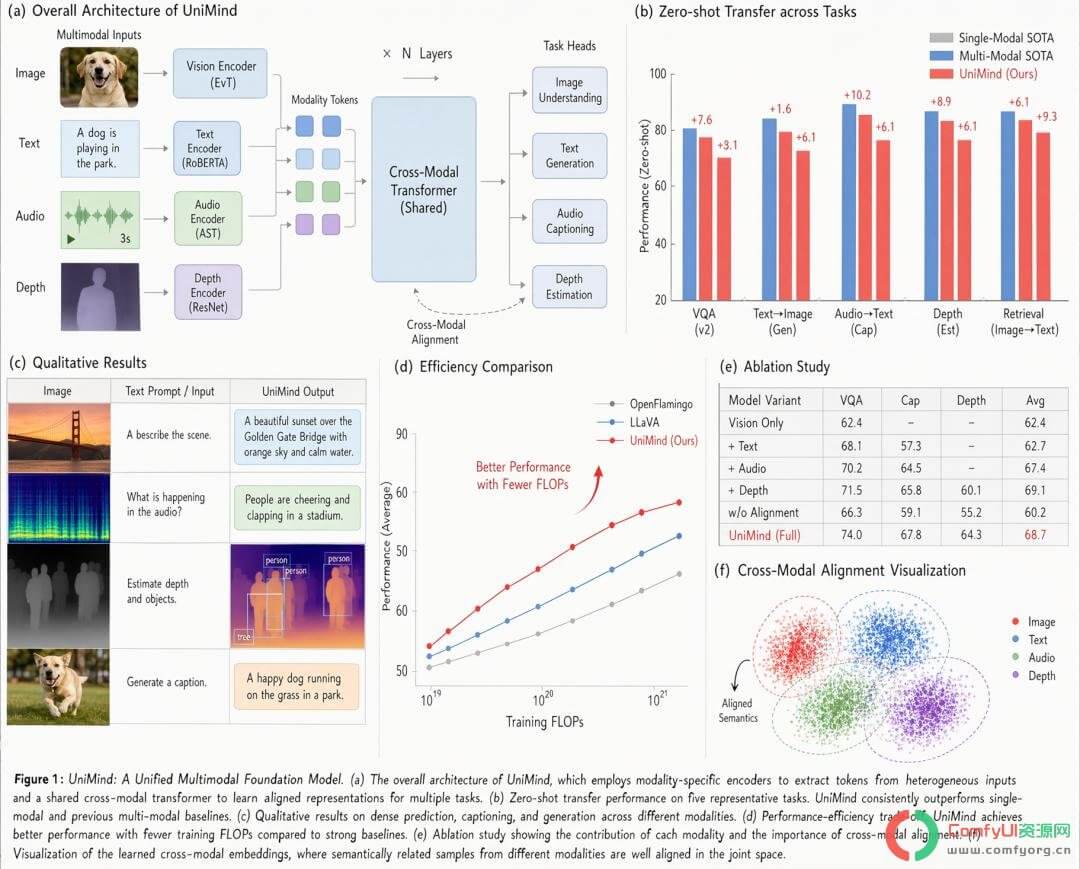
在生成和编辑之外,Qwen-Image-2.1 也继续改善了在文字与人物上的表现。不论是文字密集的图文页面、信息图、论文配图,内容的准确性和排版美观程度都被提升到了一个可观的程度。
五、总结
随着 Qwen-Image-2.1 这类图像模型的开源,社区还会进一步把生成与编辑能力融入更多内容制作场景,让更多人用上适合自己需求的创作工具。当这些 AI 能力成为日常软件中随手可用的功能,从想法到视觉作品的门槛,或许就能再次大幅降低。