


一、ComfyUI_MiniMaxH3_Director 介绍
ComfyUI_MiniMaxH3_Director 是一个基于 MiniMax H3 视频模型的 ComfyUI 插件及工作流集合,主要用于在本地或云端通过节点方式生成和编辑视频 。它提供了文生视频、图生视频、视频编辑等多种工作流,支持二次采样高清放大及音画同步功能 。MiniMaxH3Director 是面向长视频、多段生成的 MiniMax H3 导演台节点,把分段计划、条件编码、采样解码和导出整合在一个节点里。底层走官方 MiniMaxH3ImageToVideo / MiniMaxH3ReferenceToVideo + MiniMaxH3SigmaShift + KSampler + AV 分离解码链路,原生输出立体声音频。
核心能力
| 功能 | 说明 |
|---|---|
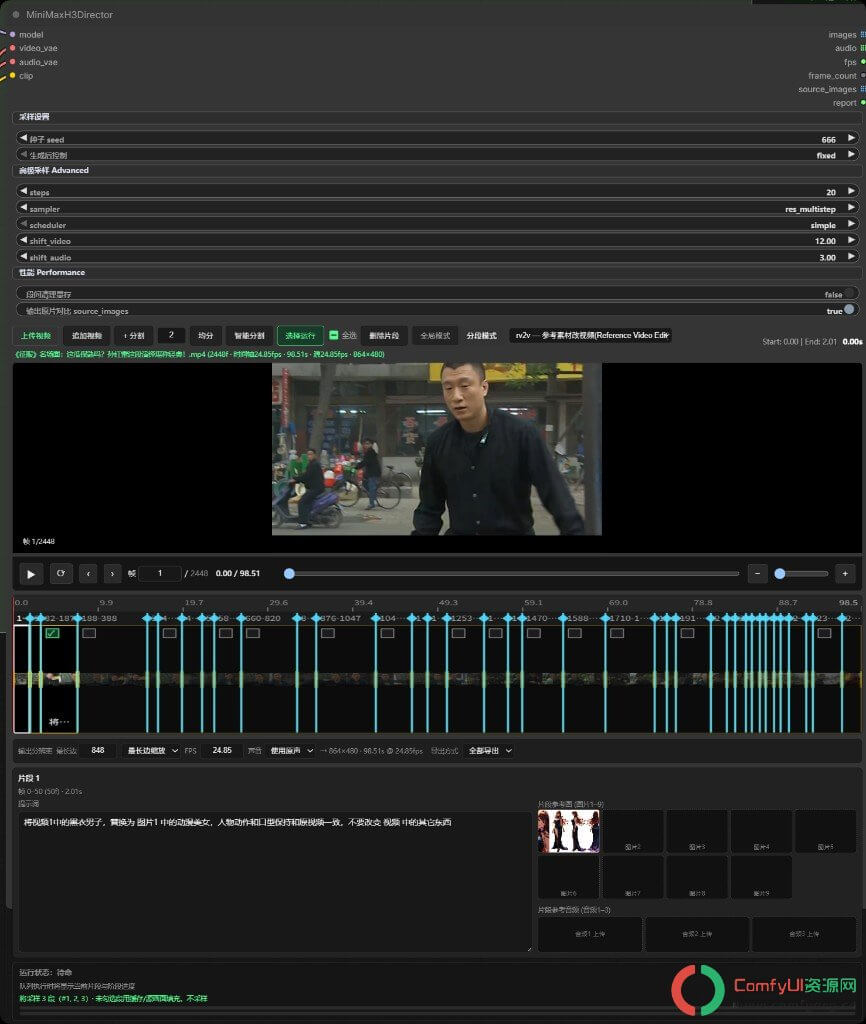
| 多段时间轴 | 节点内上传视频,支持切分、均分、智能分镜分割(PySceneDetect)、追加;分割点可选中删除;可视化时间轴预览每段范围与缩略图 |
| 多任务模式 | task_type:t2v(文生视频)、i2v(图生视频)、fl2v(首尾帧生视频)、r2v(参考主体生视频 / 素材组)、v2v(视频转视频)、rv2v(参考素材改视频) |
| 首尾帧 (fl2v) | 独立首尾帧时间轴:多组关键帧、「添加一组」可只写提示词(文生)、或上传首帧和/或尾帧(官方支持只传尾帧);开「段间引导」并勾「引用上段」时,空组用上一段末尾 N 帧做运动/音频衔接;拖缘调时长;支持「选择运行」只跑部分组 |
| 参考素材组 (r2v) | fl2v 式分组 UI:上方「公共参数」共享参考图/音频与公共提示词(与每组提示词拼接);每组可再挂图片1–9 / 音频1–3 / 视频1–3;提示词用 <Picture N> / <Video K> / <Audio J>(或 @ 引用);时间轴预览与选中状态同步 |
| 源视频编辑 (v2v / rv2v) | Bernini 风格源视频时间轴;每段源画面自动绑定 <Video 1>;rv2v 另可挂参考图(图片1–9)与参考音频(音频1–3) |
| 选择运行 | 开启后只采样勾选的片段/素材组;未勾选段可用缓存或源画面填充(全部导出时) |
| 外部多组接线 | Director Group (Image to Video) / (Reference to Video) + Groups Combine;连入导演台 i2v_groups / r2v_groups 后外部优先覆盖 UI 素材,仍支持跑批与选择运行 |
| 原生立体声音频 | 与画面同次采样生成;v2v/rv2v 可选生成声音 / 使用原声 / 静音 |
| 段间引导 | 默认关闭;多段 t2v / i2v / fl2v / r2v / v2v / rv2v 时可开启,将上一段生成结果的末尾运动(及生成音频)钉入下一段采样再裁掉前缀。上下文帧数:5 / 22 / 39 / 56,默认推荐为 22。感谢 ComfyUI-H3-Motion-Context 提供的实现思路 |
| 二采 / 放大 (Refine) | 外接 MiniMax H3 Director Refine 到导演台 refine 口。未接线 = 原来的单次采样。refine = 同分辨率精修;upscale = 先放大到目标画布再按 SIGMAS 二采(像素插值 / RTX VSR / H3 latent);latent_upscale = 只放大 H3 latent、不二采。passes 可多次精修(upscale 只放大一次)。可选接 refine_model 换二采 UNET。images 为二采后成片,images_pre_refine 为一采(放大前)画面 |
| 运行报告 | report 口输出分段计划、每段任务摘要 |
参考音频槽可直接选择已有视频,或从本地选择音频/视频;视频会立即提取首条音轨为 FLAC,结果直接保存到 input/。本地视频只在临时目录中用于提取,不会作为视频素材保存。音频沿用 ComfyUI 现有上传规则:同名同内容直接复用,同名不同内容自动添加序号且不会覆盖;当前素材组也不会重复添加同一路径。
二、插件安装
方法一:手动安装(标准方式)
cd ComfyUI/custom_nodes
git clone https://github.com/AIMixer/ComfyUI_MiniMaxH3_Director.git
pip install -r ComfyUI_MiniMaxH3_Director/requirements.txt
重启 ComfyUI。
方法二:ComfyUI Manager
- 打开 ComfyUI Manager
- 选择 Install via Git URL
- 填入
https://github.com/AIMixer/ComfyUI_MiniMaxH3_Director.git并安装 - 重启 ComfyUI
模型与工作流下载
完整资源包(MiniMax H3 模型权重 + 示例 JSON 工作流)文末网盘
下载后将 models/ 合并到 ComfyUI/models/,JSON 工作流拖入 ComfyUI 即可。
也可参考:
- Hugging Face: Comfy-Org/MiniMax-H3
- ComfyUI 文档: MiniMax H3 工作流示例
网盘示例工作流:example_workflows
| 工作流 | task_type | UNET | 说明 |
|---|---|---|---|
minimax_h3_director_t2v.json |
t2v | fl2va | 文生音视频 |
minimax_h3_director_fl2v.json |
fl2v | fl2va | 首尾帧(「添加一组」) |
minimax_h3_director_r2v.json |
r2v | ref2va | 参考改视频素材组 |
minimax_h3_director_v2v.json |
v2v | ref2va | 源视频时间轴编辑 |
minimax_h3_director_rv2v.json |
rv2v | ref2va | 源视频 + 参考图/音频 |
minimax_h3_director_external_groups_i2v.json |
fl2v | fl2va | 外部 Group×2 → Combine → i2v_groups |
minimax_h3_director_external_groups_r2v.json |
r2v | ref2va | 外部 Group×N → Combine → r2v_groups |
minimax_h3_director_二采_加速.json |
r2v | ref2va | 外接 Refine 二采(SIGMAS + H3 latent);images 与 images_pre_refine 各出一路成片 |
推荐模型文件
| 用途 | 文件名 | 目录 |
|---|---|---|
| UNET (t2v / i2v / fl2v) | minimax_h3_fl2va_pruned_int8_convrot.safetensors |
models/diffusion_models/ |
| UNET (r2v / v2v / rv2v) | minimax_h3_ref2va_pruned_int8_convrot.safetensors |
models/diffusion_models/ |
| CLIP | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
models/text_encoders/ |
| Video VAE | minimax_h3_video_vae_fp16.safetensors |
models/vae/ |
| Audio VAE | minimax_h3_audio_vae_fp32.safetensors |
models/vae/ |
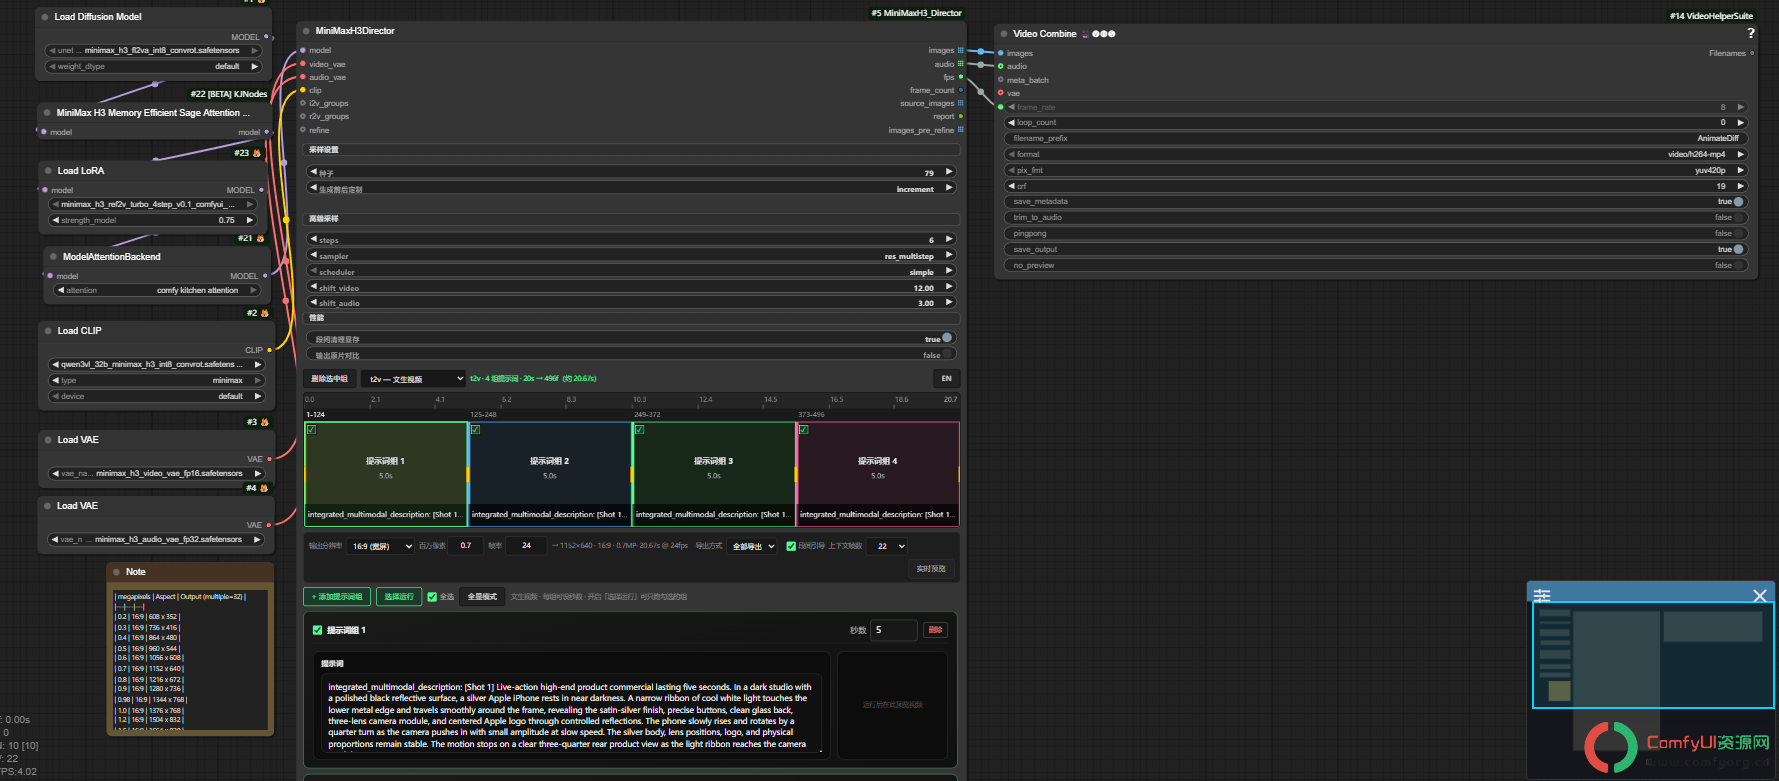
三、工作流
四、总结
搭建 MiniMaxH3 本地影视工作台的过程,本质上是一次对 ComfyUI 可视化编程和 AI 视频生成管道的深度探索。它最大的价值不在于开箱即用的傻瓜式操作,而在于它赋予了你对生成流程的完全控制权和可定制性。从解决显存不足的报错,到成功调通 API 实现批量处理,每一步的突破都会加深你对这项技术的理解。
建议先从成功运行一个官方或社区分享的简单图生视频工作流开始,记录下所有的步骤和参数。然后,尝试替换其中的模型,调整采样参数,观察输出变化。最后,再挑战将多个功能(如高清修复、人脸修复)组合进工作流。这个过程可能会遇到不少挫折,但每一次问题的解决,都是你构建自己专属 AI 生产流水线的一块坚实基石。
跑一次需要多长时间3090卡
如何找到这个缺失的节点包? 缺失节点包 请安装缺失的包以使用此工作流。 未知包 MiniMaxH3MemoryEfficientSageAttentionPatch