


Qwen4.0 架构来了,Qwen3.8-Flash-Next重磅来袭:125B总参却只激活6B,效率碾压大模型
模型体验地址:https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next/files
一、Qwen3.8-27B介绍
Qwen3.8-27B 这几天之所以被本地模型用户高度关注,不是因为它参数量特别大,恰恰相反,是因为它把相当强的 Coding、Agent、长上下文和多模态能力放进了一个仍然有机会在消费级硬件上运行的 27B dense 模型里。这是一款 27B 稠密模型,原生支持文本、图片和视频,默认开启思考模式,原生上下文长度为 262,144 tokens,还能通过扩展支持更长上下文。模型采用 Apache 2.0 许可证,官方权重已经提供 BF16 和 FP8 版本,社区也很快补齐了 GGUF 量化版。
但真正让人犹豫的,不是“它强不强”,而是另一个更现实的问题:
Qwen3.8-27B 到底应该下载哪个版本,本地部署时 16GB、24GB、32GB 显存分别该怎么选?不同量化版本效果差多少?速度到底能到什么水平?
这篇文章想解决的,就是这个问题。
1、先把基本事实讲清楚:27B 并不等于必须 54GB 显存
Qwen3.8-27B 的原始 BF16 权重大约是 54.7GB。 从原生权重出发,你几乎不可能在常见消费级单卡上舒服地跑它,更不用说还要给 KV Cache、上下文和运行时 Buffer 留空间。
但这并不意味着它不适合本地部署,因为社区已经很快提供了丰富的量化版本。以 Unsloth 发布的 GGUF 为例,大致可以看到这样一条文件尺寸曲线:
这组数据最值得关注的,不是某个具体小数,而是它呈现出来的趋势:
Q4 是一个很明显的拐点。
从 Q8 降到 Q6、Q5、Q4,模型尺寸明显下降,但模型输出分布仍然相对接近 BF16;从 Q4 再继续压到 Q3、Q2,误差上升速度开始明显变快。
这意味着:
- Q8/Q6:更适合追求质量上限的用户
- Q5:质量和资源占用平衡得很好
- Q4:进入最具性价比的甜点区
- Q3/Q2:可以跑,但妥协会更明显
也就是说,Q4 值得推荐,并不是因为“大家都在用 Q4”,而是因为它恰好落在一条非常典型的甜点曲线上: 显存占用已经降得比较低,但模型行为还没有出现特别明显的崩塌。
2.同样叫 Q4,也并不都一样
很多人看到 “Q4_K_M” 这类名字,会下意识认为不同作者发布的 Q4 大同小异。 但对 Qwen3.8-27B 来说,这种理解并不准确。
AtomicChat 还做了一个很有意思的对比:同样是 4bit 附近的量化,不同发布者和不同量化策略,误差并不一样。
参考:https://huggingface.co/AtomicChat/Qwen3.8-27B-GGUF 补充分析:https://kingy.ai/blog/qwen3-8-27b-best-quantization-gguf/
这背后的原因在于,量化并不只是“统一从 16bit 变成 4bit”。 真正影响结果的是:
- 哪些 tensor 保留更高精度
- Attention、FFN、Output Head 如何分配 bit
- 是否使用 importance matrix
- 是否做 architecture-aware 的动态量化
因此,“Q4 版本怎么选”这个问题,不能只看名字,最好还要看发布者是否做过专门优化、是否有质量测试数据。
就目前公开材料看,Unsloth 的 UD-Q4_K_XL 和 AtomicChat 的 AD-Q4_K_M 都属于比较值得关注的版本;如果你更看重兼容性和通用性,传统 Q4_K_M 仍然是最保险的入口。
二、先判断你的机器能跑哪个版本
不要只看“27B”这三个字符。模型能否运行,取决于权重精度、上下文长度、KV Cache、推理框架和并发数。
几个有用的参考数字:
- BF16 GGUF 文件约 54.7GB;运行时还需要额外内存,不适合 64GB 以下的消费级设备硬上。
- 官方 FP8 仓库约 30.9GB;建议至少准备 48GB NVIDIA 显存。
- 4-bit GGUF 约 16.1~17.9GB;24GB 显存或 32GB Apple 统一内存是更现实的起点。
- 3-bit GGUF 约 11.9~13.8GB;16GB 显存可以尝试,但质量会有更明显损失。
我的建议很直接:
- 16GB 显存:选 3-bit,或让部分层落到 CPU;能跑,但不要期待很高速度。
- 24GB 显存:优先 Q4,先把上下文设为 8K 或 16K。
- 32GB Apple 统一内存:Q4 通常是质量与速度最均衡的选择。
- 48GB 以上 NVIDIA 显存:直接上官方 FP8,用 vLLM 对外提供 API。
- 只有 CPU:至少准备 32GB 系统内存和足够耐心;本地验证可以,重度编码或 Agent 体验不会理想。
还有一个常见误区:模型支持 262K 上下文,不代表你应该一上来就开到 262K。上下文越长,缓存占用越高。消费级设备先从 8K、16K 或 32K 开始,确认稳定后再增加。
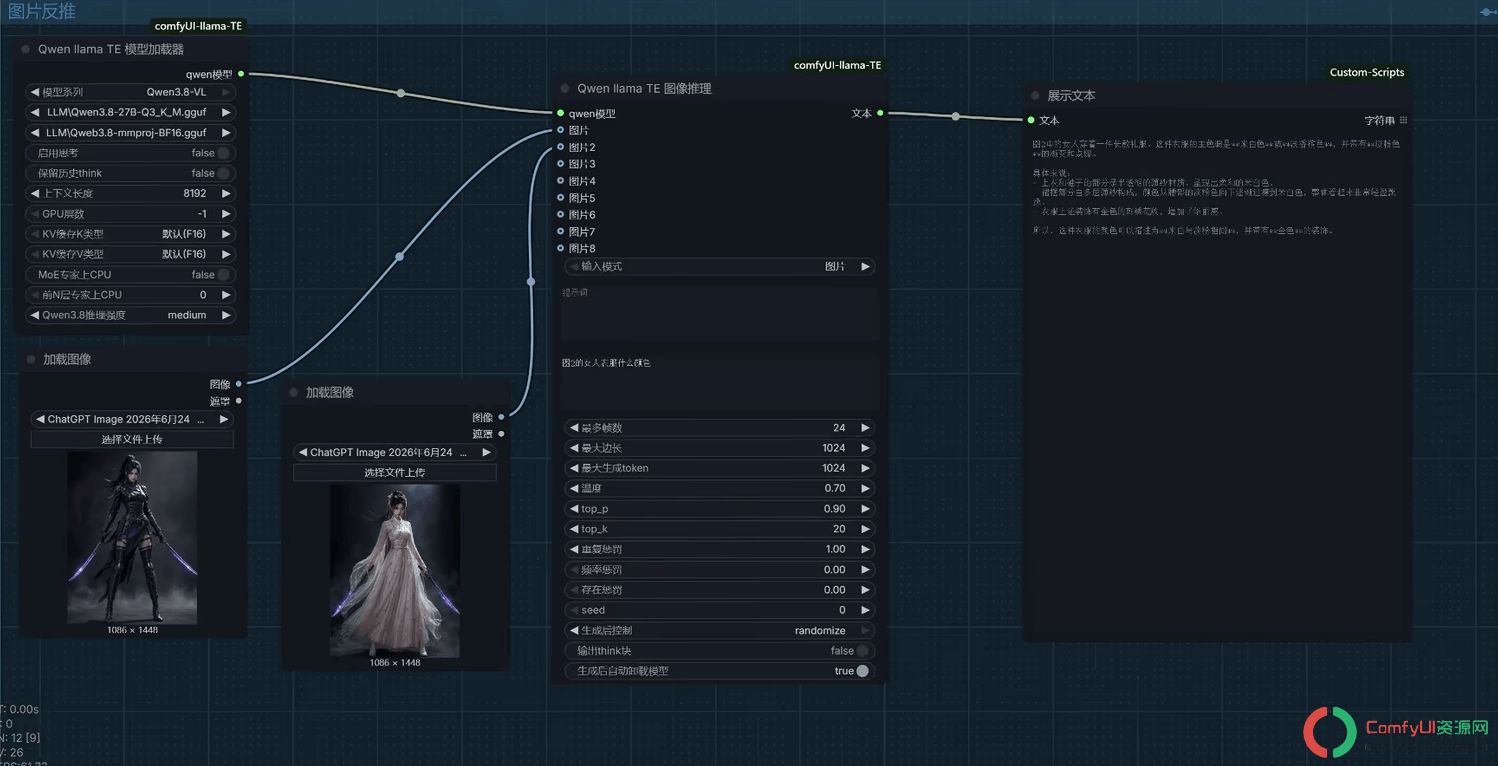
三、方案A:Comfyui+llama.cpp+qwen3.8模型
四、方案 B:GGUF + llama.cpp,普通电脑最快上手
这条路线适合 RTX 3090/4090、32GB 以上 Apple Silicon,以及想用 CPU + GPU 混合推理的用户。
这里使用 Unsloth 提供的 UD-Q4_K_XL 量化版,文件约 17.9GB。它不是 Qwen 官方量化权重,但来源模型是官方 Qwen/Qwen3.8-27B,而且 Hugging Face 页面已经给出了 llama.cpp 的直接运行命令。
1. llama.cpp 提供了一个比较方便的统一安装方式。
macOS / Linux
打开终端:
curl https://llama.app/install.sh | sh
官方安装脚本会根据系统和硬件情况安装相应的 llama 工具。
Windows 可以使用 PowerShell:
irm https://llama.app/install.ps1 | iex
安装完成后,可以测试:
llama --help
如果能够正常显示帮助信息,说明安装成功。
2.直接在终端对话
llama cli -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_XL
第一次运行会自动下载模型。请预留至少 25GB 磁盘空间,并确保网络稳定。
如果 24GB 设备仍然显存不足,可以换成更小的量化:
llama cli -hf unsloth/Qwen3.8-27B-GGUF:Q3_K_M
如果内存更充裕,希望保留更多质量,可以尝试 Q5_K_M。
3.启动本地 API 和网页界面
llama serve -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_XL
默认地址是:
http://127.0.0.1:8080
浏览器打开这个地址就能聊天,同时还会得到一个 OpenAI 兼容接口:
http://127.0.0.1:8080/v1
用 curl 测试:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_XL",
    "messages": [
      {"role": "user", "content": "用 Python 写一个带重试和指数退避的 HTTP 请求函数"}
    ],
    "temperature": 0.7,
    "max_tokens": 1024,
    "stream": false
  }'
如果客户端要求 API Key,填一个占位字符串即可;本机默认服务通常不会校验它。
这条路线最适合本地文本对话、写作和编码。Qwen3.8-27B 本身是视觉语言模型,但 GGUF 路线的多模态能力取决于 llama.cpp 版本及视觉投影文件支持;如果图片和视频是核心需求,优先选择下一节的官方权重方案。
五、LM Studio(模型运行工具,小白推荐,纯图形界面)
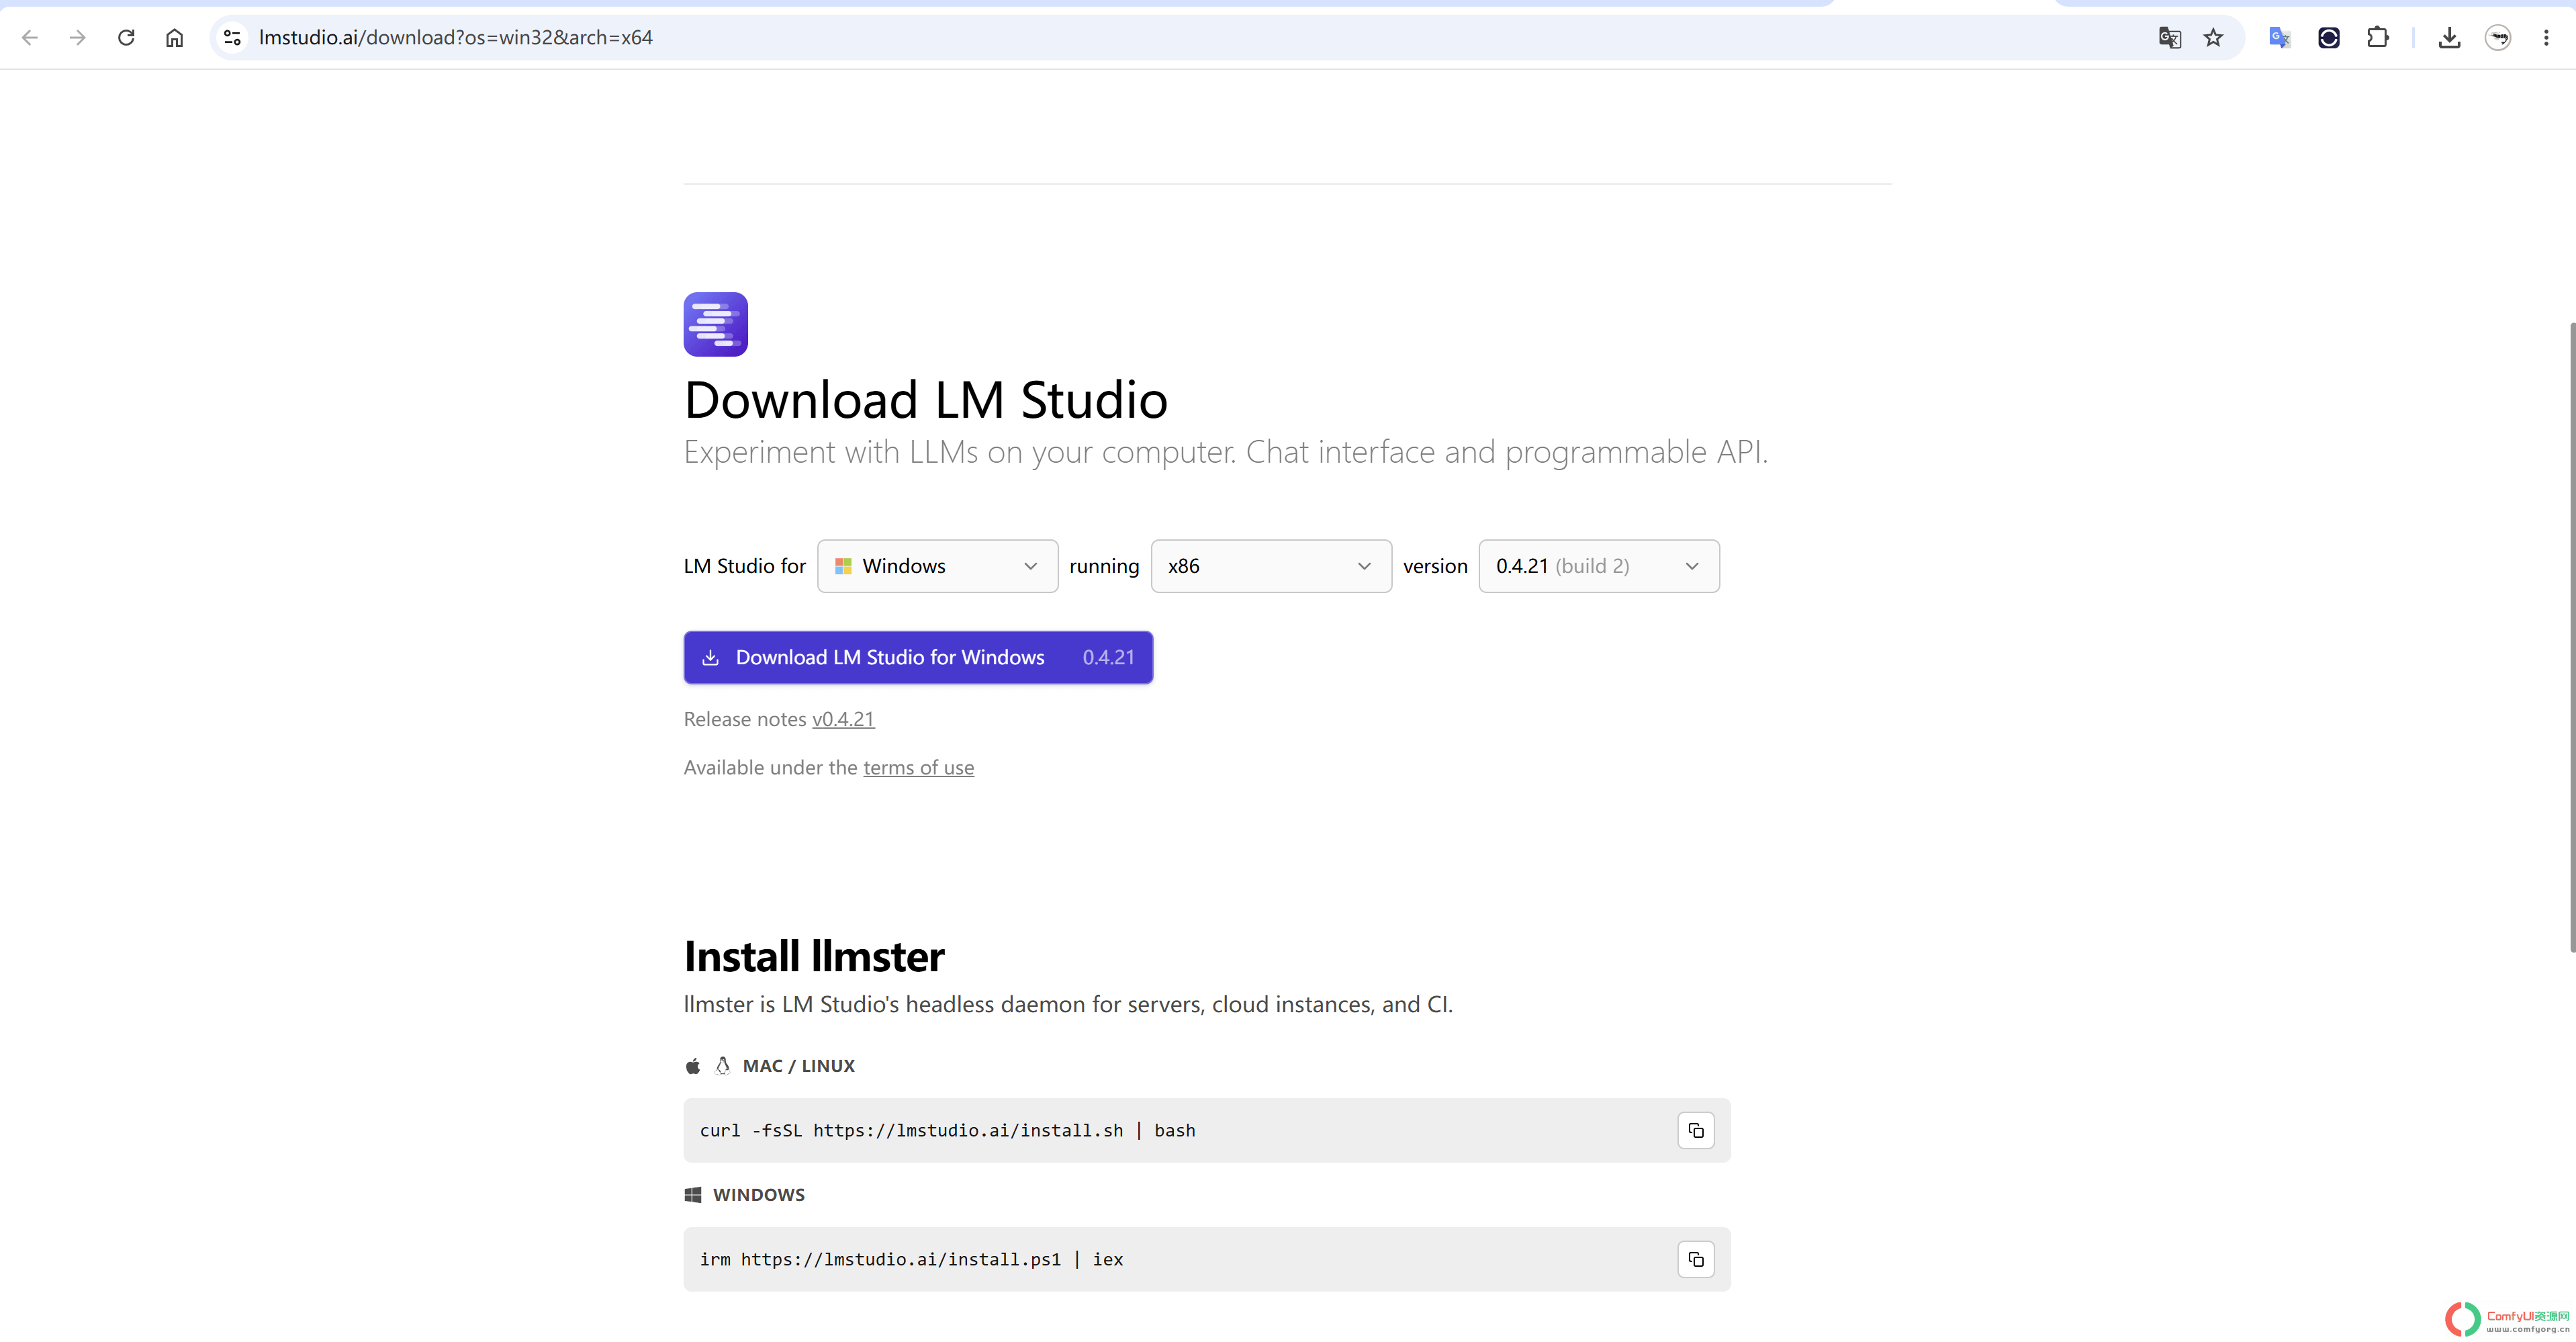
1、去 lmstudio.ai 下载安装,Windows和Mac都有
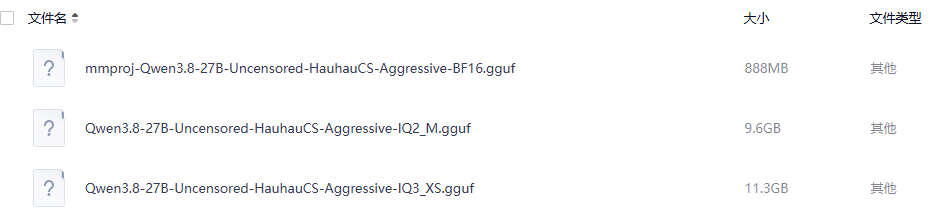
2、打开后网盘中下载: Qwen3.8-27B-Uncensored-HauhauCS-Aggressive-IQ3_XS.gguf,找到 Q3_XS量化版下载,如果是24G显存,就下载Q4量化版。
3、加载模型后,直接在内置对话界面使用就可以了
踩坑提醒:
- 模型文件约18GB,下载前先确认硬盘空间够,至少留30GB余量比较稳
- 第一次加载模型较慢,十几秒到一分多钟不等,这是正常现象,不是卡死
- Windows系统确保显卡驱动是最新版,否则可能识别不到显存
六、方案 D:官方 FP8 + vLLM,部署成本更高但更适合服务
如果你有 48GB 或更大的 NVIDIA 显存,并且希望把模型接到 IDE、Agent、网页应用或内网服务,vLLM 更合适。
官方 vLLM 配方要求 vLLM 0.17.0 及以上;Qwen3.8 的配置还要求 Transformers 5.8.0 及以上。建议使用 Linux,并先确认 nvidia-smi 能正常识别 GPU。
- 创建环境并安装
python3 -m venv .venv
source .venv/bin/activate pip install -U pip pip install “vllm>=0.17.0” “transformers>=5.8.0” openai
- 启动官方 FP8 模型
vllm serve Qwen/Qwen3.8-27B-FP8 \
  --host 127.0.0.1 \
  --port 8000 \
  --max-model-len 32768 \
  --gpu-memory-utilization 0.90 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
这里故意把上下文先限制在 32K,而不是直接拉满 262K。先确保模型稳定启动,再根据剩余显存逐步增加 —max-model-len。
如果你有多张同型号 GPU,可以加入:
--tensor-parallel-size 2
数字改成实际参与张量并行的 GPU 数量。
- 调用本地 OpenAI 兼容 API
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Qwen/Qwen3.8-27B-FP8",
    "messages": [
      {"role": "user", "content": "分析这个项目的架构,并给出三个最值得优先处理的技术债"}
    ],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 2048,
    "chat_template_kwargs": {
      "enable_thinking": true,
      "reasoning_effort": "medium"
    }
  }'
Qwen3.8 默认开启思考模式,并支持三档推理深度:
- xhigh:默认档,适合复杂编码、研究和长任务。
- medium:质量、速度和成本更均衡。
- low:更快,但复杂任务可能需要更多重试。
如果只是做摘要、改写或简单问答,可以关闭思考模式:
采样参数来自 Qwen 官方建议。不要在思考模式下照搬非思考模式的参数,否则输出质量和稳定性可能发生变化。
{
  "temperature": 0.7,
  "top_p": 0.8,
  "presence_penalty": 1.5,
  "chat_template_kwargs": {
    "enable_thinking": false
  }
}
上面两组
七、接入 IDE、Agent 或自己的应用
无论使用 llama.cpp 还是 vLLM,最终拿到的都是 OpenAI 兼容接口。
配置时只需要三项:
- llama.cpp Base URL:
http://127.0.0.1:8080/v1 - vLLM Base URL:
http://127.0.0.1:8000/v1 - API Key:本地无鉴权时可填 EMPTY
模型名称不要凭感觉填写,先查询:
curl http://127.0.0.1:8000/v1/models
把返回的模型 ID 原样填进客户端。这样可以避开最常见的 model not found 问题。
八、最常见的五个坑
- 一启动就 OOM
先降低 —max-model-len,再降低量化精度或并发数。文件能放进显存,不等于模型一定能启动;运行时还要给 KV Cache、视觉编码器、CUDA Kernel 和框架本身留空间。
- 速度比预想中慢
检查模型是不是有大量层落在 CPU,确认 GPU 驱动正常,并观察 nvidia-smi。27B 稠密模型每个 token 都要经过完整参数,不能用小 MoE 模型的速度预期来衡量它。
- 输出重复、夹杂语言或停不下来
先升级 llama.cpp、vLLM 或 SGLang,再恢复官方推荐的采样参数。非思考模式可在 0~2 之间调整 presence_penalty,但值太高也可能引发语言混杂。
- 第一次启动很久没有响应
大概率是在下载几十 GB 的权重或编译推理 Kernel。观察终端日志和磁盘占用,不要反复重启;反复重启只会让排查更困难。
- 把服务暴露到了公网
教程使用 127.0.0.1,只允许本机访问。如果改成 0.0.0.0,请同时配置 API Key、防火墙和反向代理。模型在本地运行不等于接口天然安全。
另外,真正的离线使用需要提前下载权重。调用多模态接口时,如果传入的是互联网图片 URL,服务端仍然可能访问外网;需要完全离线时,应使用本地文件或 Base64 数据。
九、我的结论
Qwen3.8-27B 的定位很清楚:它不是给 8GB 笔记本硬塞的“小模型”,而是一款仍然能被消费级高端硬件部署的 27B 稠密模型。
如果你只想尽快体验,24GB 显存或 32GB Apple 统一内存配 Q4 GGUF,是目前最省事的方案。
如果你要做本地编码助手、Agent 或多人 API 服务,48GB 以上 NVIDIA 显存配官方 FP8 和 vLLM,更值得投入时间。
本地部署最大的价值,也不只是省 API 费用。它让数据不必离开设备,让模型版本和推理参数完全可控,也让你可以真正理解上下文、量化、缓存与吞吐之间的取舍。
模型跑起来只是第一步。把它接进自己的工作流,才是本地大模型真正开始产生价值的地方。
