


一、MiniMax Music 3介绍
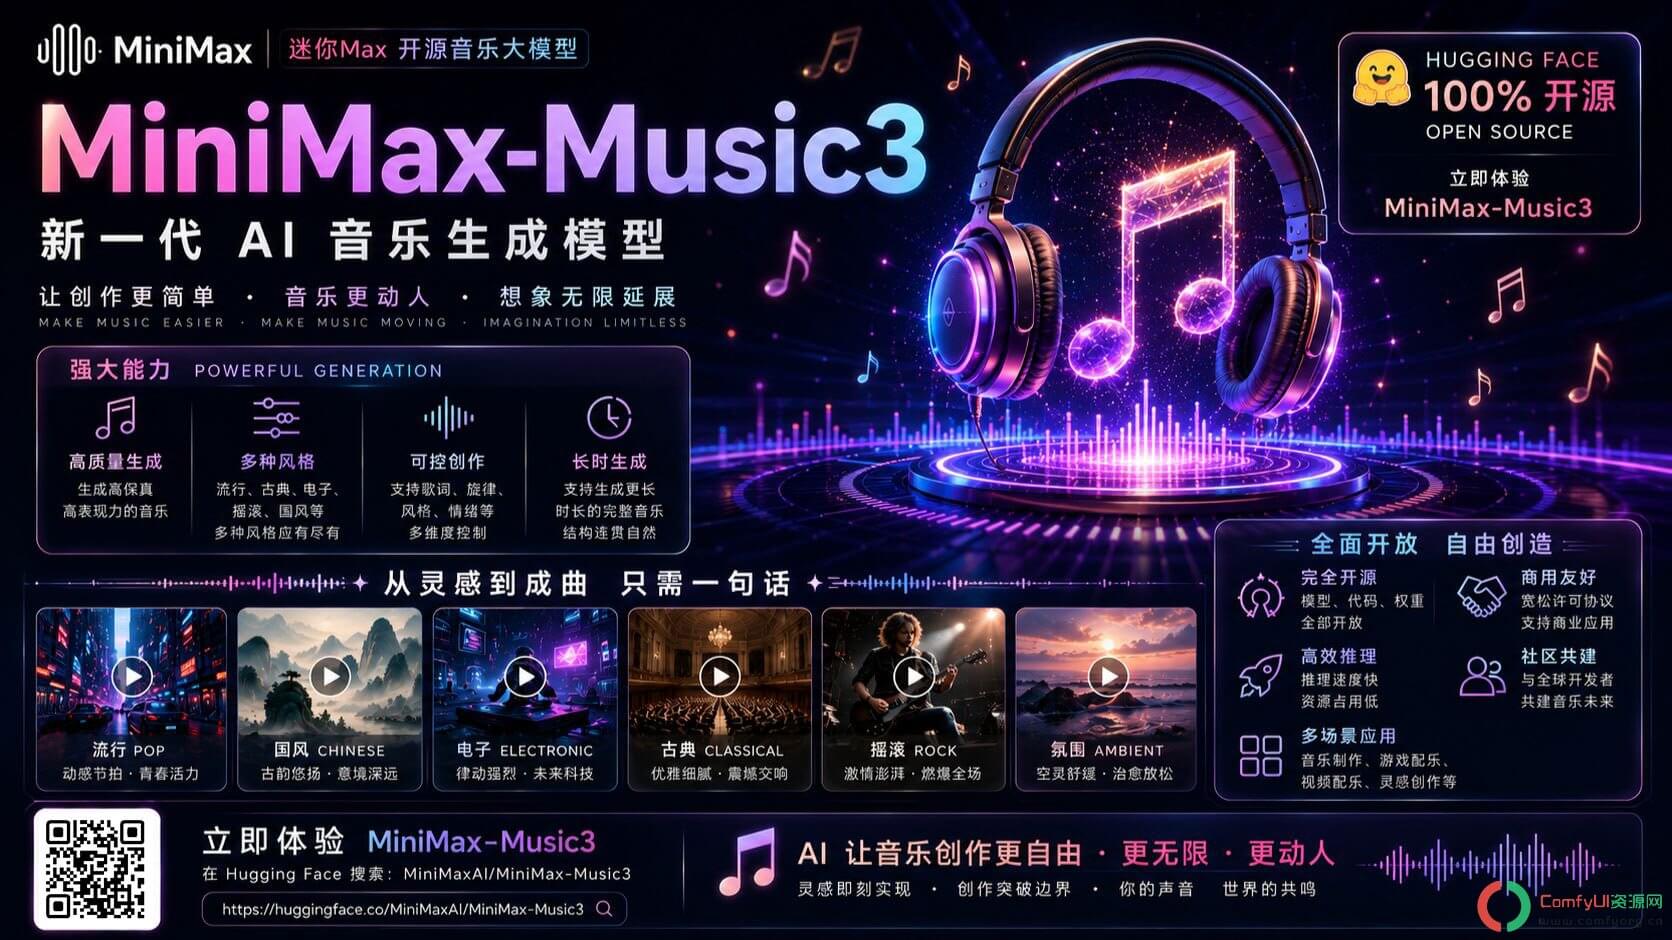
MiniMax-Music3 是 MiniMax 于 2026 年 8 月 14 日发布的音乐生成大模型,能够创作长达 五分钟 的完整歌曲。在给定歌词和详细音乐描述的条件下,该模型可生成结构连贯、富有表现力的人声、不断演化的编曲以及稳定的长时音频质量的歌曲。
MiniMax Music 3 结合了用于长距离音乐结构建模的 8B 全局大语言模型(Global LLM)、用于帧级声学细节建模的 0.6B 局部大语言模型(Local LLM),以及基于 流匹配(Flow Matching) 和 流变分自编码器(Flow-VAE) 的连续隐状态合成系统。该模型输出 32 kHz、16 位立体声 WAV 音频。
核心特性
- 生成能力:单首最长 5 分钟,覆盖前奏、主歌、预副歌、副歌、桥段、间奏、尾奏等完整结构。
- 输入方式:支持自然语言音乐描述 + 歌词文本联合驱动。
- 输出格式:32kHz 采样率、16-bit 深度、立体声 WAV 文件。
- 结构稳定性:在长音频中保持主题一致性、节奏稳定、人声身份统一及编曲逻辑推进。
二、相关安装
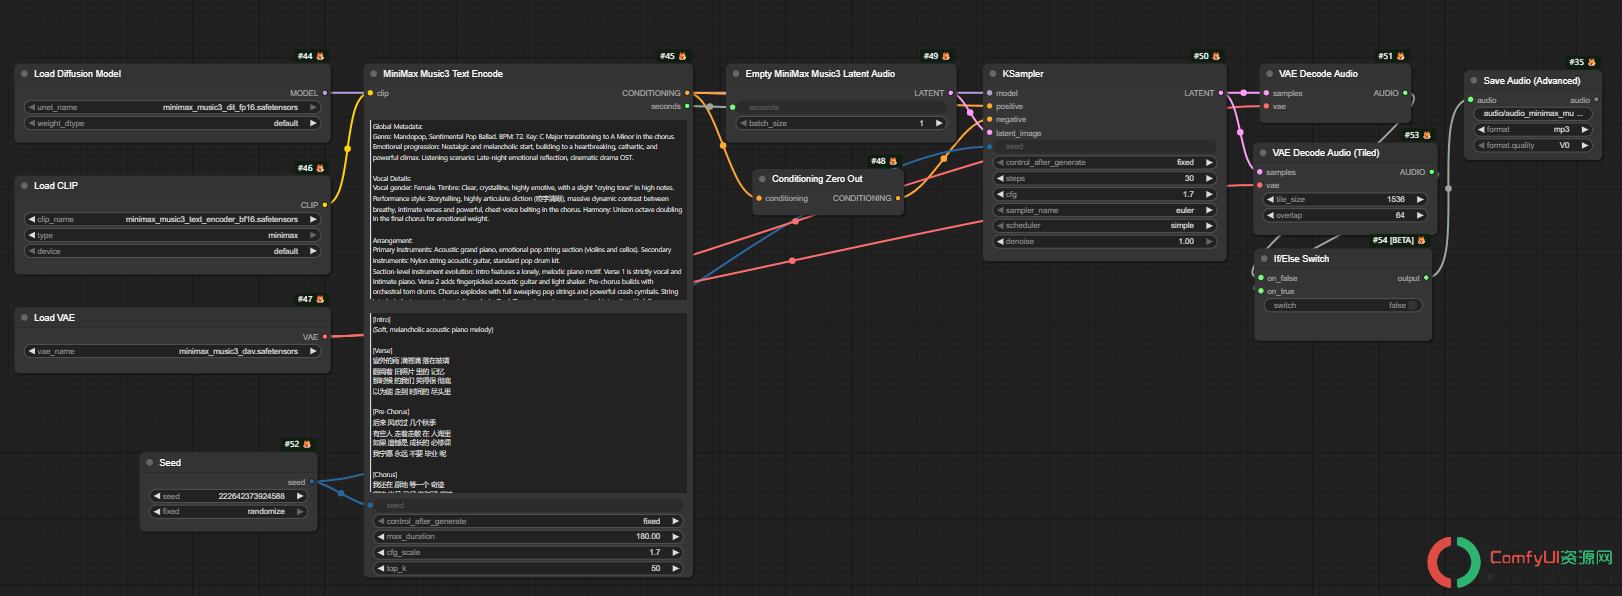
- Caption(描述):音乐描述。建议按三个部分编写:Global Metadata(全局元数据)(流派、BPM、调性、音阶、情绪推进、聆听场景、制作风格)、Vocal Details(人声细节)(人声性别、音色、演唱风格、和声、人声效果)、Arrangement(编曲)(主要和次要乐器、律动、低音、打击乐、织体、空间效果)。描述越具体,结果越接近预期
- Lyrics(歌词):要演唱的歌词,可使用
[Intro]、[Verse]、[Chorus]、[Bridge]、[Instrumental]、[Outro]等段落标签。标签是结构指令;歌词文本本身传达情绪 - max_duration:目标歌曲时长(秒)(模板默认 60 秒;模型最多支持约 300 秒 / 5 分钟)。歌曲越长,耗时和显存占用越多
- seed:生成用的随机种子。固定种子可复现同一首歌曲;更改种子可获得不同结果
- tiled_decode:以重叠分块方式解码音频 VAE,大幅降低显存占用,适合在低显存 GPU 上生成长歌曲。速度略慢,分块边界处有小概率出现接缝;高显存 GPU 上建议关闭以获得最佳质量
模型安装路径
📂 ComfyUI/
├── 📂 models/
│ ├── 📂 diffusion_models/
│ │ ├── minimax_music3_dit_int8_convrot.safetensors # For low VRAM
│ │ └── minimax_music3_dit_fp16.safetensors
│ ├── 📂 text_encoders/
│ │ └── minimax_music3_text_encoder_pruned_int8_convrot.safetensors
│ └── 📂 vae/
│ └── minimax_music3_dav.safetensors三、工作流
四、总结
MiniMax Music3这次是真把AI音乐从"能出片段"干到了"能写完整歌"——原生支持5分钟曲式结构,前奏、主歌、副歌、桥段全给你安排明白,还是完全开源免费的。 你要是真拿AI做过音乐内容就知道,让它跑出30秒好听片段太容易,难的是撑完一整首歌还不散架——后半段节奏乱掉、音色变味、结构垮掉是常事。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
准备试试看