


一、LTX2.5模型介绍
LTX-2.5 是LTX领先研究团队推出的最新开放世界视频生成模型,为媒体与娱乐、机器人、实时生成等领域的使用场景奠定基础。该模型可生成更高质量的视频,更准确地遵循提示词,并在多次生成中保持角色、场景和声音的一致性。在 2 张英伟达 GB200 芯片配置下生成 10 秒 720P 视频仅需 6.8 秒,原生集成 ComfyUI 工作流工具。
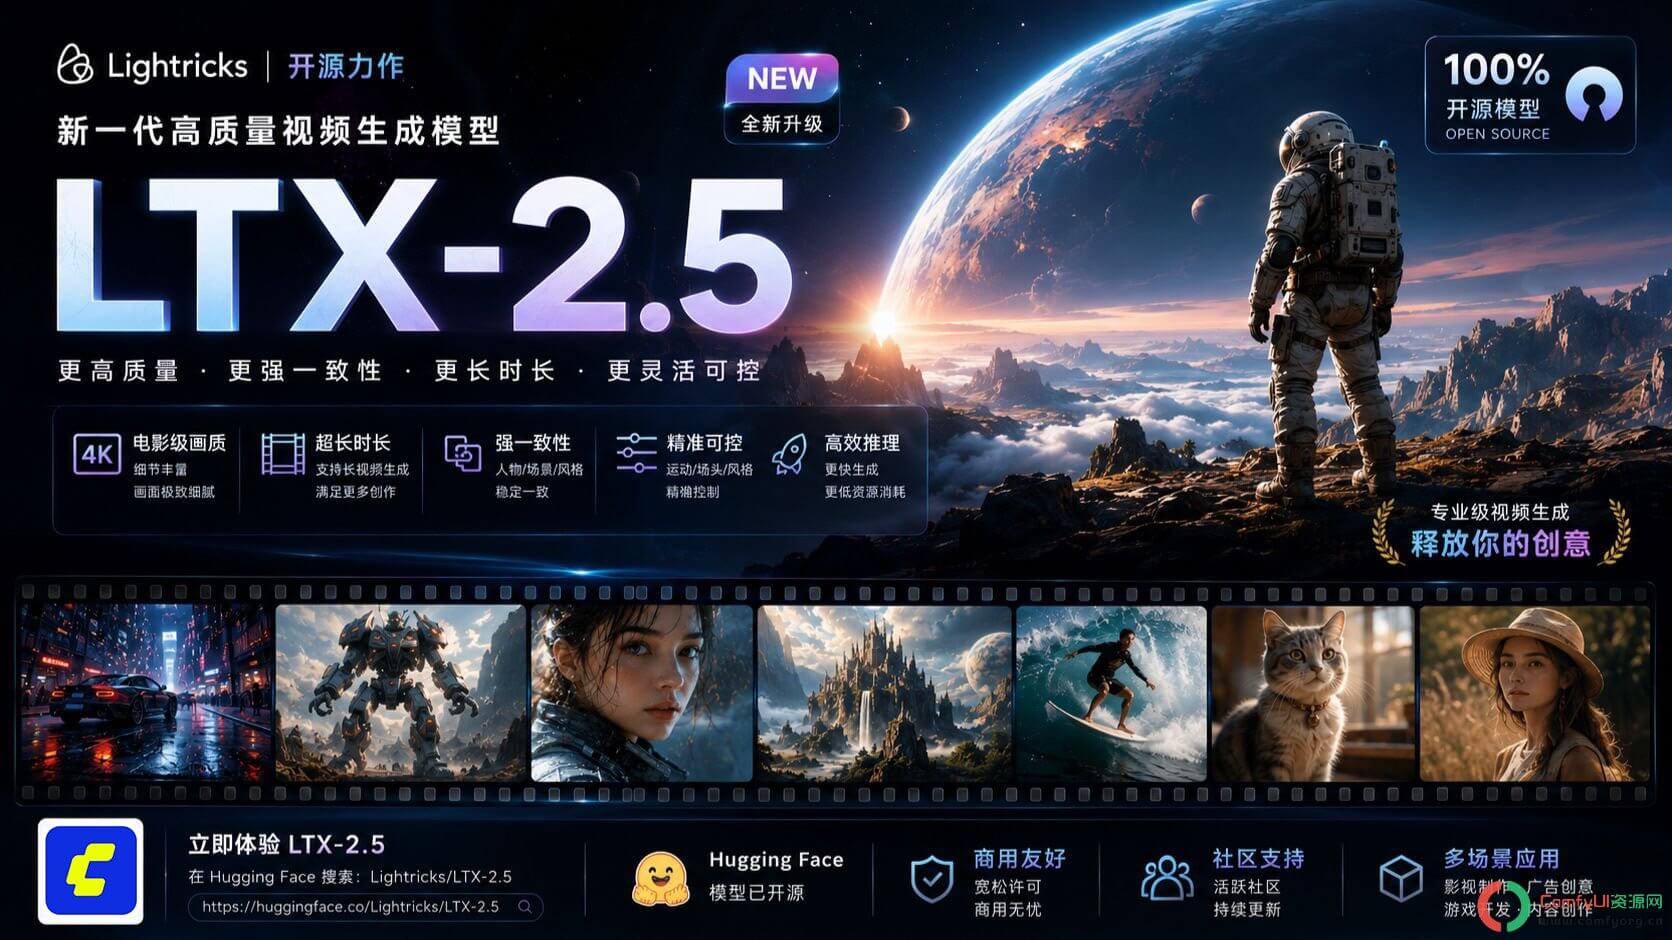
全新多镜头支持让创作者可生成跨越多个剪辑镜头的连续片段,且保持内容连贯性;升级后的扩散视频解码器可提升画质保真度并减少伪影。创作者还可通过生成式编辑优化现有素材,无需从头开始制作,便可更轻松地修正细节并保持精致统一的视觉效果。
- 新型扩散视频解码器:在保持高压缩比的同时,减少高动态画面伪影,提升文本和面部细节的重建质量。
- 原生多镜头生成:将完整序列渲染为单一输出,确保角色、场景和声音在剪辑间的一致性,避免拼接痕迹。
- 定制化语言骨干网:采用定制的 Gemma 4 及专用提示词增强器,更精准地处理复杂的多主体提示词。
- 物理 AI 与机器人优化:提供针对非电影领域数据微调的预训练检查点,服务于机器人技术等实时应用场景。
- 高效蒸馏模型:经 NVIDIA 优化,可在 RTX GPU 上本地运行且内存需求更低,以较低成本提供接近全模型的质量。
二、相关安装
三档模型文件:
| 版本 | 文件名标识 | 用途 |
|---|---|---|
| 🏋️ Dev 完整版 | -dev-transformer-bf16 | 完整 DiT,可训练/微调,最高质量 |
| ⚡ Distilled 蒸馏版 | -distilled-transformer-bf16 | 固定 8 步推理,CFG=1,速度快 |
| 🔧 ComfyUI 量化版 | -comfy-int8-convrot | INT8+ConvRot 量化,仅限 ComfyUI 使用 |
| 🔵 NVFP4 版 | -nvfp4 | Blackwell 专属,同质量更快 |
VAE 也有两套可选:
| VAE 版本 | 特点 |
|---|---|
| DiffVAE (-video-vae-bf16) | 更高质量,文件更大 |
| Conv VAE (-video-vae-conv-bf16) | 更快更轻量 |
模型路径
ComfyUI/
├── 📂 models/
│   ├── 📂 diffusion_models/
│   │   └── ltx-2.5-22b-distilled-transformer-comfy-int8-convrot.safetensors
│   ├── 📂 text_encoders/
│   │   ├── gemma4-12b-with-proj-ltx-2.5-comfy-int8-convrot.safetensors
│   │   └── gemma4_e2b_it_bf16.safetensors
│   ├── 📂 vae/
│   │   ├── ltx-2.5-video-vae-bf16.safetensors
│   │   └── ltx-2.5-audio-vae-bf16.safetensors
│   └── 📂 latent_upscale_models/
│       └── ltx-2.5-latent-spatial-upscaler-x2-bf16-1.0.safetensors
三、工作流
云端工作流:https://www.runninghub.cn/post/2088281770851651585
Minimax H3和LTX-2.5工作流如何选
你的显存多大?
如果你只有 8GB 显存
两个都能跑,但策略不同。 MiniMax H3 是经过我们实测验证的成熟方案——配合 INT4 量化 + 加速 LoRA,5 秒视频 5~6 分钟,10 秒视频 13 分钟,稳。LTX-2.5 通过 ComfyUI INT8-convrot 量化版 + CPU offload 也能跑(LTX-2.3 社区已验证),但 8GB 单卡上的实际速度不可能达到官方双 GB200 的 6.8 秒,建议先观望社区实测数据再入坑。
如果你有 16GB 显存
两者都能跑,但定位完全不同。 H3 做数字人、口播、人物一致性项目;LTX-2.5 做快速素材、高分辨率风光片、首尾帧动画。LTX-2.5 如果爆显存,加
--quantization fp8-cast --offload cpu降级运行。建议两者都装,按需切换。如果你有 24GB+ 显存
成年人全都要。 H3 用 INT8/BF16 版本追求极致质量,LTX-2.5 做批量快速产出。两者互补,覆盖 95% 的视频生成需求。
如果你是团队/公司
LTX-2.5 的商用协议非常友好——年收入 $1000 万以下完全免费,支持在自己的硬件上跑,允许在客户数据/IP 上微调。对于中小团队,这是巨大的成本优势。H3 更多依赖社区量化版本,商业使用需要自行确认授权。
一图看懂:核心参数对比:
| 维度 | 🎬 MiniMax H3 | ⚡ LTX-2.5 |
|---|---|---|
| 发布时间 | 2026 年 7 月 | 2026 年 8 月 11 日 |
| 开发商 | MiniMax(中国) | LTX / Lightricks(以色列) |
| 模型定位 | 全参考多模态视频生成 | 视频+音频+世界模拟(含物理 AI 分支) |
| 基础架构 | 自研 Transformer | DiT 22B(22B 参数 Transformer) |
| 文本编码器 | Qwen3VL 32B(多模态) | Gemma 4 12B(定制文本编码器) |
| 视频解码器 | VAE(fp16/fp32) | DiffVAE(高质量)/ Conv VAE(快速轻量) |
| 最低显存 | 🟢 8 GB(量化版,实测可行) | 🟢 8 GB(LTX-2.3 社区已验证 8GB 可跑,2.5 同样适用;bf16 官方建议 16GB,可通过量化+offload 降低) |
| 最高分辨率 | 864×480(8GB 实测稳定) | 🔴 4K(两阶段:低分辨率生成 + 2× 空间超分) |
| 最长时长 | 10 秒(8GB 实测上限) | 🔴 20 秒(720p/1080p, 24/25 fps) |
| 帧率 | 24 fps | 24 / 25 / 48 / 50 fps |
| 生成速度 | 5~13 分钟/条(8GB + LoRA) | 🔴 6.8 秒(双 GB200)/ 23.7 秒(API) |
| 输入类型 | 文本 + 图片 + 视频 + 音频 | 文本 / 图片 / 首尾帧 |
| 音频输出 | ✅ 原生音频 | ✅ 48kHz 同步音频(原生集成声码器) |
| 多镜头一致性 | ✅ 全参考模式天然支持 | ✅ Native Multishot(单次生成连贯多镜头) |
| 提示词增强 | 需外部 Agent 加工 | ✅ 内置提示增强器 + 时长预测器 |
| 量化方案 | 🟢 INT4 / INT8 / NVFP4 / MIXED | 🟢 ComfyUI 专属 INT8-convrot / NVFP4 |
| 低显存方案 | –lowvram 参数 | --quantization fp8-cast --offload cpu |
| 开源协议 | 社区量化合集(需自行确认商用) | 开源权重,年收入 $1000 万以下完全免费商用 |
| ComfyUI 支持 | ✅ 社区工作流成熟 | ✅ 首发原生集成,官方模板 |
| LoRA 兼容 | 加速 LoRA 生态成熟 | ✅ 兼容 LTX-2.3 训练的 LoRA |
| Python API | 依赖 ComfyUI 生态 | ✅ 原生 ltx-pipelines + Diffusers |
| 物理 AI | ❌ 不支持 | ✅ 专用 Physics AI 检查点 |
四、结语:快,只是开始
LTX-2.5 的核心价值,不在于 6.8 秒这个数字本身。而在于它证明了一件事:AI 视频生成的速度瓶颈正在被快速突破。
当生成速度赶上甚至超过观看速度时,整个创作流程都会被重新定义。你不需要再等待,可以随时调整,随时重试。这种即时反馈,会让创作变得更加自由。
未来会怎样?也许很快,我们就能看到 1080P、甚至 4K 分辨率的实时视频生成。也许很快,AI 视频工具会变得像修图软件一样普及。到那时候,"会用 AI 生成视频"可能会成为一项基本技能。
3060 明显不够用啊
谢谢大神!😁