


一、MiniMax H3介绍
MiniMax H3是一个通用型全模态生成系统,可统一理解文本、图像、视频和音频组成的多模态上下文,生成最长15秒、最高2K分辨率并带有原生立体声音频的视频。
MiniMax 正式发布新一代通用全模态生成模型 MiniMax H3,作为品牌首款计划开源的多模态视听生成模型,H3 将文本模型成熟的推理、上下文技术迁移至视频生成领域,面向开发者与商业场景提供一体化音视频生成能力。
模型核心技术特点
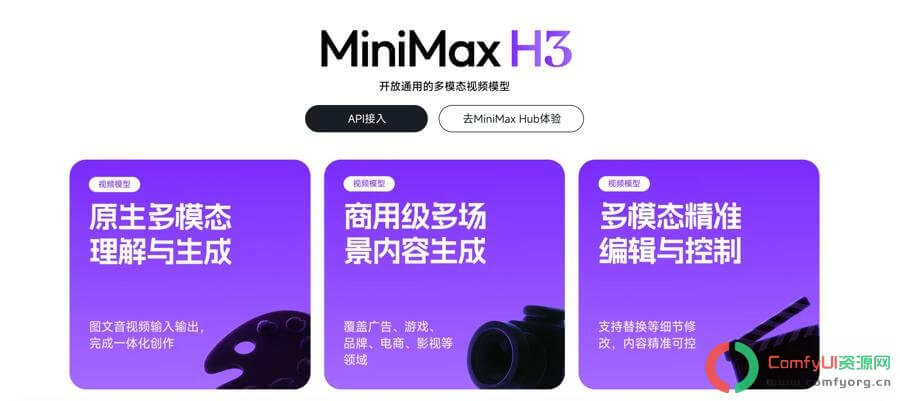
- 统一多模态理解管线 原生支持文本、图像、短视频、音频混合输入,统一编码多模态上下文,支持参考素材联动生成、视频动作迁移(V2V)。
- 创新画面生成方案 不依赖传统后置超分,采用模型自生成方式提升分辨率,更好保留画面结构、文字细节,改善 AI 视频常见文字崩坏问题。
- 架构复用文本模型成熟方案 引入复杂指令拆解、上下文扩展、Muon 优化器等经过验证的技术,提升长提示词、复杂指令的遵循能力。
二、相关安装
模型安装路径
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 vae/
│   │   ├── minimax_h3_video_vae_fp16.safetensors
│   │   └── minimax_h3_audio_vae_fp32.safetensors
│   ├── 📂 diffusion_models/
│   │   └── minimax_h3_ref2va_pruned_int8_convrot.safetensors
│   └── 📂 text_encoders/
│       └── qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors
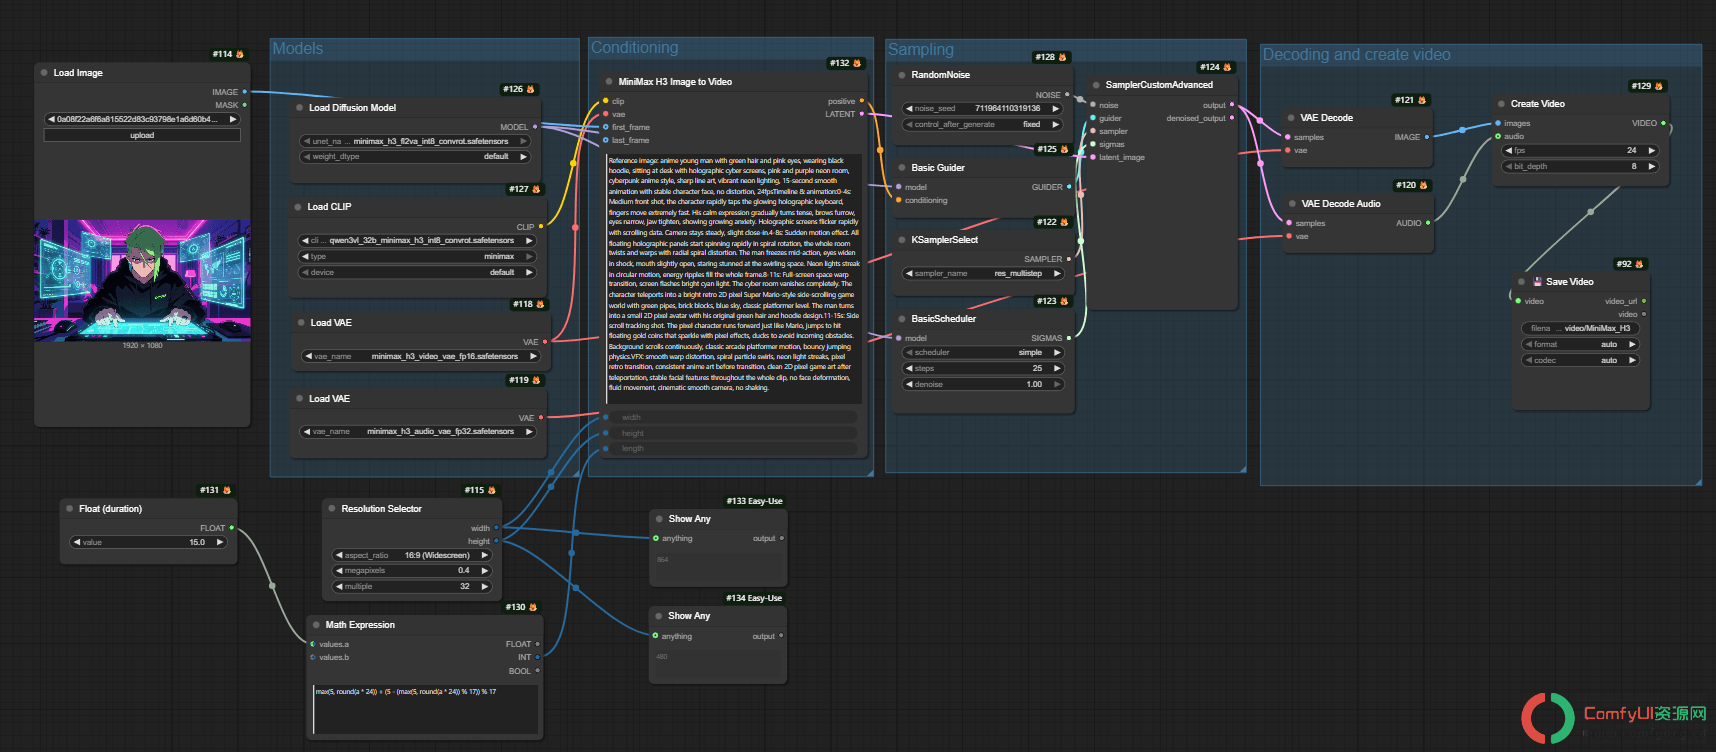
三、工作流
四、结语:全模态视频生成加速走向开放生态
从实际效果来看,MiniMax H3已经能够处理自然风光、商业广告等不同类型的生成任务,在画面自然度、镜头组织和风格一致性方面展现出较高的完成度。MiniMax H3将业内多模态模型的竞争进一步带向效果、成本、开放性与生态协同的综合维度,丰富了模型企业与国产AI芯片软硬件协同生态。与此同时,MiniMax多模态路线进入了模型能力、训练效率、开源生态和行业应用协同推进的新阶段。
MiniMax H3此次开源不仅开放了模型能力,也初步打通了从模型下载、本地部署到应用开发的生态链路。全模态视频模型之间的竞争,正从单一画面效果进一步延伸至声音生成、复杂指令理解和产业生态建设。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
这个3080ti 16g 跑一次要多久啊
感谢分享,学习一下
这个测试后,于sd2.0差多少?
用示例工作流能跑完,时间只有12秒按提示词中的设定,把时长改成15s,跑完后,最后3s是花屏?啥问题
这个测试👍
我要去试试
3060ti8G显存可以用吗?
感谢分享
感谢感谢!!!