


7月23日下午,Black Forest Labs(BFL)在社交媒体上扔下一枚重磅炸弹:正式发布多模态模型FLUX 3,覆盖图像、视频、音频与动作预测四大模态。这条推文在短时间内获得57.6万次浏览、238条回复与676次转发。官方明确将枪口对准Seedance 2.0、Gemini Omni和Grok Imagine,声称FLUX 3的输出“在每一种风格上都更加真实”。
与多数实验室分别训练不同模态的路线不同,FLUX 3在一个统一架构下完成联合训练。官方博客以“Self Flow”为名,罗列了多项核心能力,且所有输出均附带原生音频生成。具体包括:文生视频、图生视频(既可从起始帧延续动画,也可利用图像作为视觉参考)、视频生视频(在保留源视频核心元素——比如同一角色——的前提下生成新场景)、基于输入视频和音频的生成式音画延续、关键帧到视频的受控过渡、多语言对话、远超常规影视输出的广泛视觉风格和长宽比,以及将单个片段链式组合为更长多镜头序列的智能体化能力。
其中,几项功能原本是少数前沿实验室的独占本领。BFL特意强调FLUX 3能轻松驾驭从手持DV记录到动画、电影级影像的多元风格,并具备强排版生成和动态文字设计能力。这意味着风格多样性已不再专属于某一两家闭源模型,社区已经注意到,这里出现了一个独立、且可能达到顶尖水平的复现版本,并且官方承诺将放出开放权重的开发版。
01 一个模型,四种能力
FLUX 3 的核心思路是:在同一个架构里同时训练图像、视频和音频,而不是像过去那样分别训练三个模型再拼到一起。它基于 Black Forest Labs 此前提出的 Self-Flow 方法——一种在同一架构内高效对齐多模态生成与理解的技术,通过大幅扩大计算量和数据规模,最终实现了跨模态的联合训练。
为什么要把这些模态放在一起学?Black Forest Labs 的逻辑很清晰:每种模态都是对同一个现实的不同投影,各自丢失了不同的信息。图像捕捉空间结构,视频恢复时间维度并揭示物理规律,音频则暴露了视觉无法捕捉的因果关系——比如锤子砸下去的声音要和画面里的冲击同步。语言则把这些感知与目标、指令连接起来。
单独学一个,你只能得到那个投影的好模型。一起学,模态之间的互相约束会告诉你更多:声音必须匹配撞击,运动必须服从质量,未来必须从过去推导。
基于这个架构,FLUX 3 被拆分为四条产品线:
FLUX 3 Video
文本/图像/视频生成最长 20 秒的视频,原生同步音频,支持多语言对话
FLUX 3 Image
图像合成与编辑,多语言文字渲染,复杂提示词处理能力显著提升
FLUX 3 Action
动作预测,面向机器人操控,已在奥迪工厂进入生产测试
FLUX 3 Dev
开源权重版本,覆盖视频/音频/图像及动作预测,计划 2026 年晚些时候发布
02 视频:这次带了原生音频
FLUX 3 Video 是目前最早开放的能力,也是最受关注的部分。它能一次生成最长 20 秒的视频,而且自带原生音频——对话、音效、环境噪音都与画面同步。这在当前的视频生成领域仍然是一个痛点,大多数模型还需要额外的音频生成步骤来做后期拼接。
具体来说,FLUX 3 Video 支持:
• 文生视频、图生视频(从起始帧延续或用图片作为视觉参考)
• 视频转视频(将源视频的核心元素带入新场景)
• 关键帧到视频(在定义好的时刻之间生成过渡)
• 多语言对话生成
• 多片段链式拼接成长序列,并通过视觉参考保持角色一致性
• 从写实摄影机风格到动画和电影感的广泛风格跨度
• 强大的排版生成和动画设计能力
03发布节奏:别急着用,还没完全开放
虽然 FLUX 3 的愿景很宏大,但目前的实际可用范围比宣传的要窄。Black Forest Labs 采取的是分阶段开放策略:
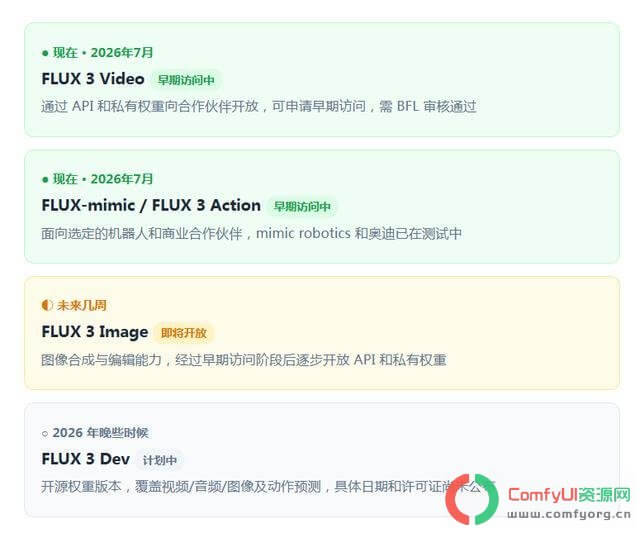
开源权重版本,覆盖视频/音频/图像及动作预测,具体日期和许可证尚未公布
几个需要冷静看待的事实
基准数据是自评的。所有偏好率都来自 BFL 自己的测试,用的是自己选的对比模型和提示词,BFL 自己也标注为初步结果。
设计师最关心的图像功能还没开放。FLUX 3 Image(直接对标 Midjourney 的静态图像生成)明确标注「未来几周」推出,目前能用的只有视频和动作预测。
开源权重是承诺,不是现在。FLUX 3 Dev 没有发布日期、许可证条款或模型大小信息。习惯了 FLUX.1 开源生态的开发者目前没有可以本地部署的东西。
没有公布定价。任何一个层级的价格都尚未披露。
04 这意味着什么
FLUX 3 的发布本质上是 Black Forest Labs 下了一个判断:视频生成和机器人动作预测,在很大程度上是同一个问题。一个能预测视频下一帧的模型,已经在练习机器人预测下一个物理动作所需的大部分世界理解。
这是一个有意思的赌注。如果成立,一次昂贵的视频模型训练就能同时服务创意软件和工业机器人两个市场——Black Forest Labs 的视频训练消耗了 FLUX 3 超过 95% 的计算量,如果能把这些表征复用到机器人控制上,这笔投入的回报就翻倍了。
从行业角度看,FLUX 3 也是一种信号:AI 的竞争正在从语言模型扩展到更广泛的「视觉智能」——不只是生成好看的图和视频,而是理解物理世界的运作方式。Robin Rombach 和他的团队显然认为,谁先在这个方向上跑通,谁就拿到了下一张入场券。
但现在下结论为时过早。BFL 的对比数据是自评的,FLUX 3 Image 还没上线,开源权重是今年晚些时候的承诺而非现实,奥迪的机器人测试也还是生产测试阶段而非全面部署。统一架构的赌注是否真的能跑赢专门化的视频模型和专门的机器人学习方案,未来几个月才是真正的检验期。
这条新闻的价值在于:它是一个起点,而不是一个结果。Stable Diffusion 之父的新一局棋,正式开始了。
从 Stable Diffusion 到 FLUX.1 再到 FLUX 3,Robin Rombach 的路线图始终清晰:从静态图像到动态视频,从生成内容到理解世界,从数字创作到物理操控。FLUX 3 是这条路线上第一个真正意义上的多模态里程碑。
至于它能否兑现,我们保持关注。
模型申请地址
🔗 官方资料
模型页:https://bfl.ai/models/flux-3
FLUX-mimic:https://bfl.ai/blog/flux-3-mimic
Self-Flow:https://bfl.ai/research/self-flow
立即尝鲜:https://bfl.ai/