


一、Wan Dance是什么?
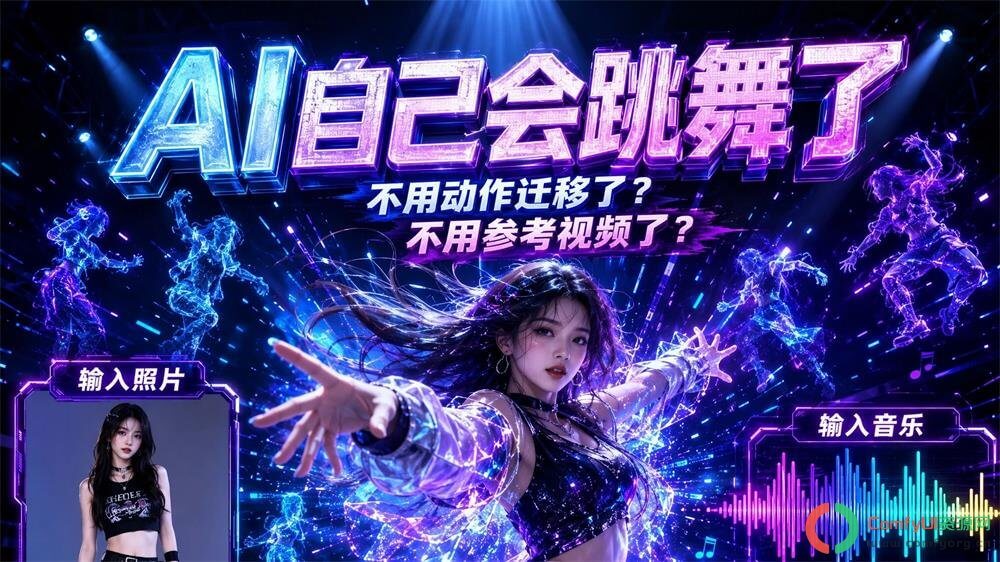
Wan-Dancer是阿里通义万相开源的音乐驱动人像舞蹈视频生成模型,参数量达140亿,可根据输入音乐自动生成与节拍匹配的人物舞蹈视频,支持输入单张人物照片与音频,自动生成15 秒至 3 分钟、节拍精准对齐的高清连贯舞蹈视频 。
-
音乐驱动舞蹈生成:输入人物照片与音乐,自动生成与节拍精准对齐的舞蹈视频。
-
分钟级长视频生成:突破传统 20 秒限制,稳定生成 15 秒至 3 分钟的连贯高清视频。
-
多风格舞蹈覆盖:支持中国古典舞、K-Pop、街舞、踢踏舞、拉丁舞五种差异显著的风格。
-
LoRA 个性化定制:仅需少量特定舞蹈数据即可训练专属动作风格,实现同款舞蹈复刻。
-
关键帧二次编辑:全局阶段生成的关键帧支持手动修改,实现换装与动作精细控制。
该模型主要应用于虚拟偶像制作、短视频素材生成、电商展示等场景,无需专业舞蹈拍摄即可定制高质量舞蹈内容 。
二、相关安装
插件还会用KJ的 ComfyUI-WanVideoWrapper 插件,老玩家基本都有。
插件地址: https://github.com/kijai/ComfyUI-WanVideoWrapper
相关模型已经放网盘了, 到时候大家自取,提供了T2V和I2V两种模型。
模型路径
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 diffusion_models/
│   │   ├── wan2.2_dancer_14b_global_fp8_scaled.safetensors
│   │   └── wan2.2_dancer_14b_local_fp8_scaled.safetensors
│   ├── 📂 loras/
│   │   └── lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors
│   ├── 📂 text_encoders/
│   │   └── umt5_xxl_fp16.safetensors
│   ├── 📂 clip_vision/
│   │   └── clip_vision_h.safetensors
│   └── 📂 vae/
│ └── Wan2_1_VAE_bf16.safetensors三、WanDance工作流
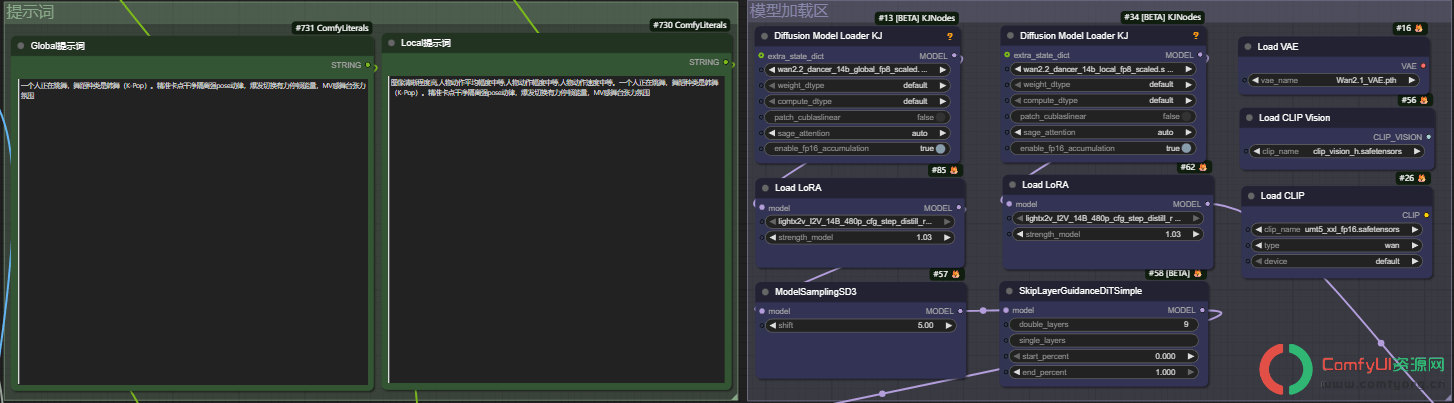
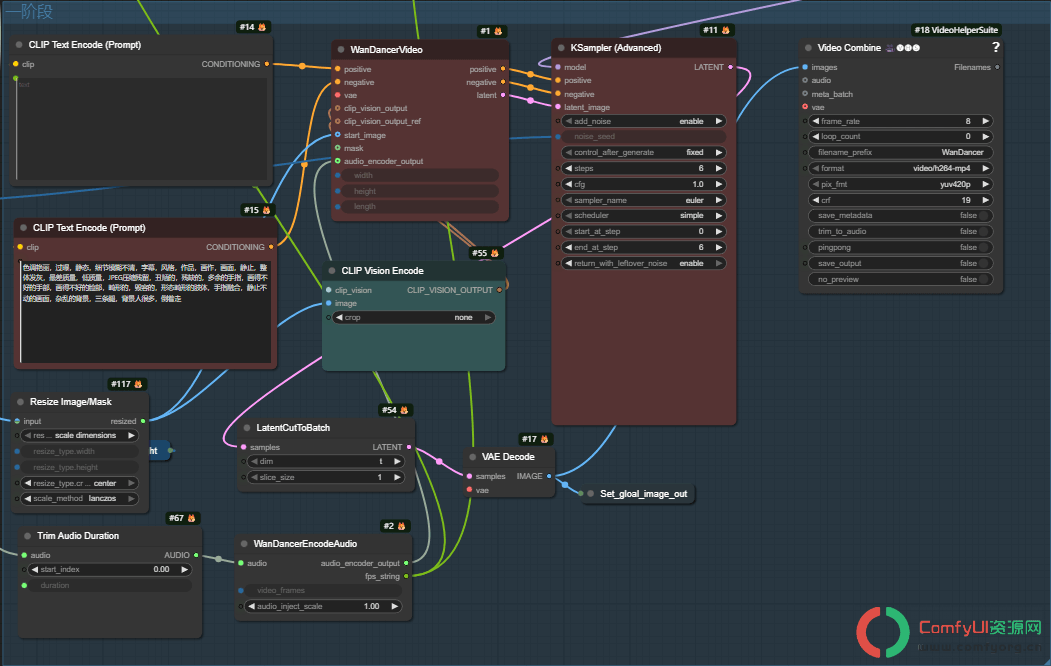
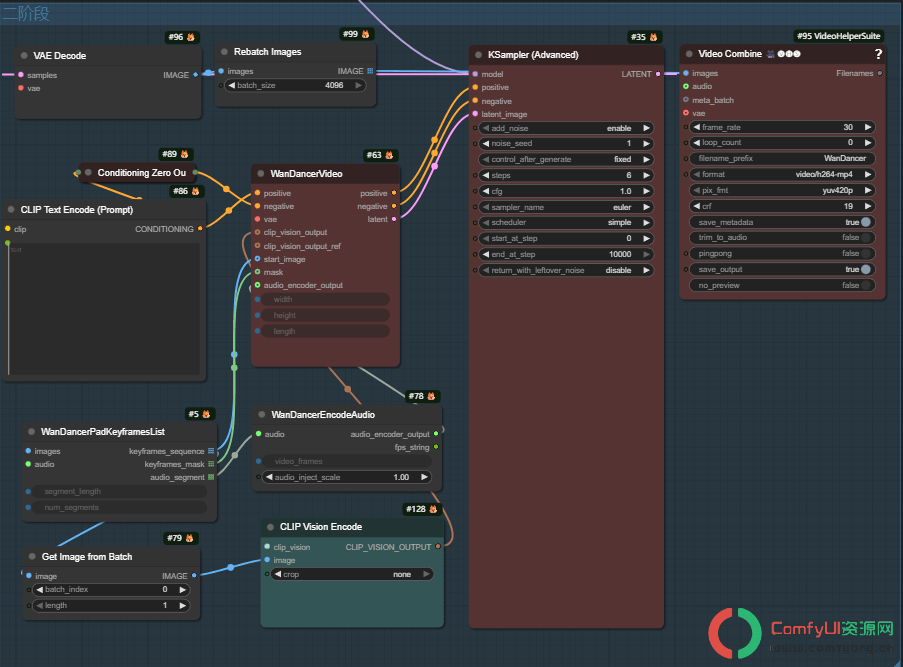
效果预览
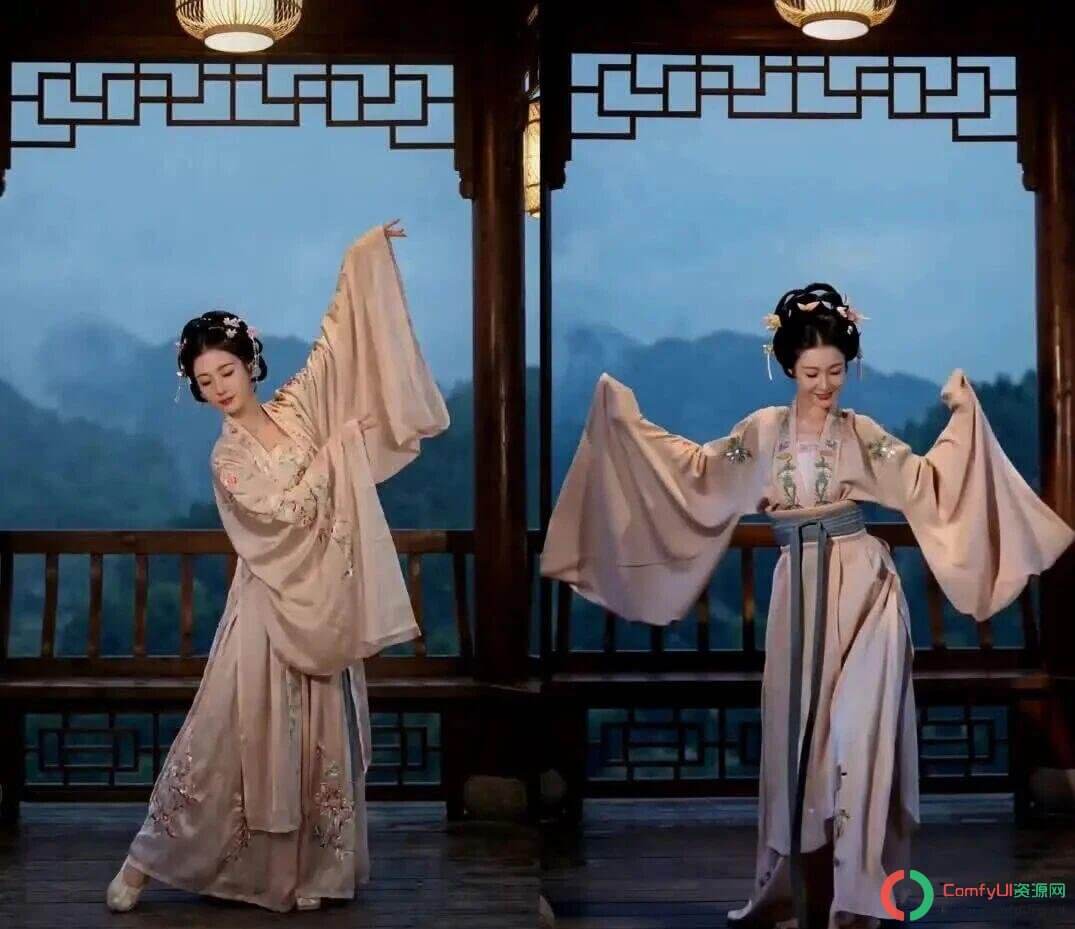
四、Wan-Dancer总结
Wan-Dancer 是阿里通义万相开源的音乐驱动人像舞蹈生成模型,其核心意义在于首次突破 AI 舞蹈视频“分钟级”生成瓶颈,通过分层解耦架构解决了长时序下的节奏错位、身份漂移与动作重复三大难题 。
- 短视频内容创作:为抖音、快手、小红书等平台快速生成个性化舞蹈视频,无需真人出镜即可实现风格多样的舞蹈内容量产。
- 虚拟偶像与数字人表演:为直播、虚拟演唱会及数字人账号定制特定舞种的连贯表演素材,降低虚拟角色舞蹈动作的制作成本。
- 舞蹈教学与编舞辅助:借助音乐节拍对齐与关键帧预览功能,辅助舞蹈教师拆解动作节奏、设计编舞方案,并生成标准化教学演示视频。
- 广告与影视预演:低成本生成分镜级别的舞蹈镜头预览,帮助导演与创意团队在拍摄前快速验证舞蹈编排与视觉风格,加速决策流程。
核心突破与价值
- 时长跨越:将生成上限从行业普遍的20 秒左右提升至 15 秒 -3 分钟(实测可达 160 秒+),实现整首歌曲的连贯编舞输出 。
- 架构创新:首创"全局关键帧规划 + 局部时序细化"两阶段范式。先基于全曲音乐规划宏观骨架(防漂移),再填充微观细节(保流畅),从根本上抑制误差累积 。
- 多风格覆盖:原生支持中国古典舞、K-Pop、街舞、踢踏舞、拉丁舞五种差异显著舞种,且支持 LoRA 低资源微调实现个性化动作复刻 。
- 技术标杆:引入 Time-mapped RoPE 动态帧率适配与光流损失约束,确立了长序列视频生成中“先结构后细节”的新技术路径,为影视预演、数字人演艺提供低成本解决方案 。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
缺少插件 KepStringLiteral KepStringLiteral
提示错误“ModuleNotFoundError: No module named 'sageattention'”