


一家叫 Empero AI 的独立研究机构,发布了一个开源模型 Qwythos-9B,并且在模型介绍页上明确写着——它的训练数据来自 Claude Mythos 和 Claude Fable 的输出。
公开承认用闭源商业模型的输出来训练开源模型,这件事本身就够刺激了,更何况 Anthropic 的服务条款明确禁止这种做法。消息一出,评论区两极分化:有人觉得这是开源社区对闭源模型护城河的一次正面冲击,也有人觉得这就是赤裸裸的条款违规。
不管你怎么看这件事,Qwythos-9B 作为一个可以本地运行的 9B 推理模型,技术参数上确实有值得关注的地方。这篇文章把它是什么、争议在哪、以及怎么在 Windows 上跑起来,一次说清楚。
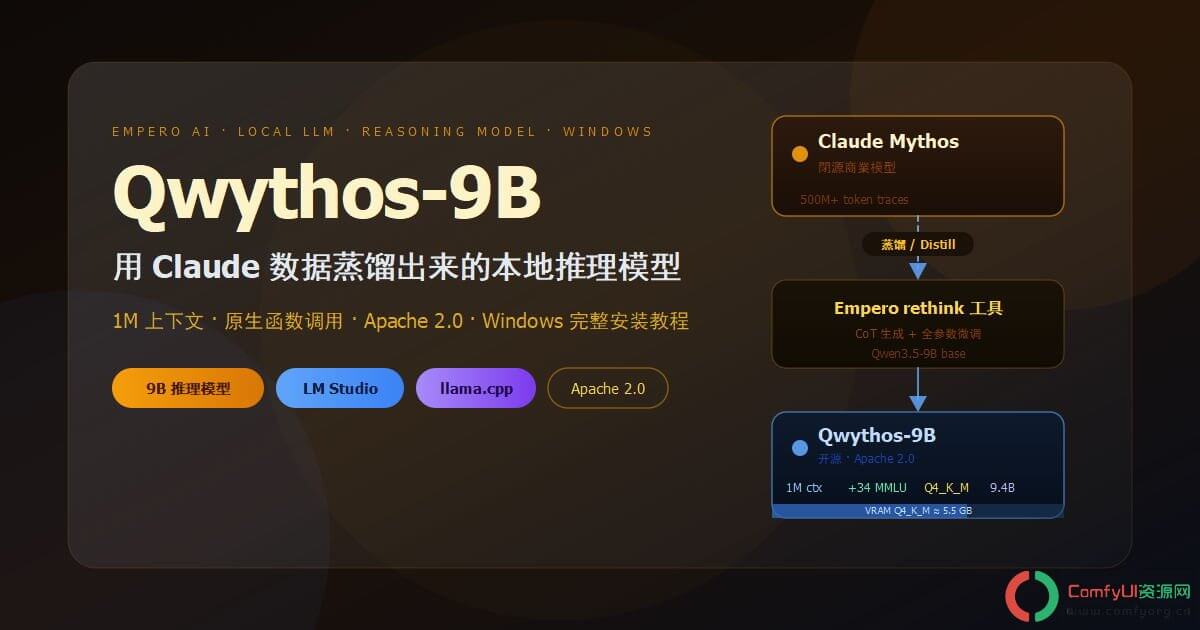
Qwythos-9B 是什么
Empero AI 是一家独立 AI 研究机构,主打开源、开放权重和开放数据集。Qwythos-9B 是他们目前的旗舰模型,基于 Qwen3.5-9B 做了全参数微调。
几个关键参数:
- 参数量:9.4B
- 上下文窗口:1,048,576 token(约 1M),通过 YaRN rope-scaling 实现,默认已启用,无需额外配置
- 推理模式:每条回复都会先生成一个
<think>...</think>推理过程块,再给出最终答案 - 原生函数调用:兼容 Qwen3.5 规范,无需额外包装
- 许可证:Apache 2.0,允许商用
基准测试方面,在相同评测条件下,Qwythos 比基础的 Qwen3.5-9B 高出 34 分 MMLU、30 分 gsm8k-strict、19 分 gsm8k-flex。这个提升幅度对一个 9B 模型来说不算小。
核心特性
- Claude 风格推理: 基于 Qwen3.5-9B 架构,利用超过 5 亿条高质量推理轨迹进行后训练,具备完整的思维链(Chain of Thought)表现。
- 百万级上下文: 原生支持 1,048,576 Token 超长上下文窗口,适用于长文档分析、代码库阅读及复杂 Agent 工作流。
- 极致轻量: 提供 GGUF 格式,支持多种本地部署工具,最低仅需 4GB 显存即可运行。
- 多模态能力: 同步发布视觉投影文件,支持图片分析、OCR 及图表理解。
- 标准兼容: 支持原生 Function Calling,可直接对接各类工具与 Agent 系统
安装前先确认你的硬件
Qwythos-9B 对硬件的要求和其他 9B 模型基本一致。
FP16 全精度需要约 21GB VRAM,普通消费级显卡跑不了。实际使用更推荐量化版本:
- Q4_K_M(推荐起点):约 5-6GB VRAM,质量损失最小,是官方推荐的入门量化
- Q8_0:约 10GB VRAM,质量更接近原始精度
- 纯 CPU 运行:可行,但速度会慢很多,8B 级别模型 CPU 推理通常在 1-5 token/秒
显卡参考:RTX 3060 12GB / RTX 4060 8GB 及以上运行 Q4_K_M 都没问题。
Qwythos 提供 GGUF 版本,推荐使用 llama.cpp、OpenWebUI、Cherry Studio 或 OpenClaw 进行部署。
显存需求参考:
| 推荐量化版本 | 建议显存 |
|---|---|
| Q4_K_M | 4GB |
| Q5_K_M | 6GB |
| Q6_K | 8GB |
| Q8_K_M | 12GB |
| BF16 (全精度) | 24GB |
Qwythos-9B 目前不能直接用 Ollama 的 ollama run 命令跑。
原因是 Qwen3.5 架构的 GGUF 包含独立的视觉投影文件(mmproj),Ollama 目前对这类文件的支持还不完整。如果强行用 Ollama 加载,大概率会报错或行为异常。
推荐的两条路:
- LM Studio(推荐新手):图形界面,直接从 HuggingFace 搜索下载,点几下就能跑
- llama.cpp + 一键启动脚本(推荐进阶用户):更灵活,支持视觉模型,参数可以精细控制
快速部署步骤
(1)下载Qwythos模型:
- Huggingface:魔法上网下载
- 夸克网盘:【文末下载】
(2)安装llama.cpp
- GitHub 下载【点击前往】
- 夸克网盘:【文末下载】内含启动脚本
(3)一键启动脚本:(文末下载)
- 设置目录: 在本地创建
models文件夹,并将下载的模型文件存入其中。 - 运行环境: 使用
llama-server启动服务,监听本地端口(如127.0.0.1:8080),即可通过 OpenAI 兼容接口连接至你的前端工具。
目录结构
把所有文件放在同一个 llama.cpp 目录下,结构如下:
llama-b9782-bin-win-cuda-13.3-x64\
├── llama-server.exe
├── 启动.bat          ← 启动脚本
└── models\
    ├── Qwythos-9B-...-Q4_K_M.gguf     ← 主模型
    └── mmproj-Qwythos-...-f16.gguf    ← 视觉投影文件(可选)
双击运行,会自动扫描 models\ 里的文件,然后让你选显卡 VRAM 对应的 Context 档位,选完就自动启动。
http://127.0.0.1:8080
支持所有兼容 OpenAI API 格式的客户端,包括 OpenWebUI、Cherry Studio、Claude Code、OpenClaw 等。在客户端里新增一个自定义 API,地址填上面这个,模型名称填 qwythos 或留空,就可以开始对话了。
关于 1M 上下文,实际能用多少
模型支持 1M token 上下文是真的,但在消费级硬件上用满这个窗口几乎不现实——KV cache 的内存消耗会随上下文长度线性增长,16K token 的上下文在 8GB 显卡上已经需要留意 VRAM 余量了。
启动脚本里按显存大小给了推荐档位,实际使用建议:
- 日常对话和代码辅助:选 4GB 或 6GB 档,速度最快
- 分析长文档或大代码库:选 8GB 或 12GB 档
- 512K 档:需要 24GB 以上显存,普通消费卡基本跑不满
使用前提醒
Qwythos 是一个”无限制”(uncensored)模型,Empero AI 在模型卡上明确说明它会认真对待涉及网络安全、生物、药理等技术性问题,同时建议在面向终端用户的产品中自己加安全层。
另外,和所有这个参数量级的模型一样,它对具体标识符(CVE 编号、特定哈希模式、药物剂量等)的记忆可能不准确,对这类信息配合搜索或函数调用来验证,比直接信任模型输出更稳妥。