


一、Bernini 介绍
Bernini 是字节跳动商业化技术团队于 2026 年 6 月开源的统一视频生成与编辑框架,该框架核心主打“先理解、再生成”的协同机制,旨在有效解决传统模型由于无法精准理解复杂指令而导致的画面失控、帧间闪烁等行业痛点。
目前,Bernini在字节自建的测试中已稳居行业第一梯队。其推理代码与第二阶段模型Bernini-R的权限已正式放开,包含完整功能的全版本也将在近期迎来全面开放。
Bernini 先理解再生成技术原理
- 两阶段架构:采用 MLLM 语义规划与 DiT 视觉渲染的解耦架构,分为语义规划与视觉渲染两个独立阶段 。
- 协同机制:多模态大模型负责深度解析指令并规划语义草图,再由 Diffusion Transformer 完成高质量视频生成 。
项目主页:https://bernini-ai.github.io/
二、相关安装
ComfyUI-KJNodes:https://github.com/kijai/ComfyUI-KJNodes/
ComfyUI-WanAnimatePlus:https://github.com/wuwukaka/ComfyUI-WanAnimatePlus
ComfyUI-RH-Bernini:https://github.com/RH-RunningHub/ComfyUI-RH-Bernini-Full
● 8GB 显存:选 Q4 GGUF 模型(实测显存占用<6G)
● 8-16GB 显存:用 8Q GGUF 模型(平衡精度)
● 16GB+显存:直接上 FP8 完整精度模型(效果天花板)
ComfyUI/
├───📂 models/
│   ├───📂 diffusion_models/
│   │   ├─── Wan22_Bernini_LOW_fp8_e4m3fn_scaled.safetensors
│   │   └─── Wan22_Bernini_HIGH_fp8_e4m3fn_scaled.safetensors
│   ├───📂 loras/
│   │   └─── wan2.2_t2v_A14b_low_noise_lora_rank64_lightx2v_4step_1217.safetensors
│   │   └─── wan2.2_t2v_A14b_high_noise_lora_rank64_lightx2v_4step_1217.safetensors
│   │   └─── wan2.1_i2v_lora_rank64_lightx2v_4step.safetensors
│   ├───📂 text_encoders/
│   │   └─── umt5-xxl-enc-bf16.safetensors
│   └───📂 vae/
│ └── wan_2.1_vae.safetensors三、工作流
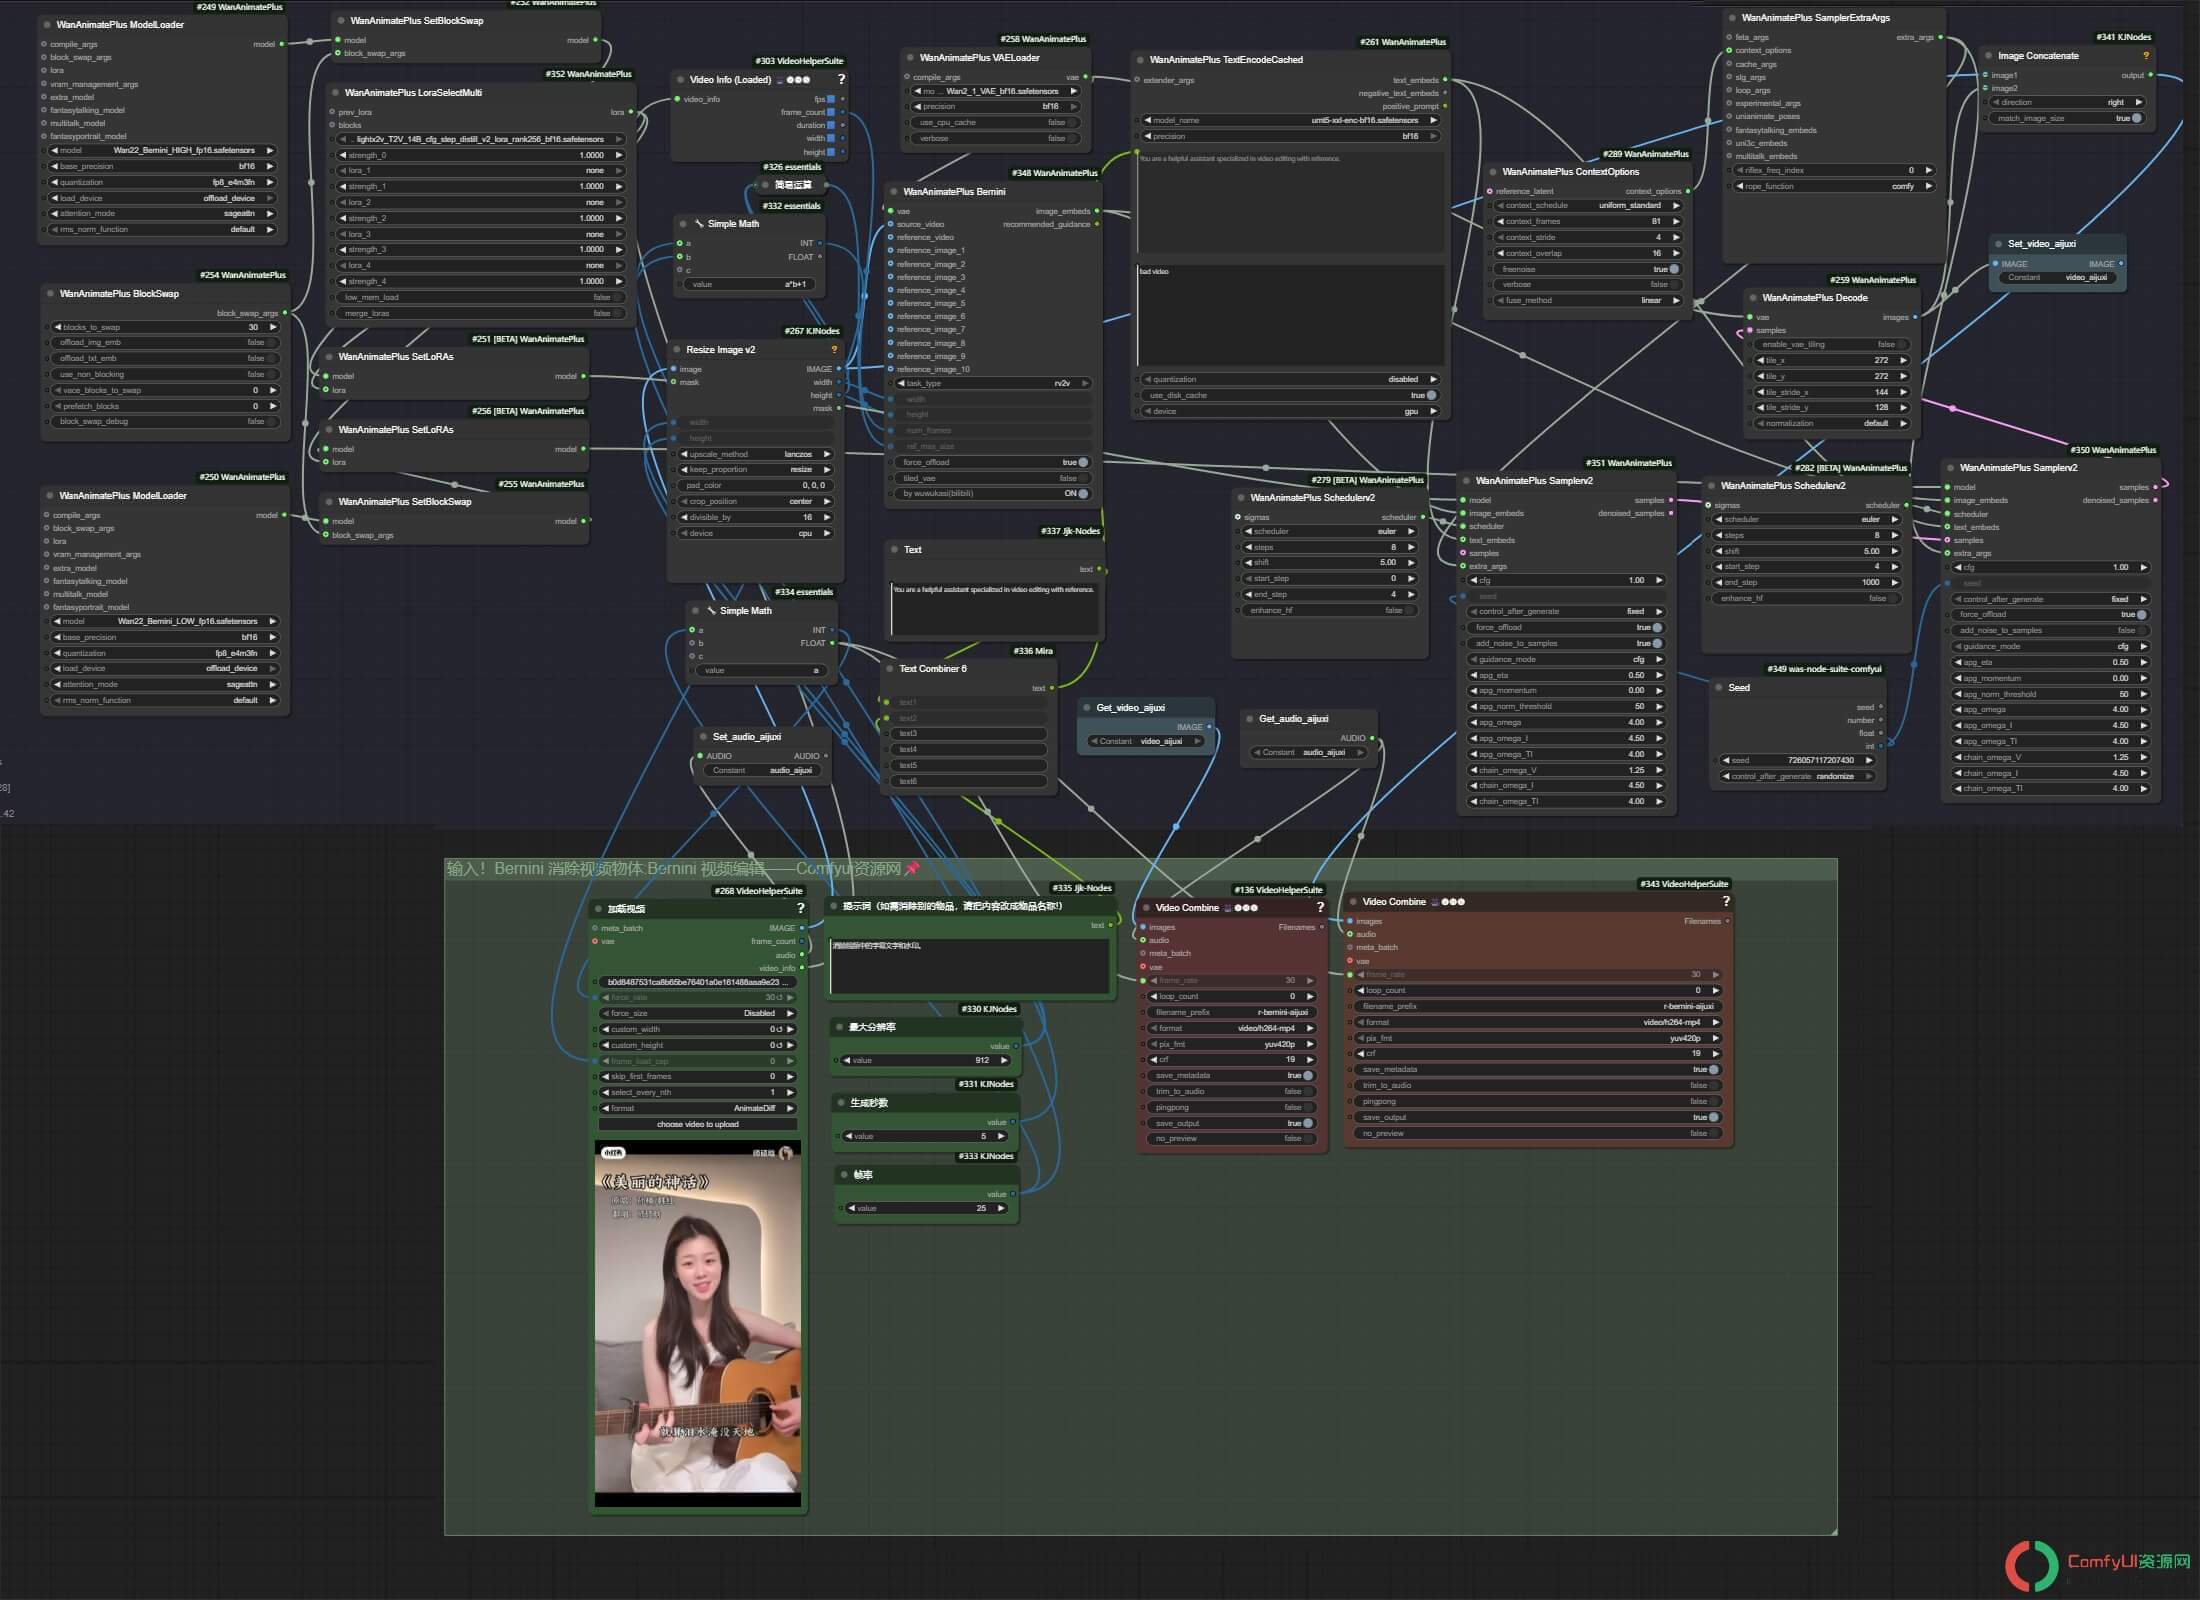
参数调优秘籍:拒绝玄学,科学出图:
1. 导演台核心参数设置
● CFG Scale:固定 4(平衡控制力与多样性,实测过高易失真)
● 采样步数:总 35 步(高噪 10 步+低噪 25 步)
2. 任务类型与提示词陷阱
● 必须选“Text to Image”任务类型!
3. 提示词工程:从“能用”到“惊艳”
● 使用结构化提示词模板:主题+风格+构图+细节修饰 例:赛博朋克风格的未来城市,霓虹灯光,空中飞车,超高清细节,电影级构图
● 推荐工具: AI 写作(辅助生成高质量提示词)
4. 后处理增效:细节放大神器
● 启用整合包内置的放大节点(如 R-ESRGAN 模型),将生成图分辨率提升至 4K,细节拉满,商用级效果。
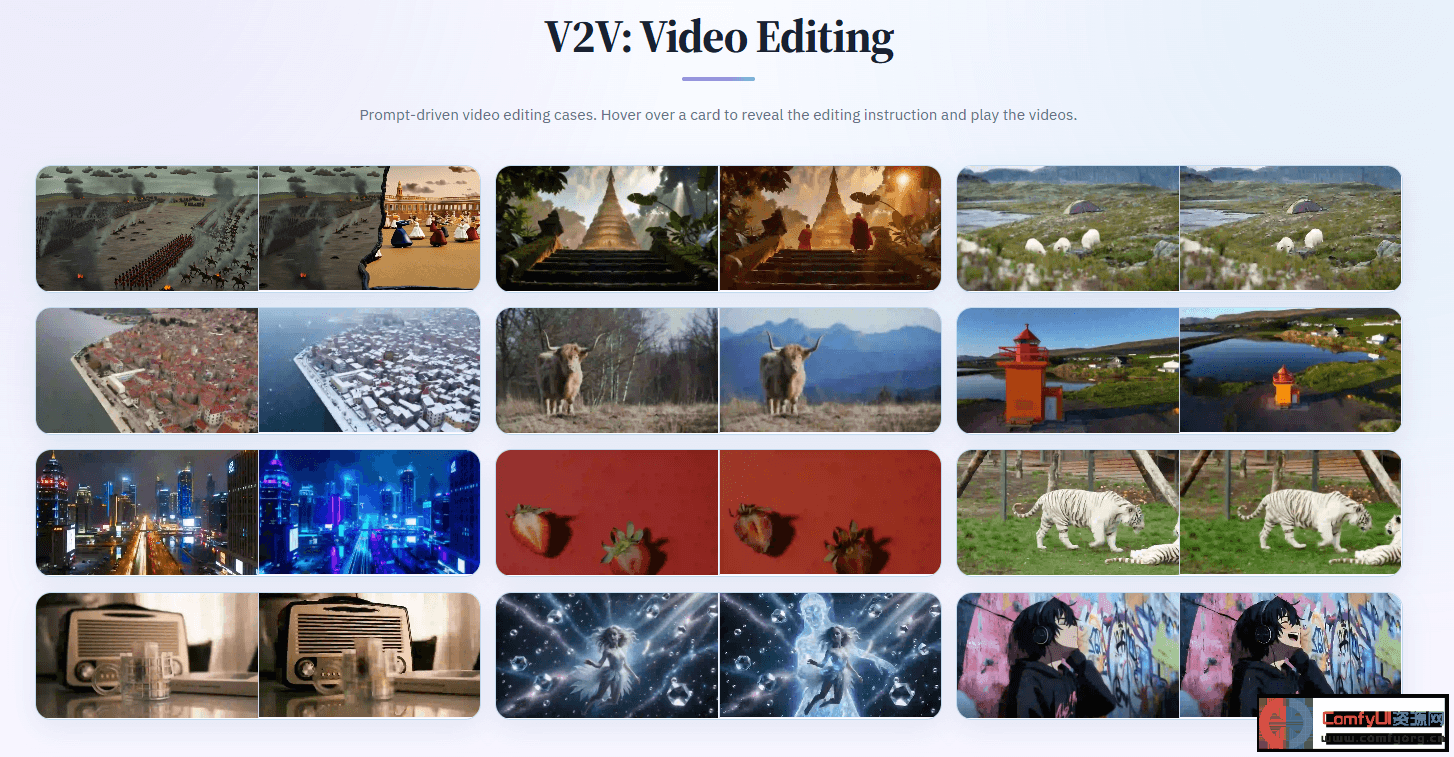
效果参考:https://bernini-ai.github.io/
四、实战避坑指南:血泪经验总结
1. 显存不足报错:确保模型与显存匹配(如 8GB 卡勿用 FP8 模型)。
2. 出图模糊:检查采样步数分配,低噪阶段步数不足易导致细节丢失。
3. 任务类型选错:务必确认任务下拉菜单为“Text to Image”。
4. 提示词无效:避免使用中文标点或冗长描述,精简核心要素。
写在最后:技术,而非工具,才是创造力源泉 Bernini 的强大,本质是量化技术与流程优化的胜利。希望本文能帮你掌握方法而非依赖参数。
😙谢谢老板
?没下载?