


一、Lens介绍
Lens是一个38 亿参数的基础文本到图像模型,旨在实现高效训练和快速高分辨率生成。它结合了密集描述预训练、混合分辨率学习、GPT-OSS 多层文本特征和 FLUX.2 语义 VAE,以远低于大型 T2I 模型的训练计算量达到具有竞争力的质量。
该存储库提供了从 Lens DiT 检查点生成图像所需的最小推理代码。
- 高效基础模型——基于Lens-800M进行训练,Lens-800M 是一个包含 8 亿张图像和文本的语料库,具有较长的 GPT-4.1 标题,最大程度地提高了每个训练批次的信息密度。
- 紧凑而富有表现力——48 块 MMDiT 去噪器利用 FLUX.2 潜在特征和连接的多层 GPT-OSS 特征,实现更强的提示跟随和多语言泛化。
- 灵活分辨率
1:2— 混合分辨率训练支持从到 的宽高比2:1和高达1440×1440 的分辨率进行推理。 - 训练后变体— RL 调整可提高视觉质量和抑制伪影;精炼的Lens-Turbo支持快速4 步生成。
二、相关安装
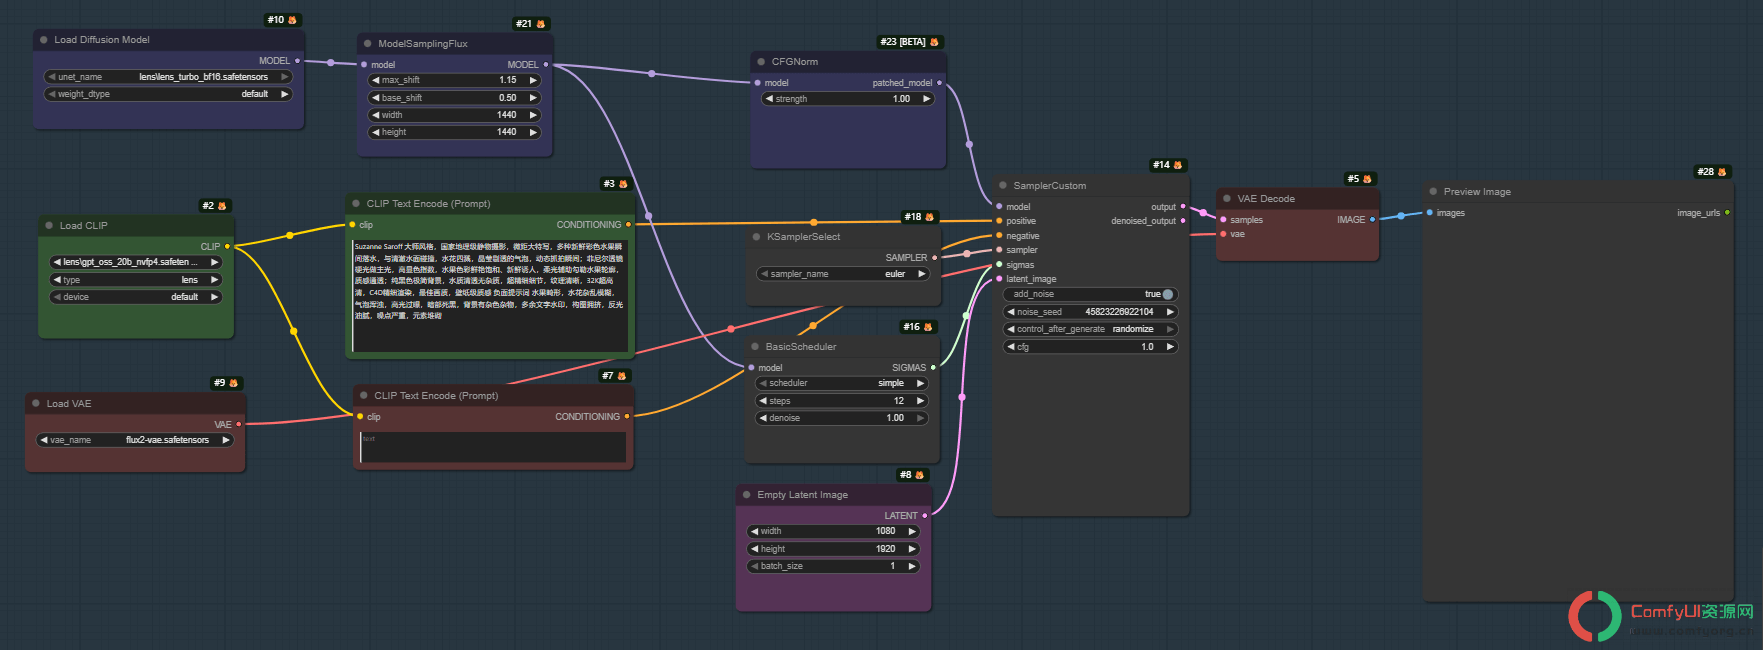
模型路径:
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 diffusion_models/
│   │   ├── lens_bf16.safetensors
│   │   └── lens_turbo_bf16.safetensors
│   ├── 📂 text_encoders/
│   │   └── gpt_oss_20b_nvfp4.safetensors
│   ├── 📂 vae/
│ │ └── flux2-vae.safetensors三、工作流
四、效果案例
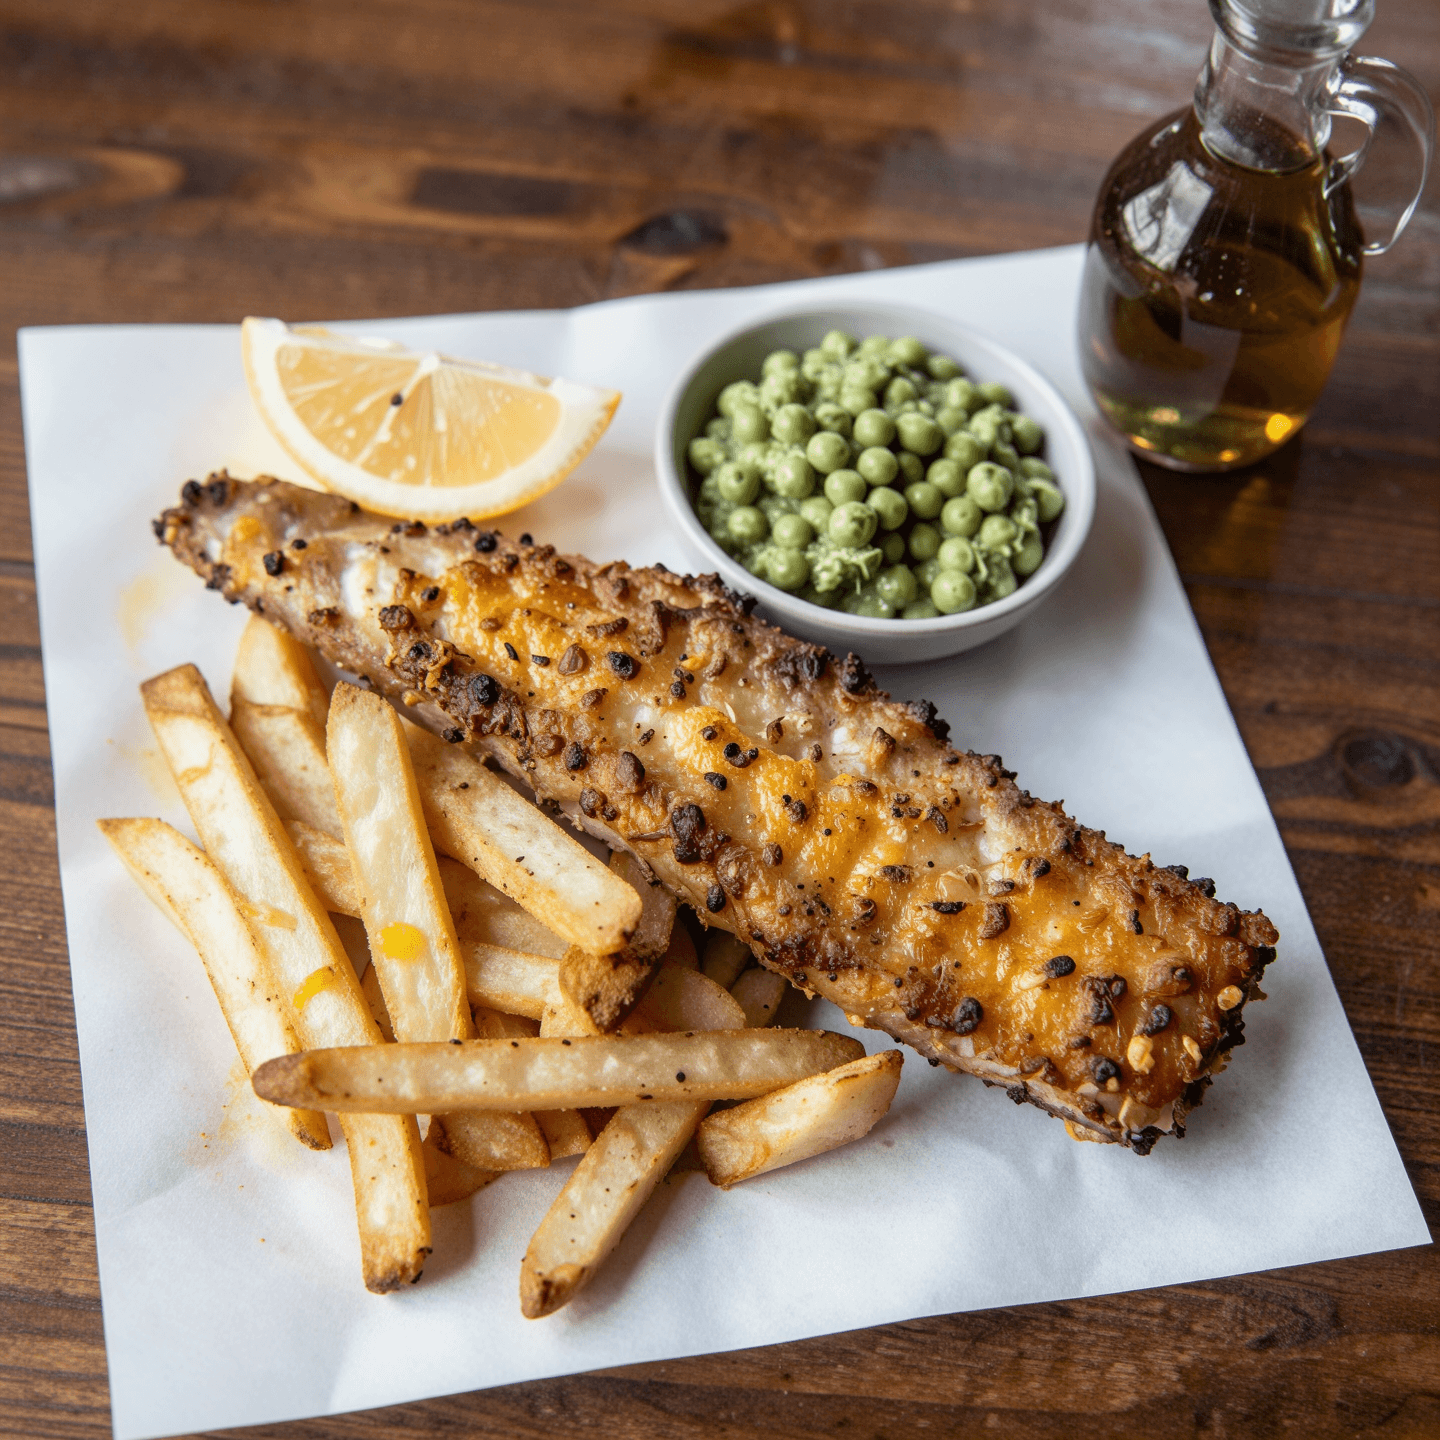 示例 000 · 1440x1440 一份分量十足的经典英式炸鱼薯条,盛放在一张白纸上,金黄酥脆的啤酒面糊鳕鱼柳配上厚切薯条、一片柠檬、一小碟豌豆泥、旁边放着一瓶麦芽醋,背景是一张木质酒吧桌,俯拍镜头。 |
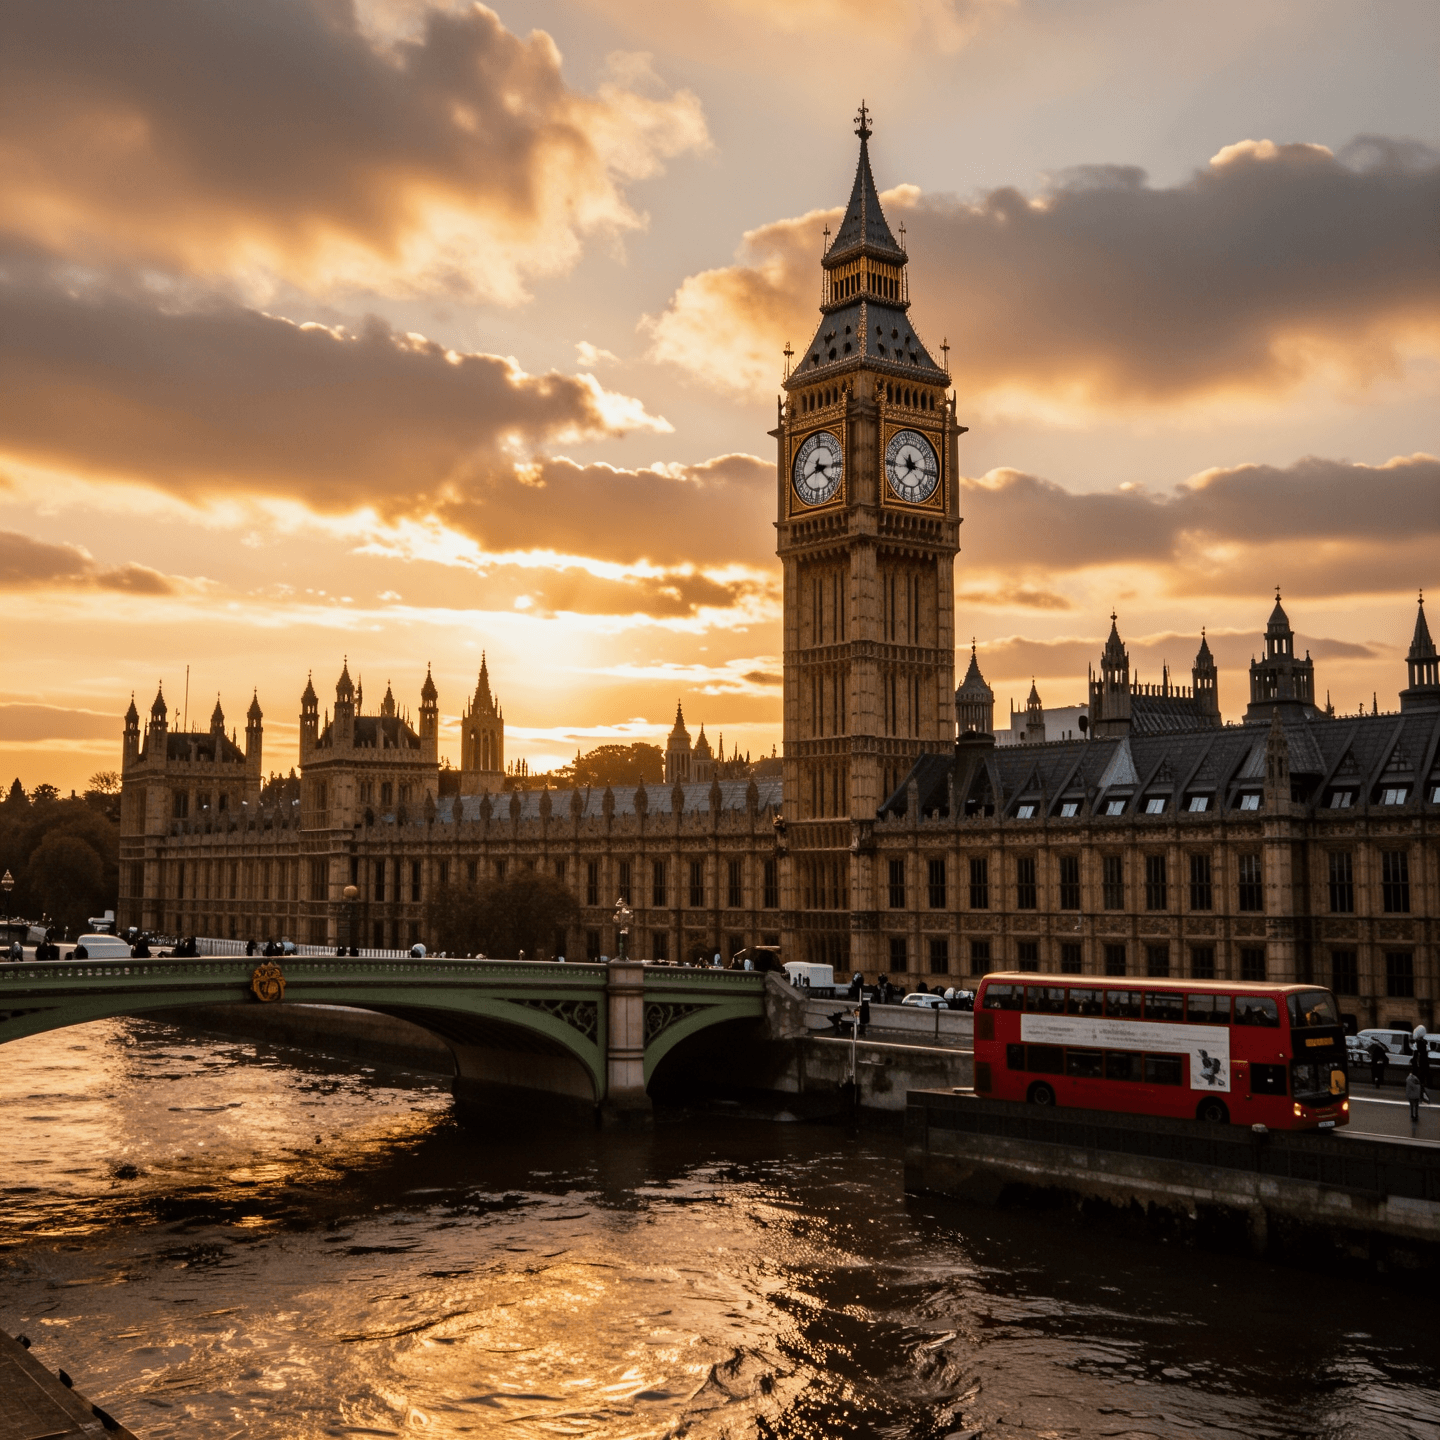 示例 001 · 1440x1440 伦敦标志性的大本钟和议会大厦在日落时分熠熠生辉,泰晤士河倒映着温暖的琥珀色光芒,前景是威斯敏斯特桥,一辆经典的红色双层巴士驶过,夕阳照亮了变幻莫测的云彩。 |
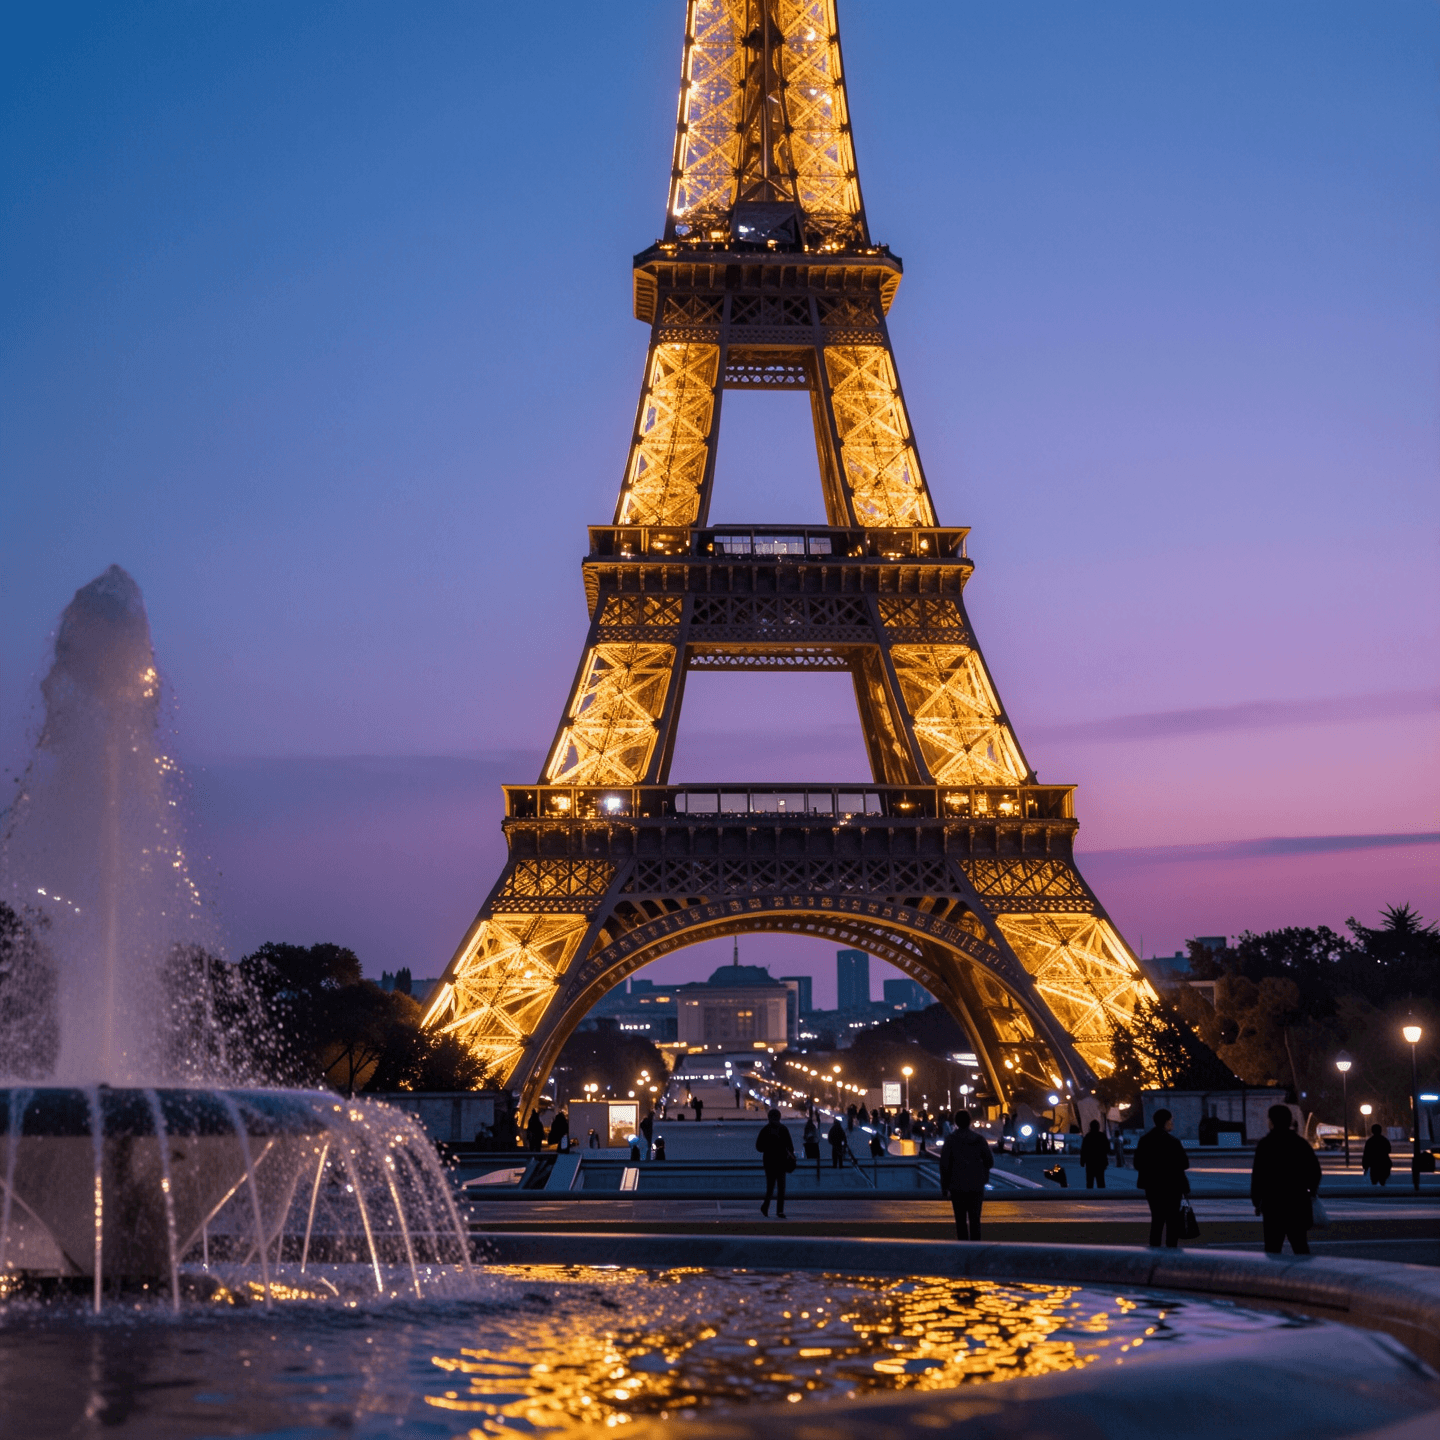 示例 002 · 1440x1440 从特罗卡德罗广场眺望黄昏时的埃菲尔铁塔,这座钢铁巨塔被数千盏闪烁的金灯照亮,天空由深蓝转为紫罗兰色,前景是特罗卡德罗广场的喷泉,倒映着金色的光影,还有漫步者的身影。 |
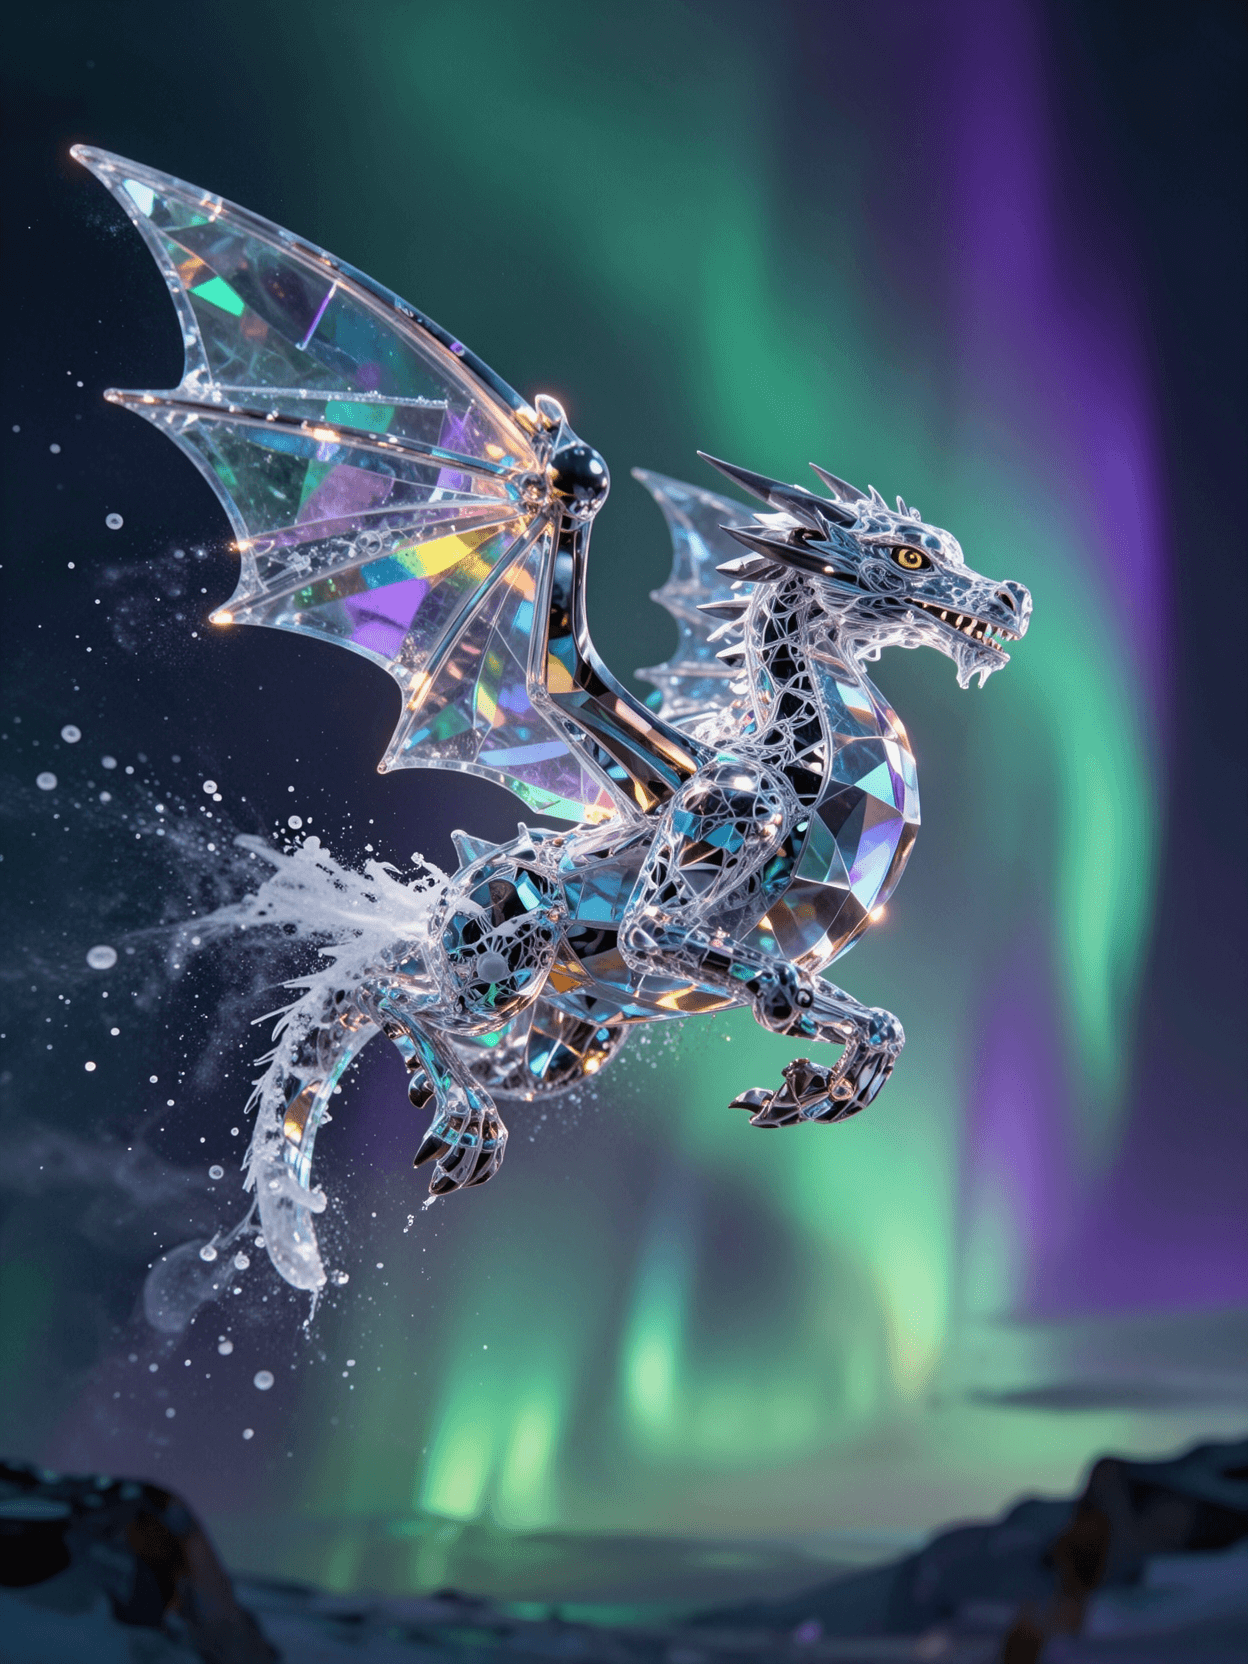 示例 003 · 1248x1664 一条水晶巨龙翱翔于北极光璀璨的夜空,它全身由透明的多面水晶构成,将绿色和紫色的极光折射成彩虹般的光谱,冰晶从它的翅膀上飘落,奇幻数字艺术 |
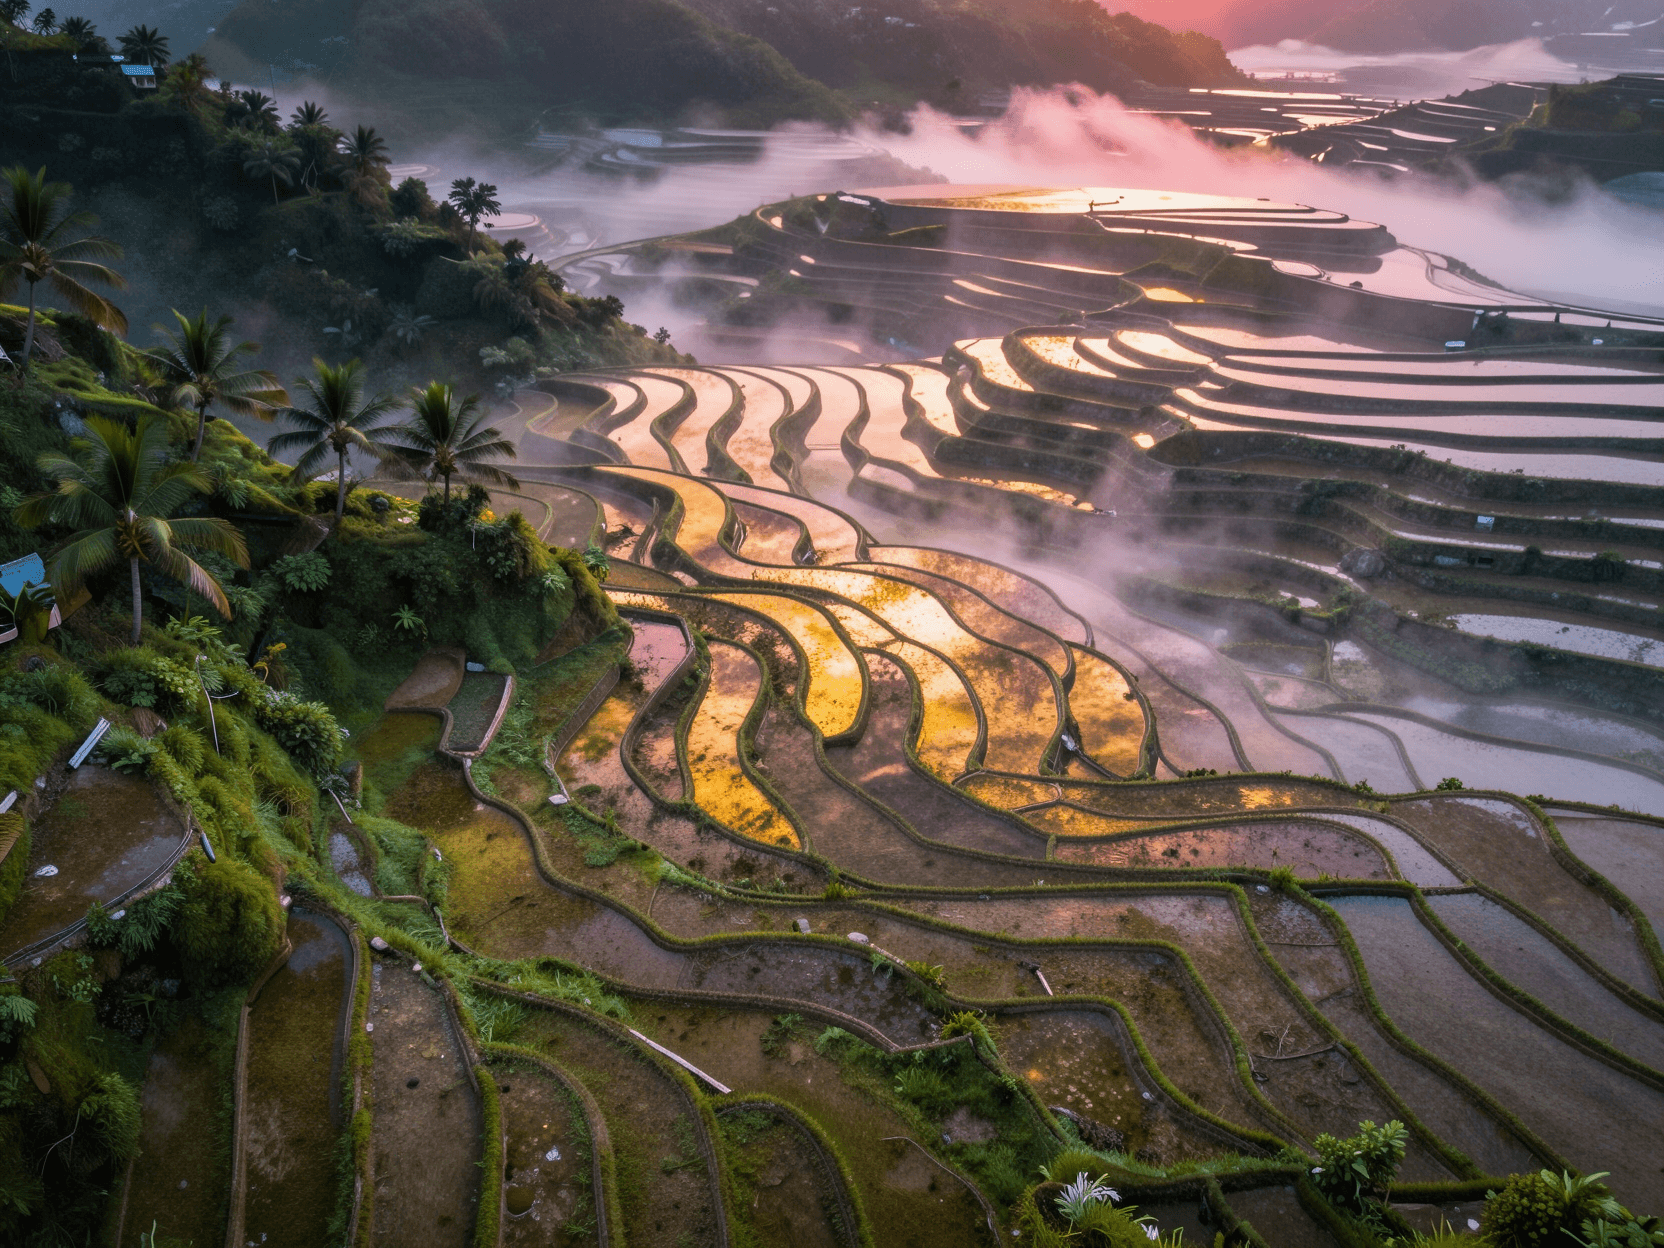 示例 004 · 1664x1248 云南元阳梯田日出航拍图,数千层层叠叠的稻田倒映着金色和粉色的天空,晨雾在梯田间弥漫,郁郁葱葱的山坡上点缀着棕榈树,无人机拍摄 |
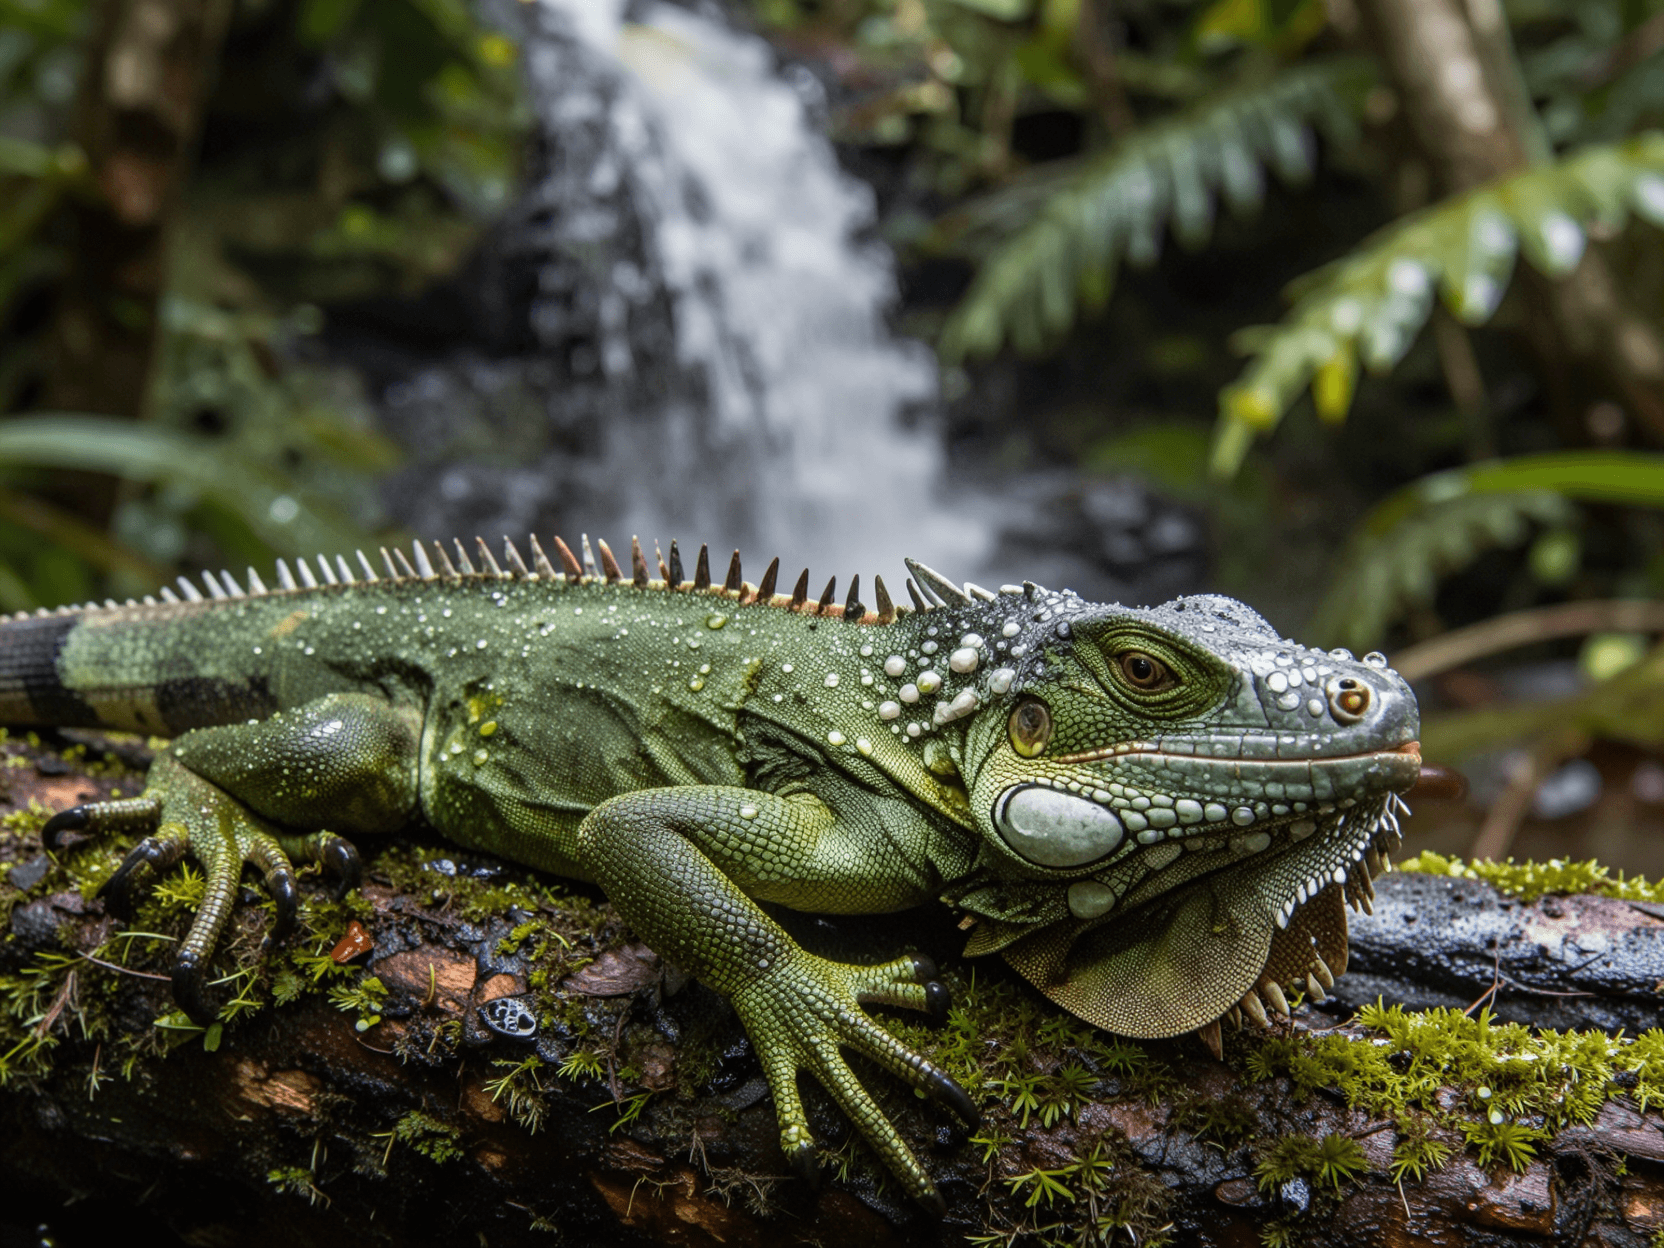 示例 005 · 1664x1248 一只绿鬣蜥在热带雨林中一根长满苔藓的倒木上晒太阳,每一片鳞片和每一根脊椎都清晰可见,露珠挂在它的皮肤上,背景是模糊的瀑布和茂盛的热带植物,国家地理野生动物摄影风格 |
总结
尽管表现优异,Lens 仍存在一些局限:
- 非英语文字渲染:虽然支持多语言泛化,但非英语文字(如中文汉字)的渲染精度仍略逊于英文。
- 复杂构图瑕疵:在极罕见物体或极度复杂的空间关系场景中,偶尔会出现逻辑错误。
- 依赖泛化而非专门训练:多语言能力主要源于模型泛化,未来可通过引入更多多语言数据进行专项优化。
Lens 证明了基础文生图模型不一定必须依赖极大规模参数和极高训练成本。通过提升数据密度、优化模型架构、改进训练策略和引入系统级后训练优化,3.8B 的 Lens 也可以达到 SOTA 级别的生成效果。本次微软开源 Lens-Base、Lens-RL 和 Lens-Turbo,希望为社区提供一个高质量、高效率、易部署的文生图基础模型,推动图像生成技术在研究、创作和实际产品中的进一步发展。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
9.5模型路径安装位置是哪