


一、什么是OmniVoice
OmniVoice-TTS 是由小米人工智能实验室下一代 Kaldi 团队(k2-fsa)于 2026 年 4 月开源的大规模多语言零样本文本转语音(TTS)模型,支持超 600 种语言,在语音克隆、声音设计、推理速度等方面表现突出,适用于多语种配音、数字人、有声书、语言保护等场景。
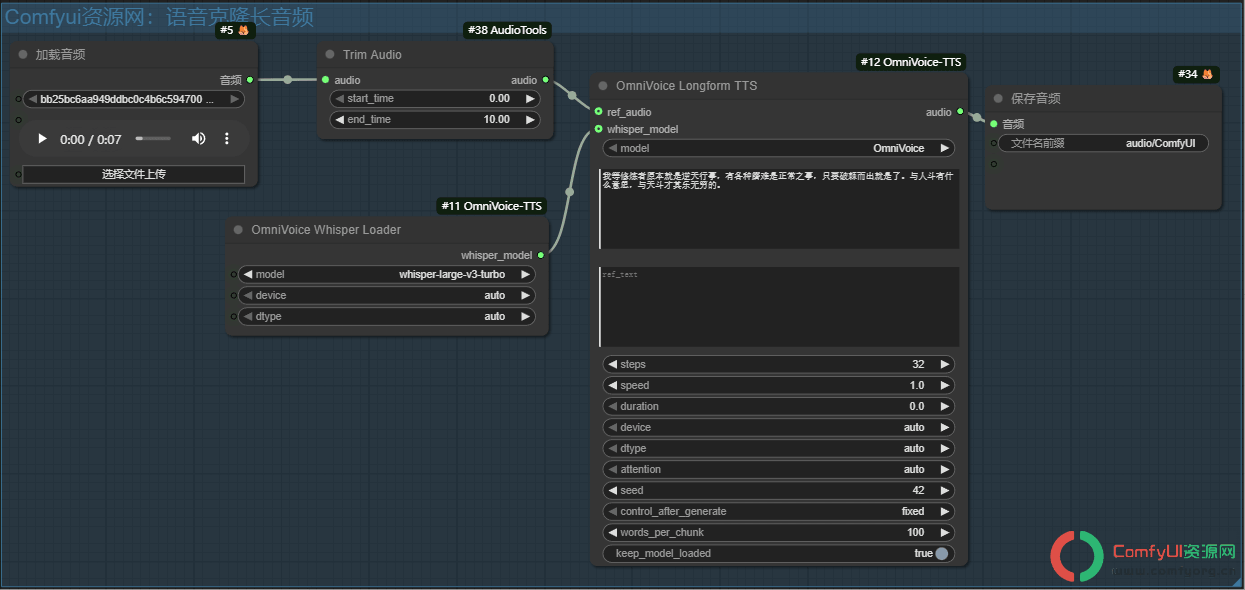
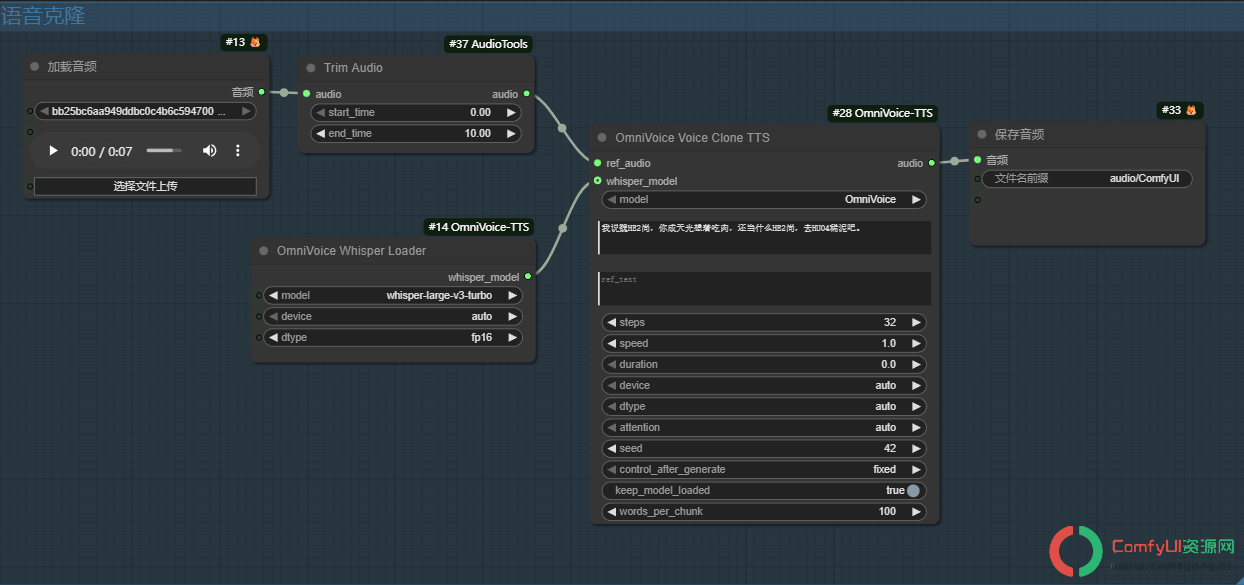
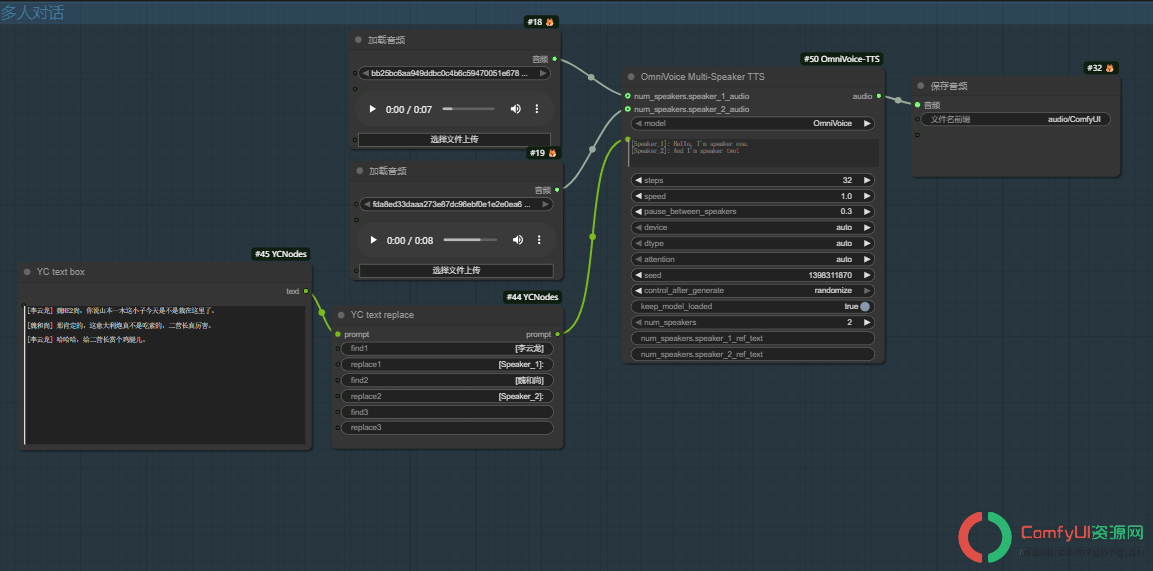
OmniVoice-TTS 工作流采用模块化设计,将语音生成的不同需求划分为四个独立的功能组件。用户可以根据实际应用场景,选择标准克隆、长文本处理、声音定制或多角色对话模式。
- 600+种语言 — 零样本TTS模型中语言覆盖最广
- 声音克隆 — 3-15秒参考音频即可克隆任意声音
- 声音设计 — 通过文字描述创建合成声音(性别、年龄、音调、口音)
- 多说话人对白 — 使用
[Speaker_N]:标签生成多人对话 - 快速推理 — RTF低至0.025(比实时快40倍)
- 非语言表达 — 内联标签如
[laughter]、[sigh]、[sniff] - SageAttention支持 — 通过monkey-patch Qwen3Attention实现GPU优化注意力(仅CUDA,SM80+)
- 自动下载 — 首次使用时自动从HuggingFace下载模型
- Whisper ASR缓存 — 预加载Whisper避免每次重新下载
- 显存高效 — 自动CPU卸载,VBAR/aimdo集成,智能缓存失效
二、相关安装
OmniVoice-TTS:https://github.com/Saganaki22/ComfyUI-OmniVoice-TTS
ComfyUI_AudioTools:https://github.com/billwuhao/ComfyUI_AudioTools
模型二选一:
| 模型 | 大小 | 说明 |
|---|---|---|
OmniVoice |
~4GB | 完整fp32模型 - 600+语言 |
OmniVoice-bf16 |
~2GB | Bfloat16量化 - 显存更低 |
模型路径:
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 omnivoice/
│   │      └── OmniVoice/           (~4GB, fp32)
│   │      └──  OmniVoice-bf16/     (~2GB, bf16)
│   ├── 📂 audio_encoders/
│   │      └── openai_whisper-large-v3-turbo/
│   │      └── openai_whisper-large-v3/
│   │      └── openai_whisper-medium/
三、工作流
语音克隆长音频
单人语音克隆
多人对话语音克隆
四、总结
在中文语音合成中,多音字的准确识别是影响自然度的关键因素。OmniVoice-TTS 提供了基于拼音的直接输入方案,能够精确控制声调。用户只需在文案中将对应字词替换为带数字声调的拼音(如 CHONG2 代表重,ZHONG4 代表重),即可避免模型识别错误。此外,在声音设计模式下,系统允许用户精细调节非语言表达标签,包括呼吸声、停顿以及特定的口音风格(如四川话、东北话),以增强合成的真实感。
- 全球化内容生产:媒体平台与创作者借助其跨语言能力,将课程、播客、短视频等快速本地化为数十种语言版本,并通过音色克隆保持品牌声音一致性。
- 沉浸式娱乐语音生成:游戏开发团队可为 NPC 角色批量生成方言、口音、情绪各异的语音,影视后期亦能高效完成多语种配音替换。
- 智能交互系统构建:企业可私有化部署 OmniVoice,打造支持多语种、多音色、多情感的客服语音引擎,或复刻代言人声音增强用户信任感。
- 语言教育与保护实践:面向少数民族语言、濒危语种的教学资源建设,结合拼音/音素级发音控制,辅助学习者掌握标准读音与语调规律。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。