


一、Gemma4是什么?
2026年4月2日,谷歌DeepMind正式推出Gemma 4系列多模态开源模型,时隔一年接力Gemma 3,凭借全场景覆盖、端侧深度优化与商业友好开源协议,成为谷歌迄今最强、最亲民的开源AI模型家族。最具颠覆性的是,它专为手机打造超小参数版本,普通千元机就能本地离线运行,真正实现“把AI装进口袋”。
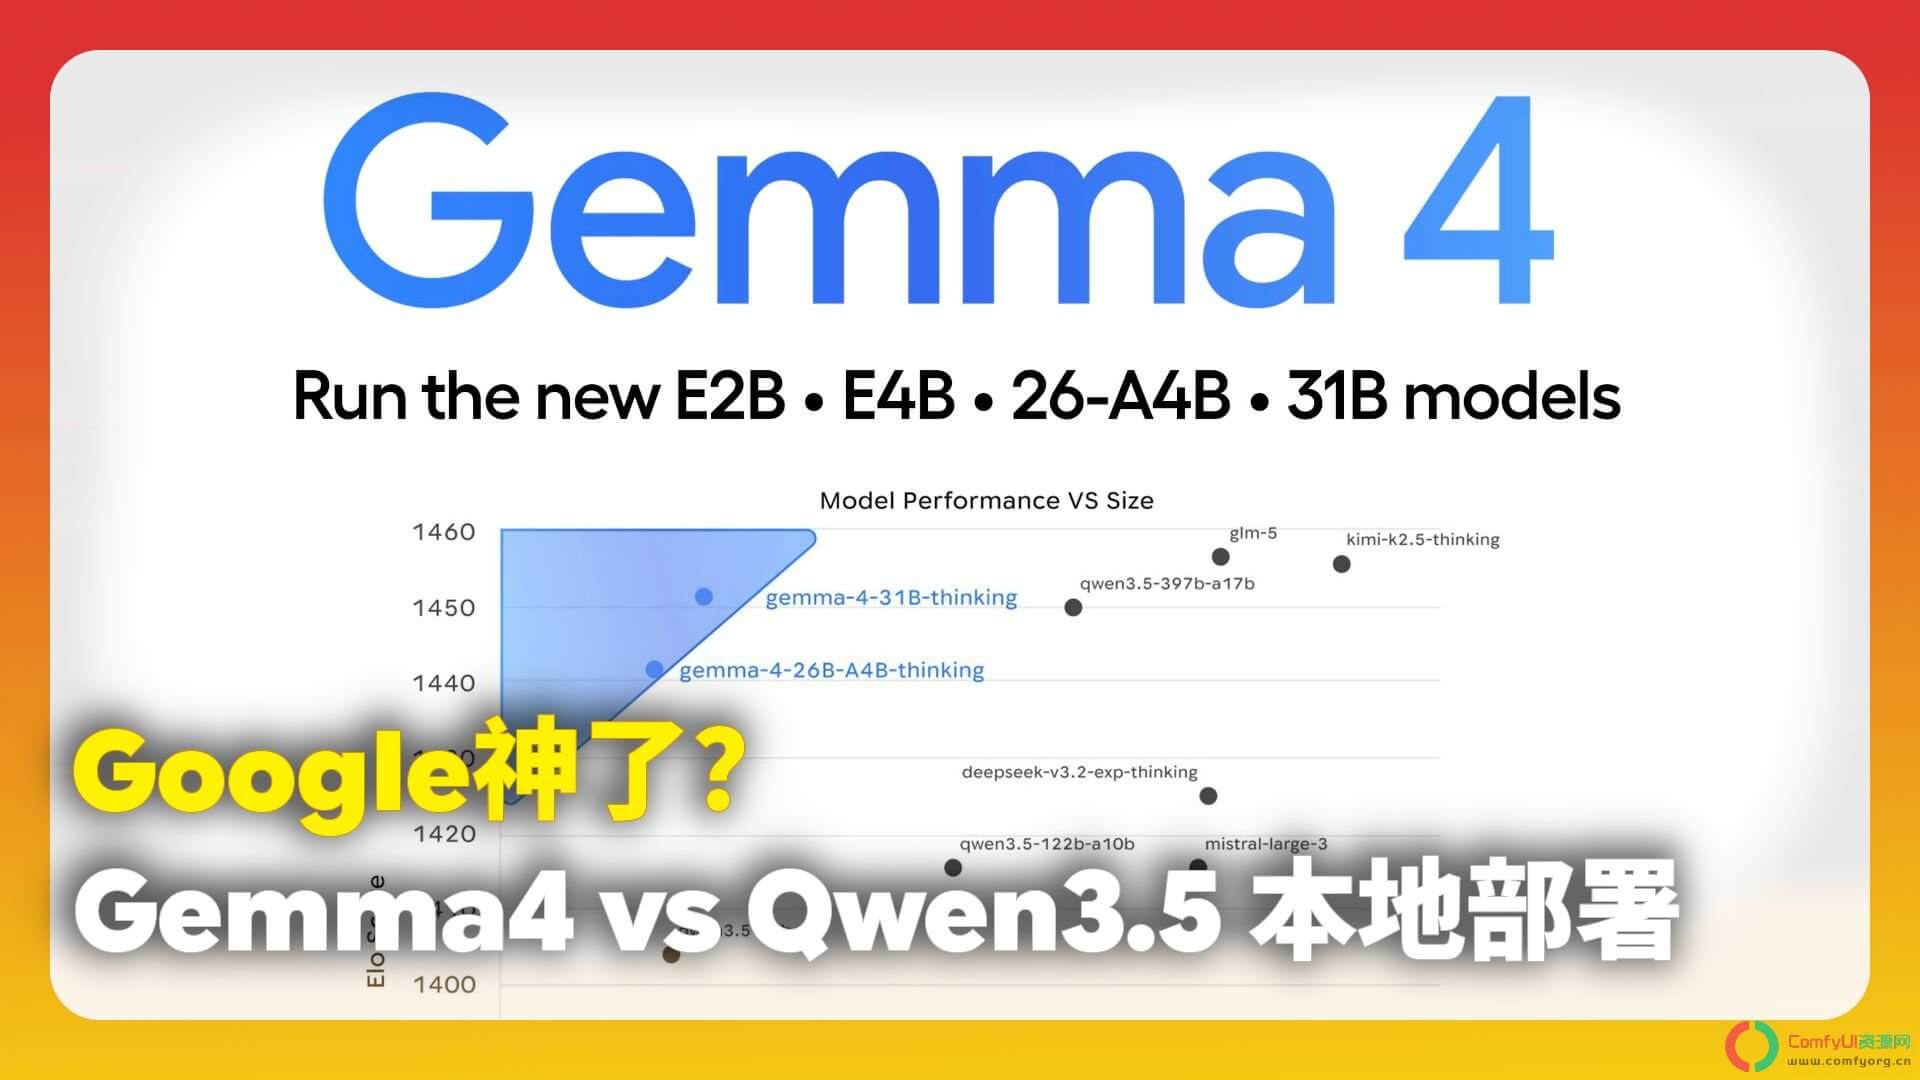
- 模型规格:包含高效 20 亿(E2B)、高效 40 亿(E4B)、260 亿混合专家(MoE)与 310 亿稠密(31B)四种版本,适配从移动设备到服务器的不同硬件 。
- 核心能力:专为高级推理、智能体工作流及端侧离线运行设计,支持超过 140 种语言及代码生成 。
- 部署场景:小模型可在 Android 手机、树莓派等设备低延迟运行,大模型支持工作站高效推理 。
二、相关安装
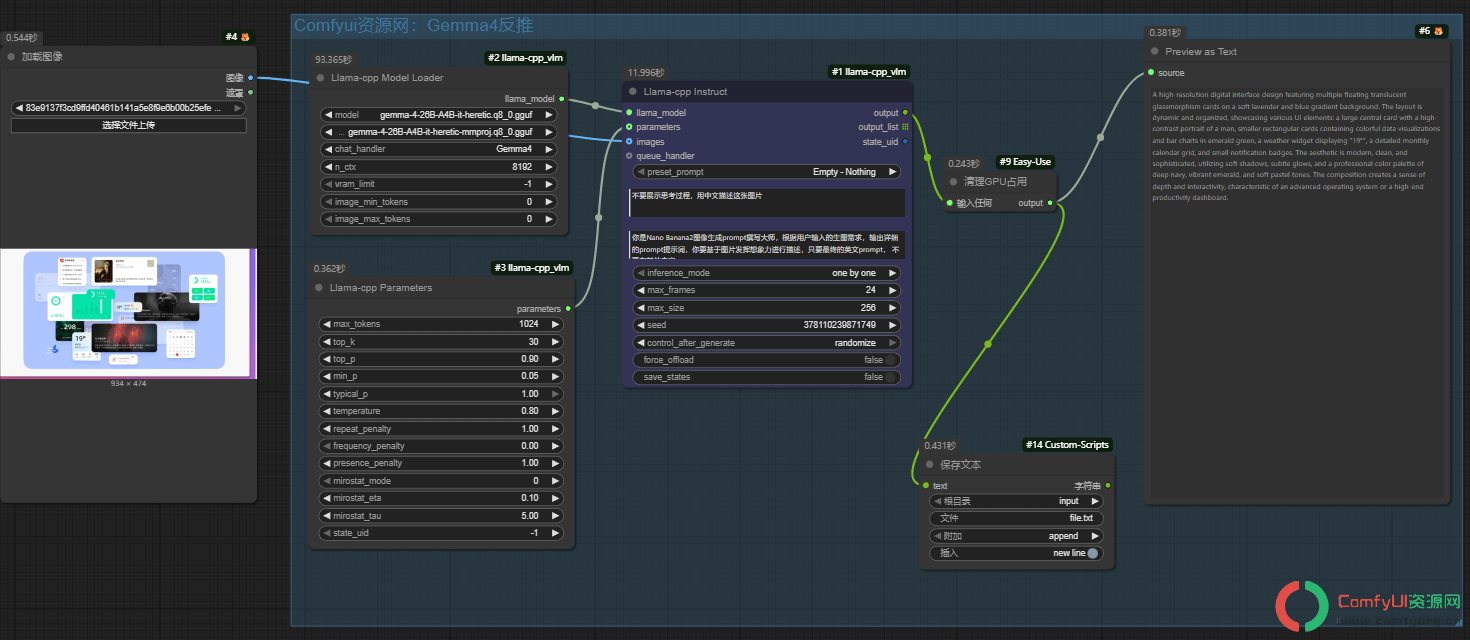
插件:ComfyUI-llama-cpp_vlm(文末网盘下载)
下载模型:
请将模型文件放入该ComfyUI/models/LLM文件夹中。如果您需要 VLM 模型来处理图像输入,请不要忘记下载mmproj权重。
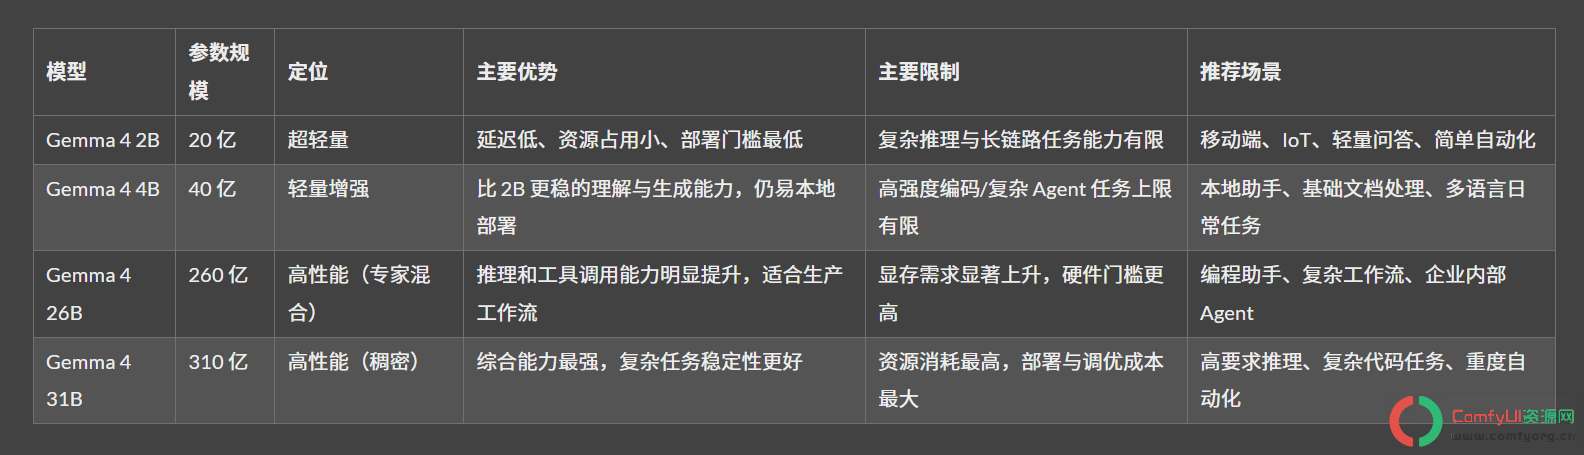
✅E2B(5.1亿总参/2.3亿激活):手机/IoT专属,内存压至4GB以下,千元机流畅运行
✅E4B(8亿总参/4.5亿激活):手机/中端设备主力,多模态拉满,性能超越上代7B模型
✅26B MoE(混合专家):消费级GPU可用,推理仅激活3.8亿参数,速度与性能兼顾
✅31B Dense(旗舰稠密):单卡H100运行,开源模型性能TOP3,基准测试表现顶尖
三、工作流
云端体验:https://www.runninghub.cn/post/2042629856315318274
四、总结
Gemma 4的发布,不仅是谷歌开源战略的重大升级,更是开源大模型发展的重要里程碑。它以“全场景适配、高性能、高自由度”为核心,凭借混合注意力机制、MoE架构优化等技术突破,实现了“小参数也能有大能力”,彻底打破了“参数量决定性能”的固有认知。Apache 2.0协议的采用,让这款模型真正走进中小企业和开发者群体,为AI技术的普及和落地提供了新的可能。
对于开发者而言,Gemma 4既是性能强大的开发工具,也是学习大模型技术的优质载体。无论是企业级私有化部署、垂直领域微调,还是端侧应用开发,Gemma 4都能提供足够的支持。随着生态的不断完善,相信Gemma 4将成为开源大模型领域的“标杆产品”,推动AI技术向更高效、更普惠的方向发展。
缺gemma4-26b-A4B-it-heretic-mmproj.q8_0.gguf模型
不同模型对硬件的要求要能备注下就更好了