


一、JoyAI-Image-Edit介绍
JoyAI-Image 是一个统一的多模态基础模型,用于图像理解、文本到图像的生成以及指令引导的图像编辑。它结合了 8 亿像素的多模态大型语言模型 (MLLM) 和 16 亿像素的多模态扩散变换器 (MMDiT)。JoyAI-Image 的核心原则是理解、生成和编辑之间的闭环协作。更强大的空间理解能力通过更优的场景解析、关系基础和指令分解来提升基于场景的生成和可控的编辑,而诸如视角变化之类的生成变换则为空间推理提供了补充证据。
- 统一的多模态基础:通过共享的 MLLM-MMDiT 接口,实现理解、生成和编辑的单一模型系列。
- 实用数据和训练方案:一个可扩展的管道,包含空间理解数据(OpenSpatial)、长文本渲染数据、编辑数据(SpatialEdit)和多阶段优化策略。
- 唤醒空间智能:通过理解和生成之间的双向循环,增强空间理解力、可控空间编辑能力和新颖视角辅助推理能力。
- 高级视觉生成:强大的长文本排版、布局保真度、多视图生成和可控编辑,并能更好地保留场景结构。
二、相关安装(网盘下载)
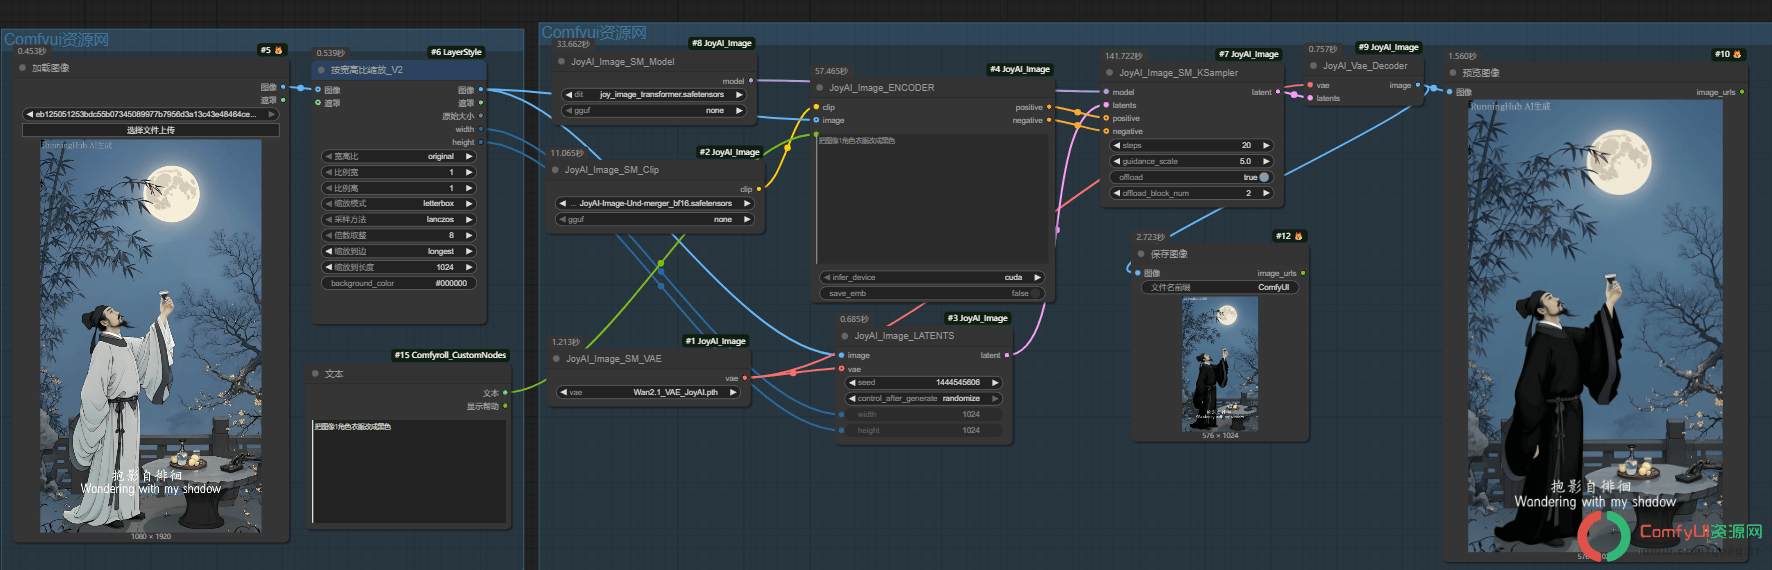
JoyAI_Image插件:https://github.com/smthemex/ComfyUI_JoyAI_Image
模型(文末下载):joy_image_transformer.safetensors
模型路径:
├── ComfyUI/models/
|     ├── diffusion_models/
|        ├──joy_image_transformer.safetensors
|     ├── vae/
|        ├──Wan2.1_VAE.pth
|     ├── clips
| ├──JoyAI-Image-Und-merger_bf16.safetensors三、工作流
云端示例:https://www.runninghub.cn/post/2042255778484064257
四、总结
此次JoyAI-Image-Edit 的开源,是京东在 AI 多模态模型领域的重要布局,更是让 AI 图像编辑实现了从平面到空间的大跨越。未来该模型还将持续落地更多场景,不断探索空间智能落地价值。
在AI研发和应用领域,京东今年成果不断。过去一个月内,京东宣布首次开源基础大模型JoyAI-LLM Flash,打破了大模型参数内卷的困局;京东云“龙虾”系列产品集体上线,token调用量周环比增长高达455%;京东还宣布将建成全球最大的具身数据采集中心。依托超级供应链优势,京东将持续推动AI与产业深度融合,真正为产业创造价值。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
插件根本不全,b站上只有一个提供插件的,和你提供的包一样,这些插件好难找,不知道要从哪找插件,京东软件都开发了,插件却不提供,令人失望。