


一、什么是Fish Audio S2 Pro
Fish Audio 是生成式AI文本转语音(TTS)和声音克隆平台。Fish Audio支持用户将文本转换为自然流畅的语音,提供多种语言和声音风格。Fish Audio 提供声音克隆功能,用户上传目标人物的音频样本,基于AI技术克隆出该人物的声音,用在生成个性化的语音内容。Fish Audio提供API接口,方便开发者集成到自己的应用程序中。Fish Audio 适合个人创作者、开发者及需要高质量语音合成和声音克隆的用户。
核心功能
- 文本转语音(TTS):将用户输入的文本转换为自然流畅的语音,支持多种语言和声音风格,满足不同场景下的语音合成需求。
- 声音克隆:用户上传目标人物的音频样本,基于AI技术克隆出人物的声音。
- 声音库管理:用户创建和管理自己的声音库,方便随时调用已生成的声音模型,进行语音合成或进一步编辑。
- API接口:提供API接口,方便开发者将Fish Audio的功能集成到自己的应用程序中,实现更广泛的应用场景。
- 多语言支持:支持多种语言的语音合成,满足不同用户的需求。
二、相关安装(文末网盘合集)
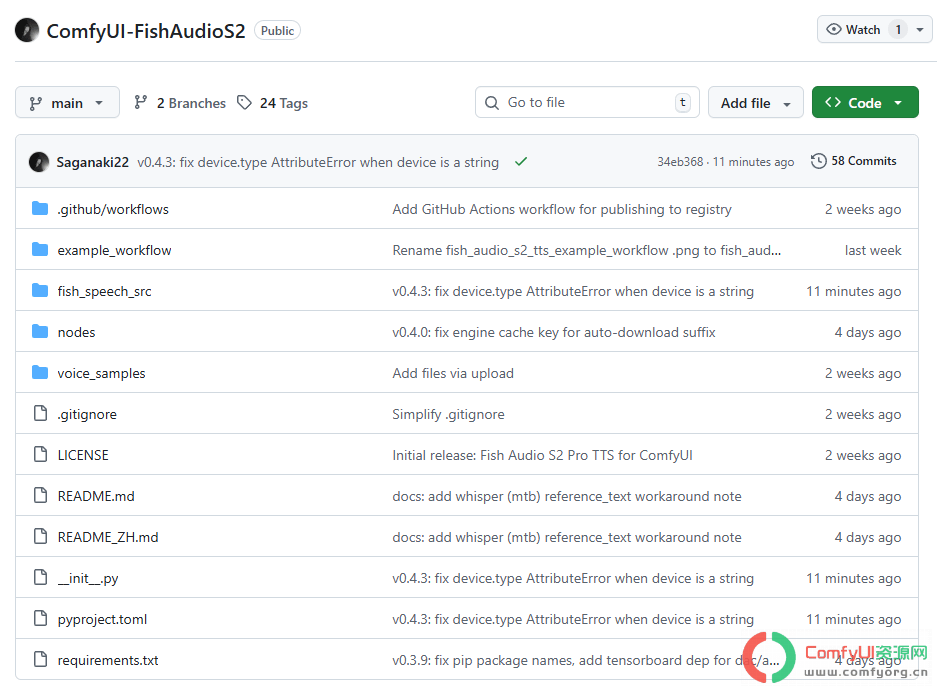
ComfyUI-FishAudioS2插件安装:https://github.com/Saganaki22/ComfyUI-FishAudioS2
如果安装报错,就下载替换文件(手动修复办法):
1,安装依赖的时候需要手动下载fish-speech,替换节点中的fish-speech src内的文件(https://github.com/fishaudio/fish-speech)
2,修改代码,找到fish_speech_src\fish_speech\models\dac内的inference.py,修改第20行代码,把把 "eval" 改成唯一名称,比如 "fish_eval",文末网盘直接下载修正版)
模型下载:
- 显存占用24g起:https://huggingface.co/fishaudio/s2-pro/tree/main
- fp4量化(显存占用8g起):https://huggingface.co/baicai1145/s2-pro-w4a16/tree/main
- fp8量化(限于40系50系,显存占用12g起):https://huggingface.co/drbaph/s2-pro-fp8/tree/main
模型路径:
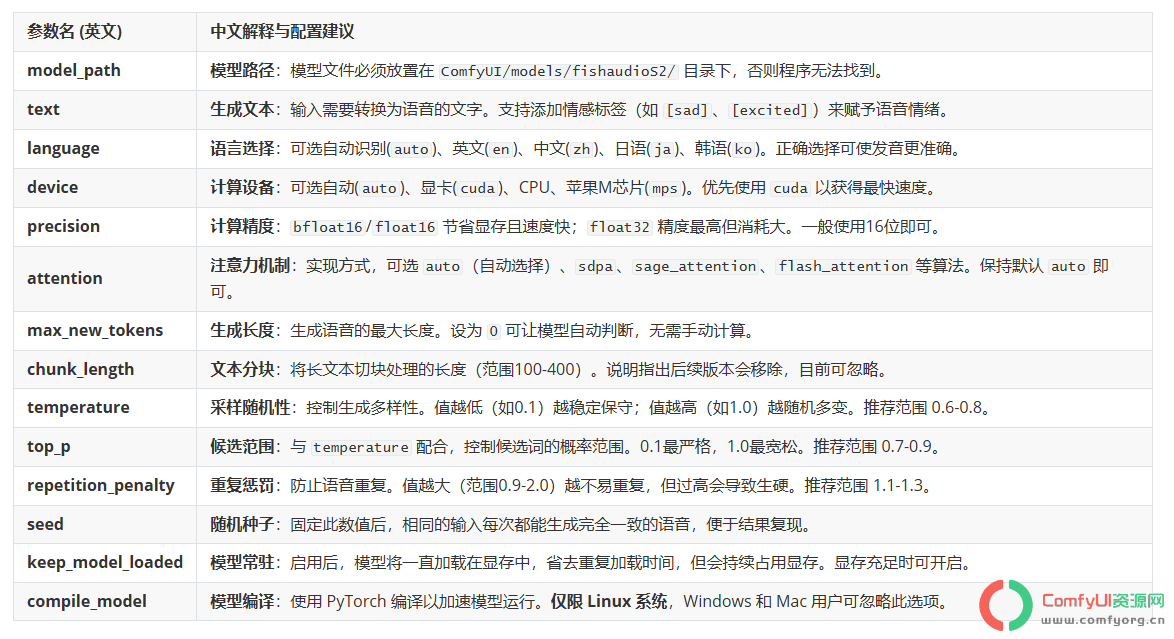
模型文件必须放置在 `ComfyUI/models/fishaudioS2/` 目录下,否则程序无法找到
ComfyUI/models/FishAudioS2/
├── s2-pro/
│   ├── config.json
│   ├── model.safetensors
│   └── ...
└── s2-pro-fp8/
    ├── config.json
    ├── model.safetensors
    └── ...
三、工作流
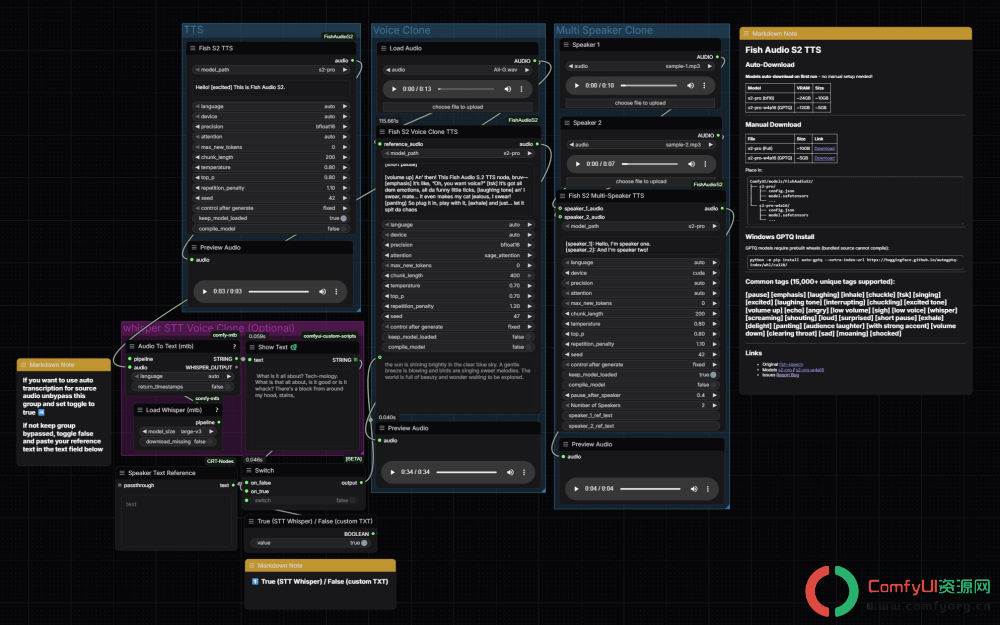
Fish Speech S2 终极表现力控制指令词典 (核心全集)
提示词插入语气示例:
- Hello! [excited] 这是我克隆的声音.
- [narrator tone] 终于攒够了保底的资源,今天我必须要拿下这个限定角色。
- [excited] 金光!出金了家人们![laughing] 我就说我今天是天选之子吧!
- [pause]
- [+nervous] 哎?等等……这个角色的剪影,怎么看着有点眼熟?
说明:Fish Speech S2 基于 LLM 语义理解,支持将以下标签任意组合(如 `[+whisper, +terrified]`)嵌入文本中,以实现像素级的语音表现力控制。
一、 基础与复合情绪 (Emotions & Nuances)
1. 正向情绪 (Positive)
[happy] # 开心:基础快乐,声音明亮
[joyful] # 喜悦:比 happy 更轻快,有上扬感
[excited] # 兴奋:语速略快,音调升高,带有张力
[delighted] # 欣喜:轻柔的快乐,适合温柔的场景
[super happy] # 极度开心:情绪高昂,可能伴随轻微笑意
[euphoric] # 狂喜:失去理智的快乐,极具爆发力
[proud] # 自豪:胸腔共鸣增加,语调自信且平稳
[relieved] # 释然:伴随轻微的叹气感,肌肉放松的发音
[amused] # 被逗乐:语调带有跳跃感,通常伴随憋笑2. 负向与悲伤情绪 (Negative & Sadness)
[sad] # 悲伤:基础低落,语速放缓
[sorrowful] # 哀伤:比 sad 更深沉,带有明显的鼻音
[depressed] # 抑郁:气息微弱,几乎没有音调起伏
[melancholic] # 忧郁:带有文艺感的低落,适合诗歌朗诵
[upset] # 心烦意乱:语速不稳,带有轻微的焦躁感
[painful] # 痛苦:发声带有撕裂感和肌肉紧绷感
[guilty] # 内疚:声音压低,带有逃避感的吞吐
[devastated] # 崩溃/绝望:彻底失去力量,通常伴随哭腔3. 愤怒与攻击性 (Anger & Aggression)
[angry] # 愤怒:基础生气,重音明显
[annoyed] # 恼怒:轻度生气,语调短促且不耐烦
[frustrated] # 挫败/气馁:带有叹气和咬牙切齿的混合感
[furious] # 暴怒:极高的声压,字眼咬得很重
[outraged] # 狂怒:伴随大喊大叫的倾向
[disdainful] # 轻蔑:音调怪异,尾音上扬或拖长
[scornful] # 嘲笑/鄙夷:带有明显的冷笑(sneering)特质
[condescending] # 居高临下:放慢语速,带有说教和傲慢的语气4. 恐惧与紧张 (Fear & Anxiety)
[fearful] # 恐惧:基础害怕,声音发虚
[nervous] # 紧张:语流不畅,带有高频的微小停顿
[anxious] # 焦虑:语速偏快,气息极度不稳
[scared] # 害怕:音调不自觉拔高,带有退缩感
[terrified] # 极度惊恐:声音剧烈颤抖,常伴随倒吸气
[panicked] # 恐慌:语无伦次,呼吸急促
[hysterical] # 歇斯底里:失去控制,音调极高且破音二、 社交、态度与人设语气 (Social Tones & Personas)
[professional] # 专业:咬字清晰,无多余情绪(基础播音腔)
[broadcast tone] # 播音腔:字正腔圆,带有一点共鸣修饰
[narrator tone] # 旁白:客观、娓娓道来,适合长文本
[storytelling] # 讲故事:起伏夸张,极具吸引力和悬念感
[sarcastic] # 讽刺/阴阳怪气:重音放错位置,语调极度夸张
[sincere] # 真诚:降低音调,拉长元音,边缘音平滑
[comforting] # 安慰/治愈:极度轻柔,胸腔共鸣丰富
[pleading] # 恳求:尾音上扬且带有弱化感
[whining] # 抱怨/撒娇:拖长尾音,带有鼻音和哼唧感
[authoritative] # 威严:音量大,语调下沉,极具压迫感
[robotic] # 机械音:消除所有音调起伏和情感波动(Monotone)三、 生理控制与非言语声效 (Vocalizations & FX)
这部分是 S2 模型的核心优势,能够逼真模拟人类的生理反应[laugh] # 笑:标准笑声
[laughing] # 边笑边说:字句间穿插笑意
[chuckle] # 轻笑/抿嘴笑:短促低沉的笑
[giggle] # 咯咯笑:高频、连续的小笑声
[guffaw] # 狂笑/捧腹大笑:极其夸张的爆笑
[sigh] # 叹气:标准的呼气叹息
[deep sigh] # 深沉叹气:时间更长、更重的叹息
[cough] # 咳嗽:真实的肺部气流爆破音
[clearing throat] # 清嗓子:发声前的准备动作(咳咳)
[inhale] # 吸气声:常用于极度紧张或惊讶前
[exhale] # 呼气声:常用于放松或疲惫时
[gasp] # 倒吸冷气:表示极度震惊或恐惧
[panting] # 喘气:急促呼吸,模拟剧烈运动后
[sob] # 抽泣:伴随吸鼻涕的哭泣声
[crying] # 哭泣:明显的哭腔,声带颤抖
[moan] # 呻吟:痛苦或虚弱时的长声哼唧
[grunt] # 闷哼:短促的用力声或受击声
[tsk] # 啧舌/咂嘴:表示不屑或遗憾的唇齿音四、 语速、音量与物理发声方式 (Vocalization Modifiers)
[whisper] # 耳语:纯气声,声带不完全振动(高级别潜行感)
[soft tone] # 轻声细语:保留声带振动,但极度温柔
[shouting] # 大喊:高声压,带有远距离呼喊的空间感
[screaming] # 尖叫:极高频,带有失真感
[muttering] # 嘟囔/嘀咕:含混不清,音量极小,自言自语
[mumbling] # 呢喃:比 muttering 更模糊,几乎听不清字词
[speaking fast] # 快速:压缩字间距,语流急促
[speaking slowly] # 慢速:拉长字音,适合强调或沉思
[hesitating] # 犹豫:增加“呃”、“啊”等无意义停顿
[stuttering] # 结巴:强制重复字头(如:我...我不知道)
[pitch up] # 音调抬高:强制提升基准频率
[pitch down] # 音调压低:强制降低基准频率五、 环境空间与后期模拟 (Acoustic Environments)
[large hall] # 大厅:自带广阔空间的长混响(Reverb)
[small room] # 密闭房间:极干的声音,几乎无环境反射
[echo] # 回声:明显的延迟反射(Delay)
[telephonic] # 电话音:模拟窄带传输,削减高低频
[megaphone] # 扩音器/大喇叭:带有中频突出的失真和广播感
[muffled] # 沉闷/隔音:像隔着门或捂住嘴巴说话
[outdoor] # 户外:人声会自然提高,以对抗虚拟的环境底噪六、 进阶用法:状态控制语法 (Advanced Syntax)
[+tag] # 开启/叠加特征:如 [+whisper] 从此处开始转为耳语
[-tag] # 关闭/移除特征:如 [-angry, +sad] 瞬间从愤怒转为悲伤
[free-form text] # 自由文本:如 [speaking like a dying old man] (像垂死的老人一样说话),模型具备直接理解自然语言场景的能力。
总结
Fish audio 是一个功能强大且易于使用的 AI 音频处理与创作平台,凭借其先进的技术、丰富的功能和良好的用户体验,已经成为音频创作者和内容制作者的重要工具。无论是个人用户还是专业团队,都可以通过 Fish.audio 实现高效的音频创作和处理。
2周前的文章,然后积分买的资源还不完全,囧
资源齐全的呢,都在本地跑起来了,下次我们发布工作流放云端,这样便于你们检测可用性
他应该是说模型文件没在网盘里
我交了积分,网盘咋空的,等他准备好了还要交积分吗?