


在今天这个语音应用爆发的时代,我们身边越来越多的场景都在和语音识别打交道:网课里的实时字幕、客服热线的自动转写、视频里的多语种字幕……但一直以来,市面上的语音识别系统往往存在几个“老大难”:
- 多语言支持不够,不同语言需要不同模型;
- 噪音环境下表现差,车站、商场这种场景几乎无法使用;
- 专业词汇识别率低,一遇到专有名词或新兴词汇就抓瞎。
阿里云Qwen团队推出的Qwen3-ASR Flash采用统一模型架构,支持11种语言自动识别,无需用户选择。通过上下文注入机制提升专业词汇识别率,在嘈杂环境中保持8%以下词错误率。该系统简化部署运维,降低集成成本,适用于教育、媒体、客服等多场景,标志着语音识别从"单点突破"走向"通用智能"的新时代。
一、Qwen3-ASR是什么?
Qwen3-ASR 系列包括 Qwen3-ASR-1.7B 和 Qwen3-ASR-0.6B,支持 52 种语言和方言的语言识别与语音识别(ASR)。两者均利用大规模语音训练数据以及其基础模型 Qwen3-Omni 强大的音频理解能力。实验表明,1.7B 版本在开源 ASR 模型中达到业界领先水平,并可与最强的商业闭源 API 相媲美。主要特性如下:
- 一体化:Qwen3-ASR-1.7B 和 Qwen3-ASR-0.6B 支持 30 种语言和 22 种中文方言的语言识别与语音识别,同时涵盖来自多个国家和地区的英语口音。
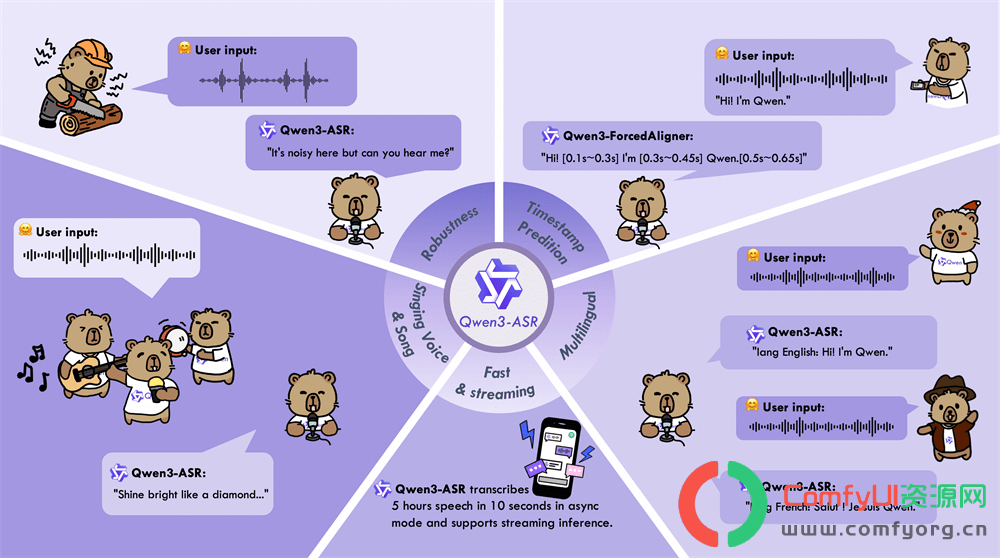
- 卓越且高效:Qwen3-ASR 系列模型在复杂声学环境和具有挑战性的文本模式下仍能保持高质量、鲁棒的识别效果。Qwen3-ASR-1.7B 在开源和内部基准测试中均表现出色;而 0.6B 版本则在精度与效率之间取得良好平衡,在并发数为 128 时吞吐量可达 2000 倍。两者均支持单模型统一进行流式/离线推理,并可处理长音频转录。
- 新颖且强大的强制对齐方案:我们推出了 Qwen3-ForcedAligner-0.6B,支持对最多 5 分钟的语音在 11 种语言中任意单元进行时间戳预测。评估显示,其时间戳精度超越了基于端到端(E2E)的强制对齐模型。
- 全面的推理工具包:除了开源 Qwen3-ASR 系列的架构和权重外,我们还发布了一个功能强大、特性完备的推理框架,支持基于 vLLM 的批处理推理、异步服务、流式推理、时间戳预测等功能。
二、相关安装(文末网盘)
插件下载:https://github.com/shumoLR/Comfyui_SynVow_Qwen3ASR
- 🎤语音转文字:拥有语音识别
- 🌍多语言支持:支持52种语言/方言,自动语言检测
- ⏱️强制对准:生成字/词级别计时器
- 🤖自动下载模型:首次使用时自动从HuggingFace下载模型
- 📊长音频支持:ASR支援20分钟,支援3分钟(超长音频自动分段处理)
首次使用时模型会自动下载到以下目录:
ComfyUI/models/Qwen3-ASR/
├── Qwen3-ASR-1.7B/           # ASR 模型 (1.7B, 默认)
├── Qwen3-ASR-0.6B/           # ASR 模型 (0.6B, 更轻量)
└── Qwen3-ForcedAligner-0.6B/ # 强制对齐模型以下是Qwen3-ASR系列模型的介绍和下载信息。请选择并下载符合您需求的模型。
| 模型 | 支持的语言 | 支持的方言 | 音频类型 |
|---|---|---|---|
| Qwen3-ASR-1.7B & Qwen3-ASR-0.6B | 中文(zh)、英文(en)、粤语(yue)、阿拉伯语(ar)、德语(de)、法语(fr)、西班牙语(es)、葡萄牙语(pt)、印尼语(id)、意大利语(it)、韩语(ko)、俄语(ru)、泰语(th)、越南语(vi)、日语(ja)、土耳其语(tr)、印地语(hi)、马来语(ms)、荷兰语(nl)、瑞典语(sv)、丹麦语(da)、芬兰语(fi)、波兰语(pl)、捷克语(cs)、菲律宾语(fil)、波斯语(fa)、希腊语(el)、匈牙利语(hu)、马其顿语(mk)、罗马尼亚语(ro) | 安徽、东北、福建、甘肃、贵州、河北、河南、湖北、湖南、江西、宁夏、山东、陕西、山西、四川、天津、云南、浙江、粤语(香港口音)、粤语(广东口音)、吴语、闽南语。 | 语音、歌声、带背景音乐的歌曲 |
| Qwen3-强制对齐器-0.6B | 中文、英文、粤语、法文、德文、意大利文、日文、韩文、葡萄牙文、俄文、西班牙文 | -- | 演讲 |
三、工作流及体验
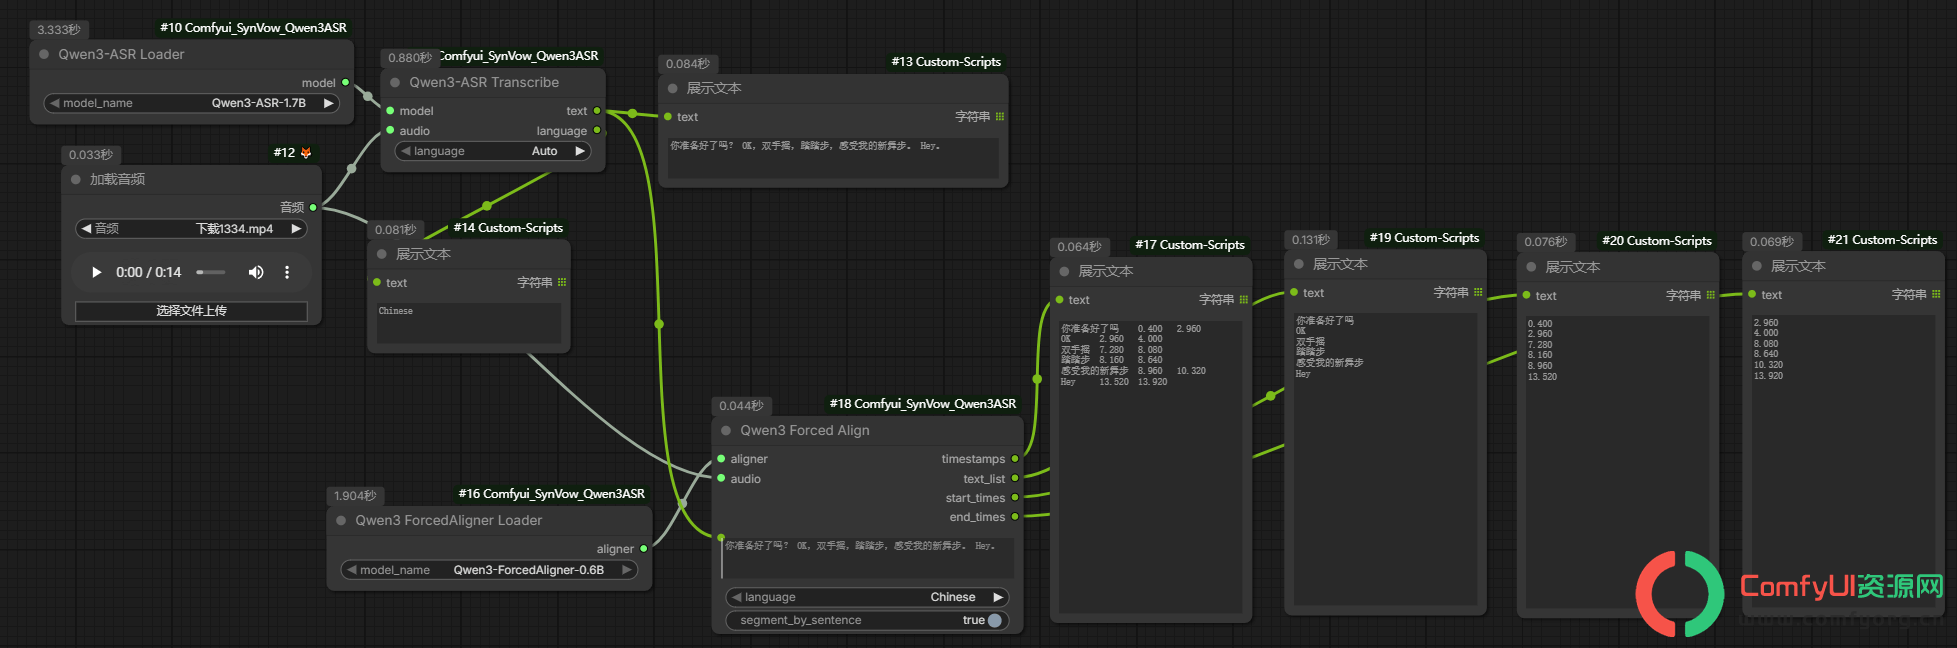
-
显存需求:
- Qwen3-ASR-0.6B:约4GB显存
- Qwen3-ASR-1.7B:约8GB显存
- ForcedAligner-0.6B:约4GB显存
-
音频长度限制:
- ASR:最近20分钟(1200秒)
- 强制时间:短暂3分钟(180秒)
- 超长音频会自动分段处理后合并
总结
如果说过去十年是“语音助手”的探索期,那么今天,像 Qwen3-ASR 这样的系统,正在让语音识别真正变得可用、可扩展。
多语言支持、抗噪、语境感知,这三点的结合,意味着未来我们可能不再需要为不同场景寻找不同工具,而是用一个通用的语音识别模型完成所有任务。
阿里云 Qwen 团队显然在押注这一趋势。问题只剩下一个:你觉得它会成为语音识别的新标准吗?
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。