


一、InfiniteTalk双人数字人
为解决虚拟人长视频生成的质量退化问题,基础研发平台/计算和智能平台部/视觉智能团队推出 InfiniteTalk 技术,实现无限时长视频生成。该技术口型精准且动作流畅,支持“语音驱动图像”和“语音驱动视频”多种模式,已在 GitHub 开源并获 1.6K Stars, Hugging Face 月下载量 64.8K,受到了很多好评,能够应用到电商直播、教育、影视等领域。
应用场景
- 营销: 电商营销视频、商家数字人直播、虚拟人导购
- 培训:虚拟人讲师、虚拟人陪练、在线教育
- 娱乐:短视频创作、虚拟偶像、游戏
二、相关安装
插件音频插件:https://github.com/ryanontheinside/ComfyUI_RyanOnTheInside
模型地址:https://huggingface.co/Comfy-Org/Wan_2.1_ComfyUI_repackaged/tree/main/split_files/model_patches
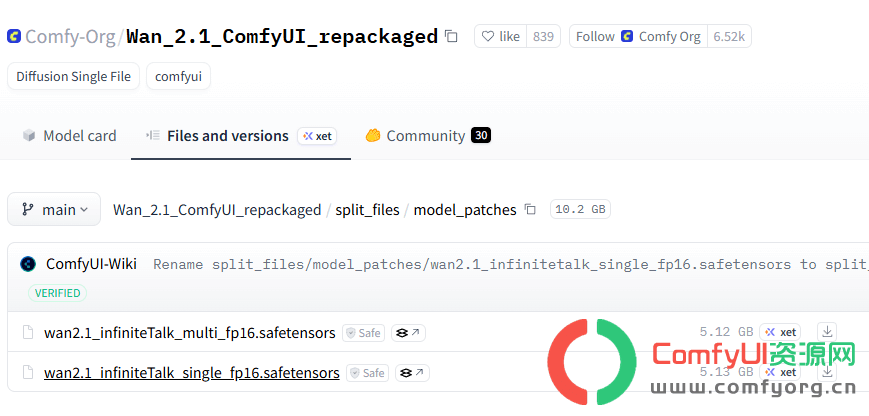
核心就是上面这2个模型,都不是很大,其他的都用wan2.1的模型就好了。
网盘我给大家提供了,自行下载。
模型安装路径:
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 diffusion_models/
│   │   └─── Wan2_1-I2V-14B-480p_fp8_e4m3fn_scaled_KJ.safetensors
│   ├── 📂 text_encoders/
│   │   └─── umt5_xxl_fp8_e4m3fn_scaled.safetensors
│   ├── 📂 model_patches/
│   │   ├─── wan2.1_infiniteTalk_single_fp16.safetensors
│   │   └─── wan2.1_infiniteTalk_multi_fp16.safetensors
│   ├── 📂 audio_encoders/
│   │   └─── wav2vec2-chinese-base_fp16.safetensors
│   ├── 📂 vae/
│   │   └─── Wan2_1_VAE_bf16.safetensors
│   ├── 📂 loras/
│   │   └─── lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors
三、工作流及体验
双人的话和单人的调整的地方不多,我把核心的和大家说一下。
首先是模型这里调整,改成网盘里面的双人模型
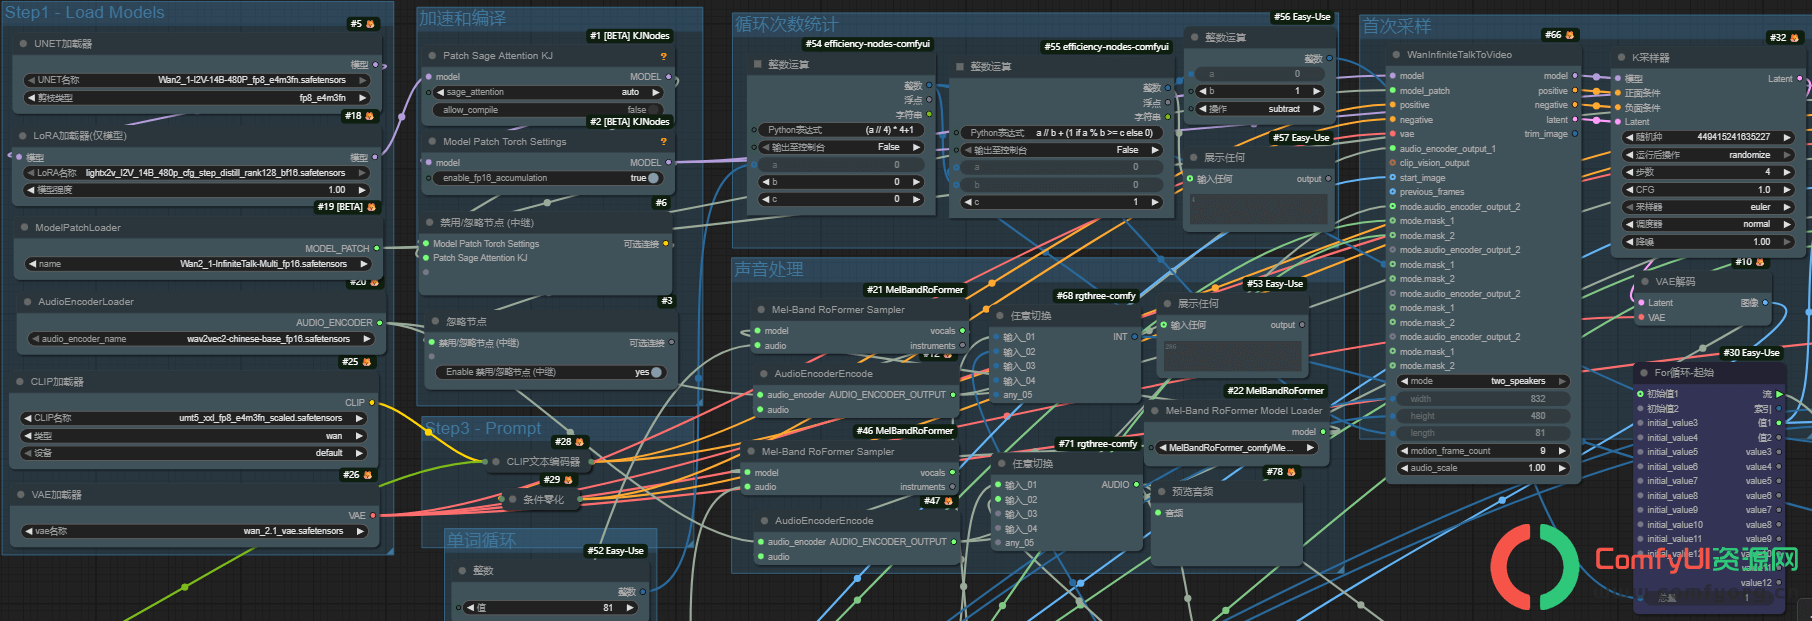
然后是素材的处理,我这里给大家搭建了两种形式,通过分组来使用,不过多轮的我测试了一下午发现效果不大行,所以大家暂时先用默认的。
图片需要上传两次,然后使用遮罩涂抹下要说话的人。 音频也要分别上传一下。
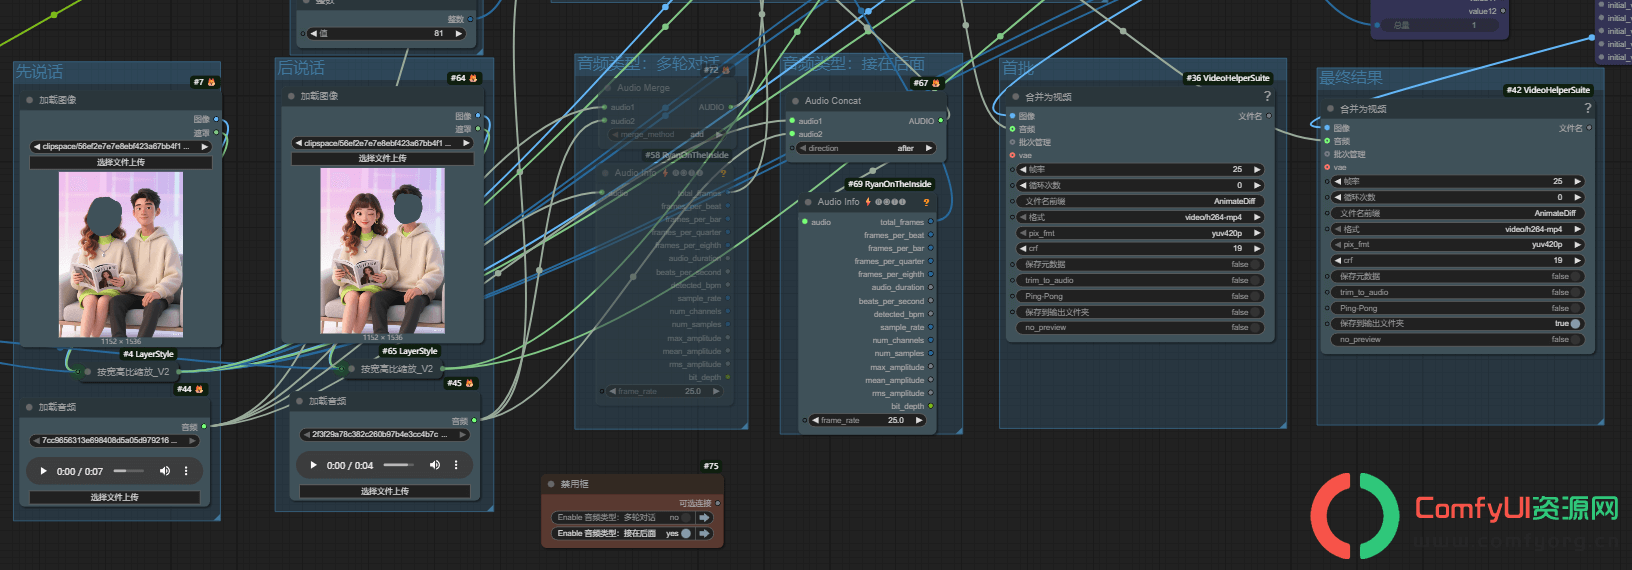
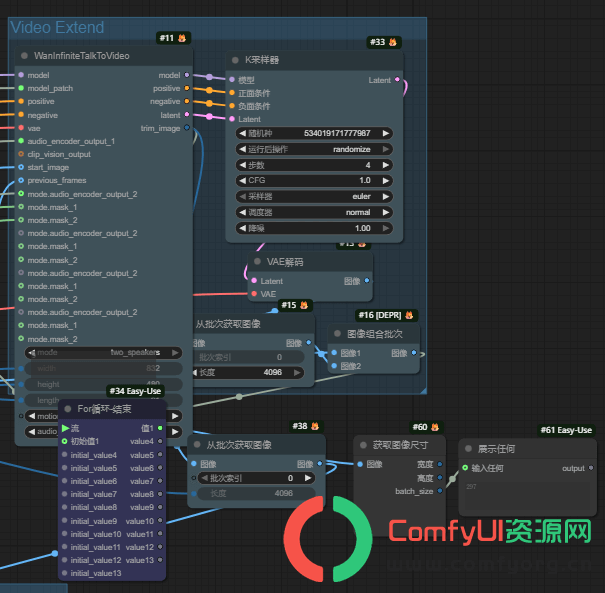
最关键的是在WanInfiniteTalkToVideo里面传入2个音频数据以及各自人物的遮罩。
你需要把mode改成two_speakers,才会出现上面的这些选项。
四、总结:
以前KJ版本那边支持的多人多轮对话,官网我测试下来没效果,就是第二个人不说话。问过其他UP主,也说效果不行,白测了一下午。
所以结论就是,想用多人多轮对话的,继续用之前的KJ版本吧。简单就一轮对话的可以用新的这个,单人的也用官版的。