


一、SoulX-FlashTalk介绍
SoulX-FlashTalk是由Soul AI Lab团队开发的140亿参数数字人生成框架,专为实时、高保真、长时稳定的音频驱动虚拟形象生成而设计。它在2025年底提出,并于2026年初开源,解决了数字人直播中“无限流”场景下的模型崩溃与高延迟难题。它主打的核心场景就是“高保真”与“实时性”。 不仅要画质好,更要速度快,非常适合用在AI 客服、虚拟主播、游戏 NPC 等需要即时反馈的场景。
特点:
- 启动延迟低至0.87秒,比同类方案快约3.3倍。
- 实时吞吐量达32 FPS,画面流畅度远超行业标准。
- 在长达1000秒(约16.7分钟)的连续生成测试中,仍能保持面部几何结构与背景细节的清晰稳定。
项目地址:https://github.com/Soul-AILab/SoulX-FlashTalk
二、相关安装(文末网盘)
插件地址:https://github.com/HM-RunningHub/ComfyUI_RH_FlashTalk
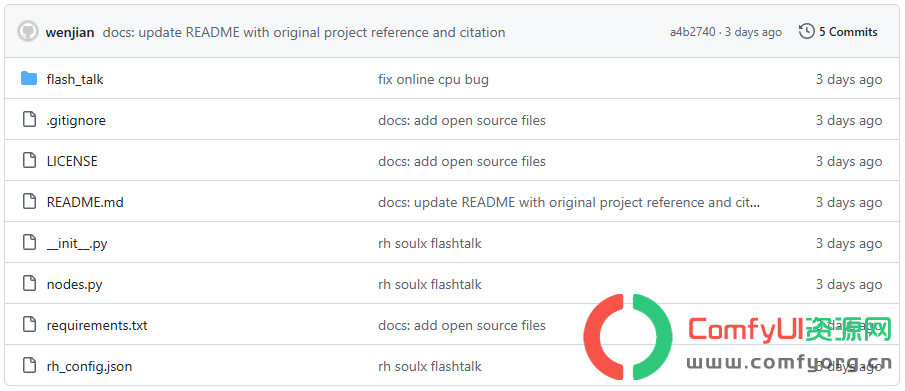
模型主要安装两个
-
SoulX-FlashTalk-14B:https://huggingface.co/Soul-AILab/SoulX-FlashTalk-14B -
https://huggingface.co/Soul-AILab/SoulX-FlashTalk-14B:https://huggingface.co/TencentGameMate/chinese-wav2vec2-base
模型路径:
-
ComfyUI/models/Soul-AILab/SoulX-FlashTalk-14B/ -
ComfyUI/models/wav2vec/chinese-wav2vec2-base/
三、工作流
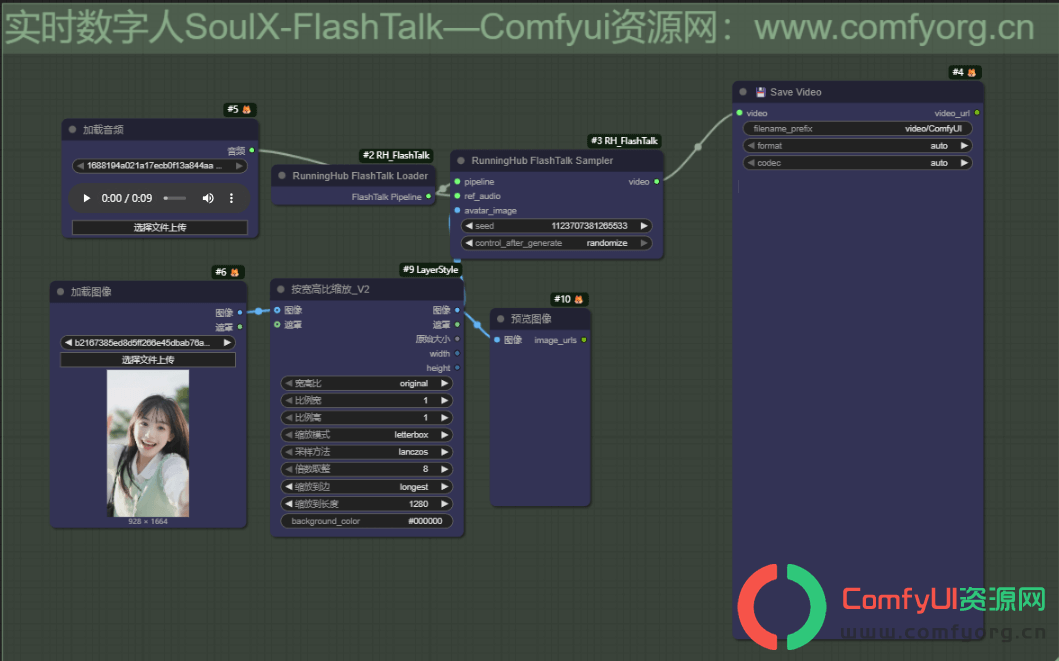
目前我测试下来发现2个问题:
-
不能设定分辨率,不管传入多少,传出来的都是固定的448x768 -
横屏的传入最终出来的也是上面这样的竖屏
效果的话还不错,速度还挺快。
四、案例展示
看几个我实际跑的案例,这里没有涉及到提示词,只要音频+图片就行。
五、总结
SoulX-LiveTalk,一个旨在满足实时要求同时保持高质量视频合成的框架。该框架将双向流媒体蒸馏与多步自校正机制相结合,使本文的14B参数DiT模型能够在8个H800集群上维持稳定、无限长的流媒体。本文的方法还简化了训练,证明了不需要复杂的多阶段预训练。简短的SFT阶段后进行分布匹配蒸馏就足以实现最先进的性能。
未来的工作将优先考虑模型效率而非系统扩展。本文计划探索剪枝、量化和优化的注意力机制。目标是在消费级硬件上部署这些模型,消除对昂贵计算集群的依赖。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。