


阿里云通义今日(1 月 28 日)正式开源发布 Z-Image 基座模型。Z-Image 是一个拥有 6B 参数的高效图像生成基础模型,采用单流扩散变换器架构,适用于社区驱动的微调和自定义开发。
一、Z-Image基座模型介绍
Z-Image(造相) 是阿里巴巴通义实验室开发的一个强大且高效的图像生成模型,拥有 6B 参数。它采用 可扩展单流 DiT(S3-DiT)架构,将文本、视觉语义 token 和图像 VAE token 在序列级别进行拼接,作为统一的输入流,最大化参数效率。Z-Image(Base)是非蒸馏基础模型,专为社区驱动的微调和自定义开发而设计。
模型亮点:
- 照片级真实质量:在保持出色美学质量的同时,提供强大的照片级真实图像生成
- 精准的双语文本渲染:擅长准确渲染复杂的中英文文本
- 提示词增强与推理:提示词增强器赋予模型推理能力
- 微调就绪:适合自定义训练和适配的理想基础模型
Z-Image和Z-Image-Turbo区别?
| 特性 | Z-Image (基座版) | Z-Image-Turbo (加速版) |
|---|---|---|
| CFG 支持 | ✅ 支持 | ❌ 不支持 |
| 推理步数 | 28 ~ 50 步 | 8 步 |
| 微调潜力 | ✅ 极高 (适合训练 LoRA) | ❌ 较低 |
| 生成多样性 | 高 | 低 |
| 视觉质量 | 高 (细节纹理丰富) | 极高 (侧重整体观感) |
Z-Image-Turbo详细信息:https://www.comfyorg.cn/2837.html
二、模型安装(文末网盘)
Z-Image 已经集成到了 diffusers 库中,开发者可以轻松调用。comfyUI官方已支持,更新最新版本comfyUI,下载模型即可。
Z-image-bf16.safetensors模型:https://huggingface.co/Comfy-Org/z_image/tree/main/split_files/diffusion_models
GGUF量化模型:https://huggingface.co/jayn7/Z-Image-GGUF/tree/main
模型路径:
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 text_encoders/
│   │      └── qwen_3_4b.safetensors
│   ├── 📂 diffusion_models/
│   │      └── z_image_bf16.safetensors
│   └── 📂 vae/
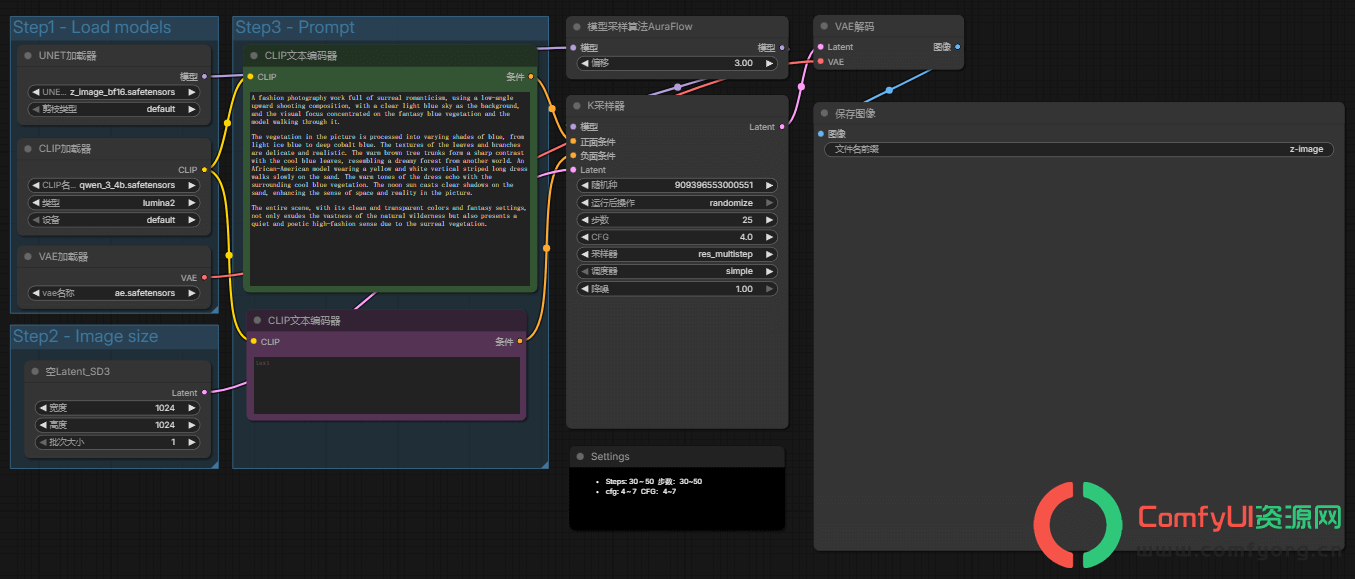
│ └── ae.safetensors三、工作流


四、总结
Z-Image 不仅仅是一个生成工具,它更是一个高效、稳健的图像生成底座。如果你需要进行深度的模型定制、追求极致的提示词受控度,或者正在寻找一个可靠的 LoRA 训练底模,Z-Image 无疑是 2026 年开源界最值得关注的选择之一。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
这个好