


2026年1月22日,阿里巴巴通义实验室旗下的 Qwen 团队正式宣布 Qwen3-TTS 系列模型全面开源,并同步发布 GitHub 仓库 QwenLM/Qwen3-TTS。这一消息迅速在 AI 社区引发热议——不仅因为其技术实力远超预期,如今,它竟以完整、可本地部署、支持微调的开源姿态亮相,堪称一场“意料之外,情理之中”的技术馈赠。
一、什么是Qwen3-TTS?
Qwen3-TTS是由Qwen开发的一系列功能强大的语音生成,全面支持音色克隆、音色创造、超高质量拟人化语音生成,以及基于自然语言描述的语音控制,为开发者与用户提供最全面的语音生成功能。Qwen3-TTS 多码本全系列模型均已开源,包含1.7B和0.6B两种尺寸,1.7B可以达到极致性能,具有强大的控制能力,0.6B均衡性能与效率。模型覆盖 10 种主流语言(中文、英文、日语、韩语、德语、法语、俄语、葡萄牙语、西班牙语、意大利语)及多种方言音色,满足全球化应用需求。
- 超自然的语音表现力:能根据自然语言指令控制语调、情绪、语速,甚至方言口音。
- 3秒极速克隆:只需一段3秒音频+对应文本,即可复刻说话人声线。
- 多语言覆盖:支持中、英、日、韩、德、法、俄、葡、西、意等10种主流语言。
- 极低延迟流式生成:端到端延迟低至 97ms,真正满足实时对话场景。
二、相关安装
模型一共分成1.7B和0.6B(推荐使用1.7B)
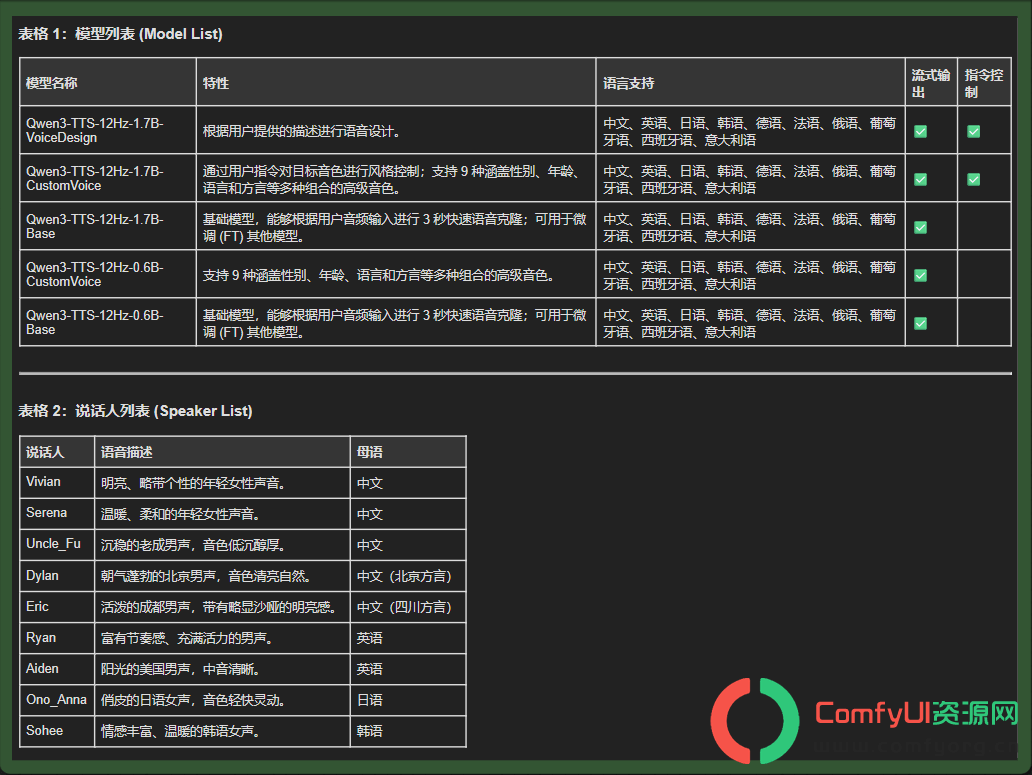
Qwen3-TTS-12Hz-1.7B-VoiceDesign- 支持声音设计Qwen3-TTS-12Hz-1.7B-CustomVoice- 支持自定义声音Qwen3-TTS-12Hz-1.7B-Base- 支持声音克隆Qwen3-TTS-12Hz-0.6B-CustomVoice- 轻量版自定义声音Qwen3-TTS-12Hz-0.6B-Base- 轻量版基础模型Qwen3-TTS-Tokenizer-12Hz- 分词器模型
| 模型 | 功能 | 语种支持 | 流式生成 | 指令控制 |
|---|---|---|---|---|
| Qwen3-TTS-12Hz-1.7B-VoiceDesign | 根据用户输入描述进行音色创造。 | 中、英、日、韩、德、法、俄、葡萄牙、西班牙、意大利 | ✅ | ✅ |
| Qwen3-TTS-12Hz-1.7B-CustomVoice | 根据用户输入指令对目标音色进行风格控制;支持9个精品音色,涵盖多种性别、年龄、语种与方言组合。 | 中、英、日、韩、德、法、俄、葡萄牙、西班牙、意大利 | ✅ | ✅ |
| Qwen3-TTS-12Hz-1.7B-Base | 基座模型,可以根据用户输入音频进行3s快速音色克隆,可用于FT到其他模型。 | 中、英、日、韩、德、法、俄、葡萄牙、西班牙、意大利 | ✅ | |
| 模型 | 功能 | 语种支持 | 流式生成 | 指令控制 |
| Qwen3-TTS-12Hz-0.6B-CustomVoice | 支持9个精品音色,涵盖多种性别、年龄、语种与方言组合。 | 中、英、日、韩、德、法、俄、葡萄牙、西班牙、意大利 | ✅ | |
| Qwen3-TTS-12Hz-0.6B-Base | 基座模型,可以根据用户输入音频进行3s快速音色克隆,可用于FT到其他模型。 | 中、英、日、韩、德、法、俄、葡萄牙、西班牙、意大利 | ✅ |
插件安装:
https://github.com/HAIGC/Comfyui-HAIGC-QwenTTS
1. 安装依赖
安装 Qwen3-TTS 所需的核心依赖:
pip install torch torchaudio transformers librosa soundfile accelerate注意: 如果您的环境中已安装这些依赖,可以跳过此步骤。本插件的 requirements.txt 可能包含其他可选依赖。
2. 下载模型
将 Qwen3-TTS 模型下载到以下目录:
模型下载地址:https://huggingface.co/collections/Qwen/qwen3-tts
本地存放模型路径:ComfyUI\models\qwen-tts
ComfyUI/models/qwen-tts/{model_folder_name}/模型文件夹命名规则:
- 从
Qwen/Qwen3-TTS-12Hz-1.7B-VoiceDesign提取为Qwen3-TTS-12Hz-1.7B-VoiceDesign - 确保文件夹名称与模型名称的后缀部分一致
- 模型必须已存在于
ComfyUI/models/qwen-tts/目录中,本插件不提供自动下载功能 - 模型路径固定为
ComfyUI/models/qwen-tts/,不支持自定义路径 - 模型加载时会自动检查本地文件,不会尝试从网络下载
模型路径:
ComfyUI/
└── models/
    └── qwen-tts/
        ├── Qwen3-TTS-12Hz-1.7B-VoiceDesign/
        ├── Qwen3-TTS-12Hz-1.7B-CustomVoice/
        └── Qwen3-TTS-12Hz-1.7B-Base/
三、工作流及体验
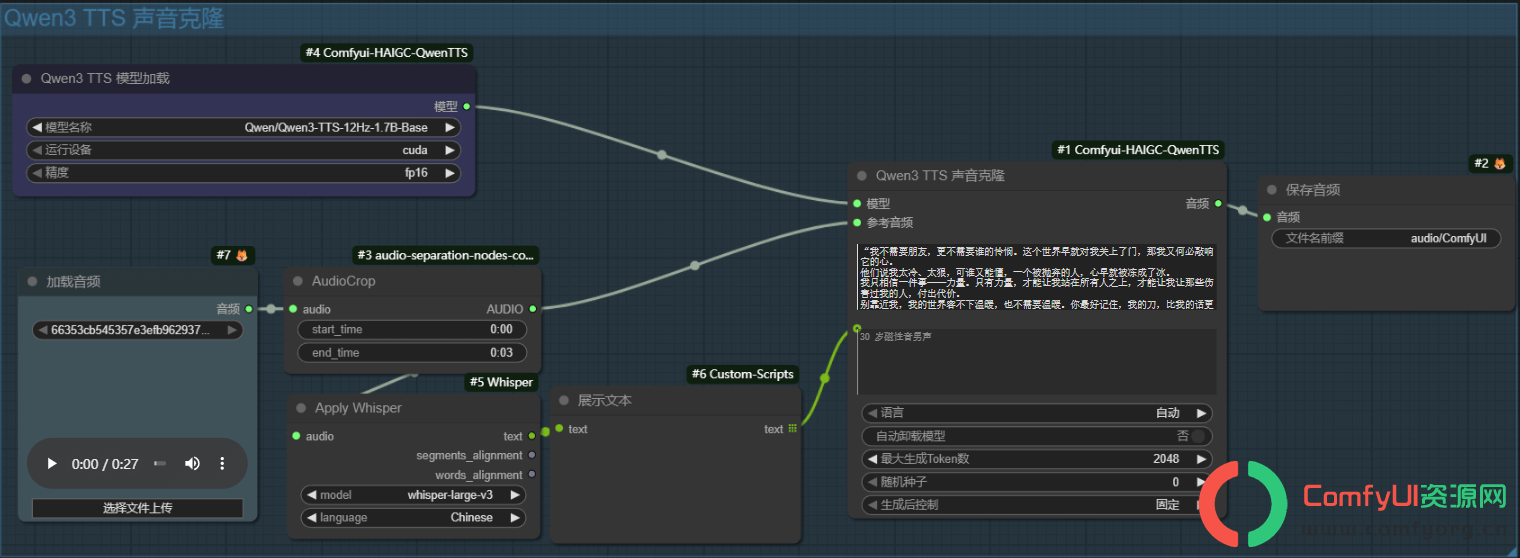
Qwen3 TTS 声音克隆
基于参考音频克隆声音并生成语音。
输入参数:
模型: 从模型加载节点获取文本: 要合成的文本内容参考音频: 参考音频对象(AUDIO 类型)参考文本(可选): 参考音频对应的文本内容语言(可选): 自动 / 中文 / 英文 / 日文 / 韩文等自动卸载模型(可选): 生成后是否卸载模型以释放显存最大生成Token数(可选): 限制生成的最大长度,默认 2048随机种子(可选): 生成随机性控制生成后控制(可选): 固定 / 增加 / 减少 / 随机
输出:
音频: 生成的音频对象(AUDIO 类型)
模型要求: 需要加载带有 "Base" 的模型。
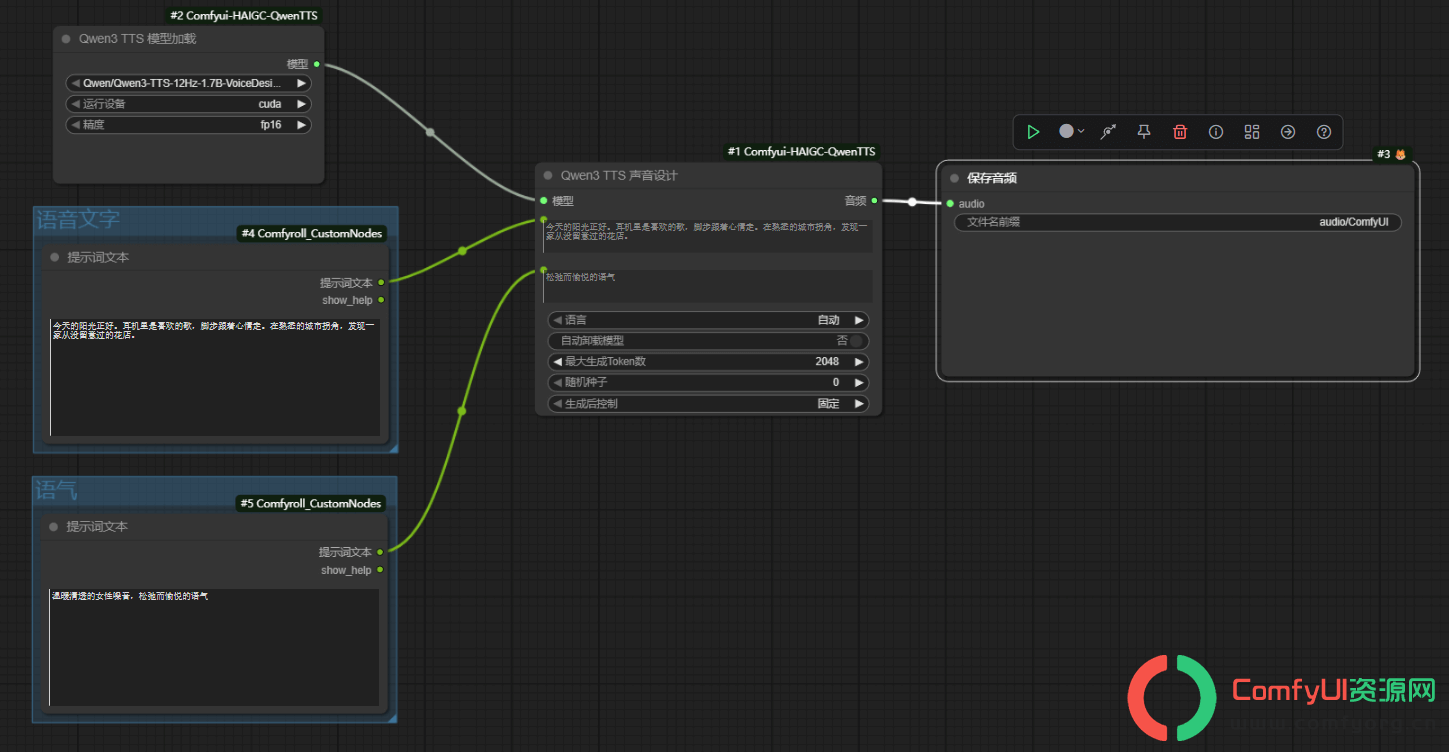
Qwen3 TTS 声音设计
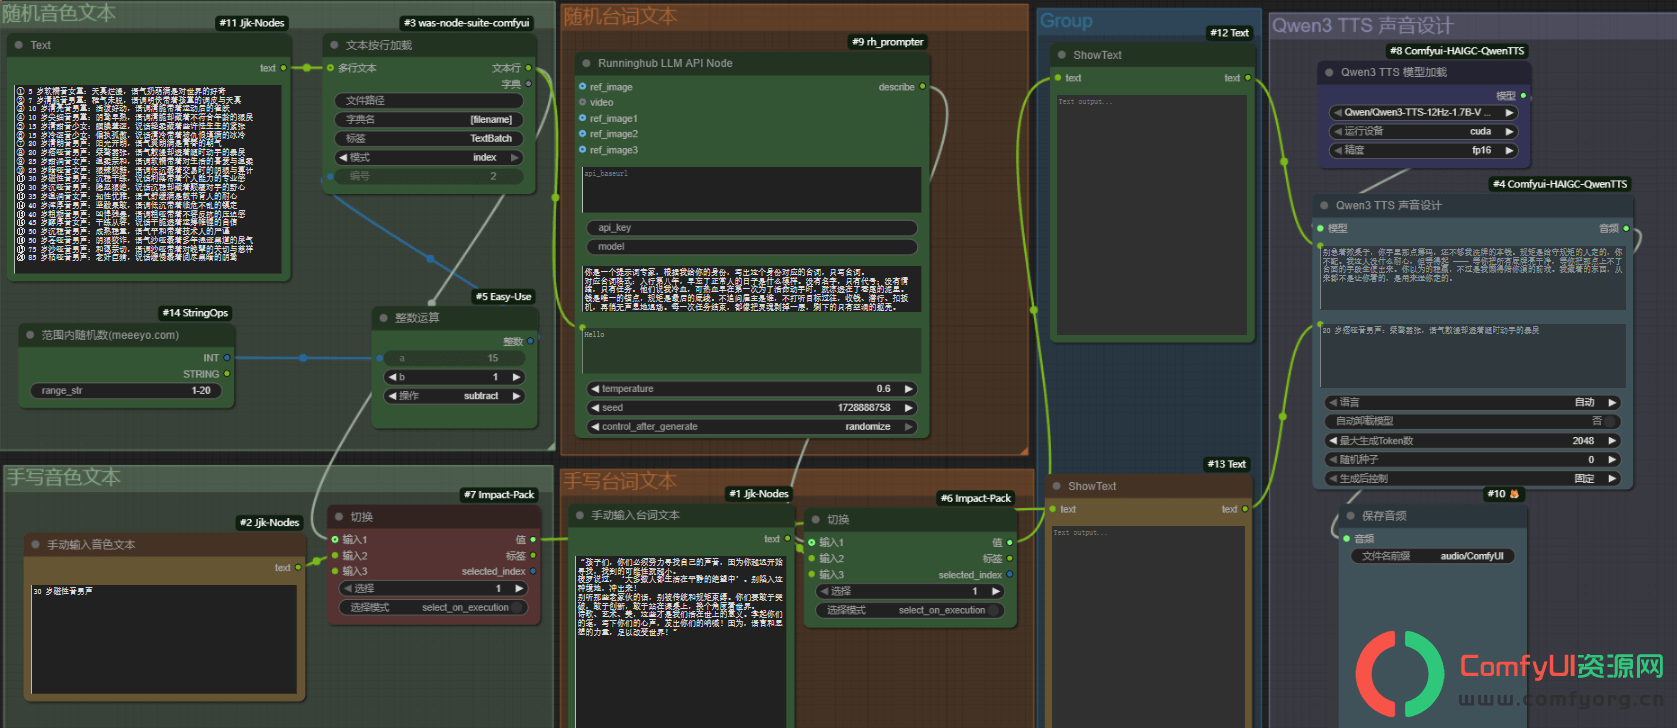
基于文本提示词生成自定义声音的语音。
输入参数:
模型: 从模型加载节点获取文本: 要合成的文本内容提示词: 声音描述提示词(如:"A young female voice, energetic and bright.")语言(可选): 自动 / 中文 / 英文 / 日文 / 韩文等自动卸载模型(可选): 生成后是否卸载模型以释放显存最大生成Token数(可选): 限制生成的最大长度,默认 2048随机种子(可选): 生成随机性控制生成后控制(可选): 固定 / 增加 / 减少 / 随机
输出:
音频: 生成的音频对象(AUDIO 类型)
模型要求: 需要加载带有 "VoiceDesign" 的模型。
Qwen3 TTS 自定义声音
使用预设说话人或自定义提示词生成语音。
输入参数:
模型: 从模型加载节点获取文本: 要合成的文本内容预设说话人: 选择预设说话人(Vivian, Serena, Uncle_Fu, Dylan, Eric, Ryan, Aiden, Ono_Anna, Sohee)语言(可选): 自动 / 中文 / 英文 / 日文 / 韩文等提示词(可选): 自定义声音描述,会覆盖预设说话人的默认提示词自动卸载模型(可选): 生成后是否卸载模型以释放显存最大生成Token数(可选): 限制生成的最大长度,默认 2048随机种子(可选): 生成随机性控制生成后控制(可选): 固定 / 增加 / 减少 / 随机
预设说话人:
Vivian: 明亮、略带锋芒的年轻女声Serena: 温暖、温柔的年轻女声Uncle_Fu: 成熟、低沉的男声Dylan: 年轻、清晰的北京男声Eric: 活泼、略带沙哑的成都男声Ryan: 充满活力的男声,节奏感强Aiden: 阳光、清晰的美国男声Ono_Anna: 活泼、轻快的日本女声Sohee: 温暖、情感丰富的韩国女声
输出:
音频: 生成的音频对象(AUDIO 类型)
模型要求: 需要加载带有 "CustomVoice" 的模型。
四、工作流及体验
在线工作流:https://www.runninghub.cn/post/2014884851198992385
主页:https://qwen.ai/blog?id=qwen3tts-0115
示例:
总结:
Qwen3-TTS 支持将已创建的音色进行持久化存储与重复调用,可用于多轮、多角色的长篇对话生成,为数字人、虚拟客服、内容创作等场景提供更灵活的语音底层能力。
运行时一直报错缺失啥attion2
报错缺少heartmula_comfyui 这个节点