


什么是LTX-2?
LTX-2是一个基于扩散变换器(DiT)架构构建的开源音视频基础模型。与传统的生成静音视频的视频生成模型不同,LTX-2同时生成动作、对话、音效和音乐,确保视觉和音频元素之间的完美同步。
核心特性
同步音视频生成: LTX-2的独特架构同时生成两种模态,无需单独的音频合成和同步步骤。
多种模型变体: 根据你的硬件和质量要求选择合适的检查点:
| 模型 | 描述 | 使用场景 |
|---|---|---|
| ltx-2-19b-dev | 完整模型,bf16格式 | 训练和微调 |
| ltx-2-19b-dev-fp8 | FP8量化 | 平衡质量和速度 |
| ltx-2-19b-dev-fp4 | NVFP4量化 | 3倍速度,减少60% VRAM |
| ltx-2-19b-distilled | 8步蒸馏版本 | 快速生成,CFG=1 |
| ltx-2-19b-distilled-lora-384 | LoRA版本 | 微调和定制 |
二、相关安装
LTX-2需要自定义节点才能与ComfyUI集成。最简单的安装方法是使用ComfyUI Manager。
ComfyUI-LTXVideo插件:https://github.com/Lightricks/ComfyUI-LTXVideo
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
模型下载:
LTX-2需要几个模型文件。首次使用时,ComfyUI会尝试自动下载,但手动下载可确保你获得正确的版本。
模型存储位置
ComfyUI在特定目录中组织模型:
📂 ComfyUI/
└ 📂 models/
│   └ 📂 checkpoints/
│   │      └ ltx-2-19b-dev.safetensors
│   │      └── ltx-2-19b-dev-fp8.safetensors
│   └ 📂 text_encoders/
│   │      └── gemma_3_12B_it.safetensors
│   └ 📂 loras/
│   │      └ ltx-2-19b-distilled-lora-384.safetensors
│   │      └── ltx-2-19b-lora-camera-control-dolly-left.safetensors
│   └── 📂 latent_upscale_models/
│          └── ltx-2-spatial-upscaler-x2-1.0.safetensors
用户可通过ComfyUI部署,使用时需下载主模型、VAE及专用CLIP(如gemma_3系列),并推荐使用48G显存以上设备运行。若使用NVIDIA 50系显卡报错,可在启动参数中添加--disable-xformers以解决(秋叶左侧,高级选项,拉到最底下有个自定义参数)。
三、工作流
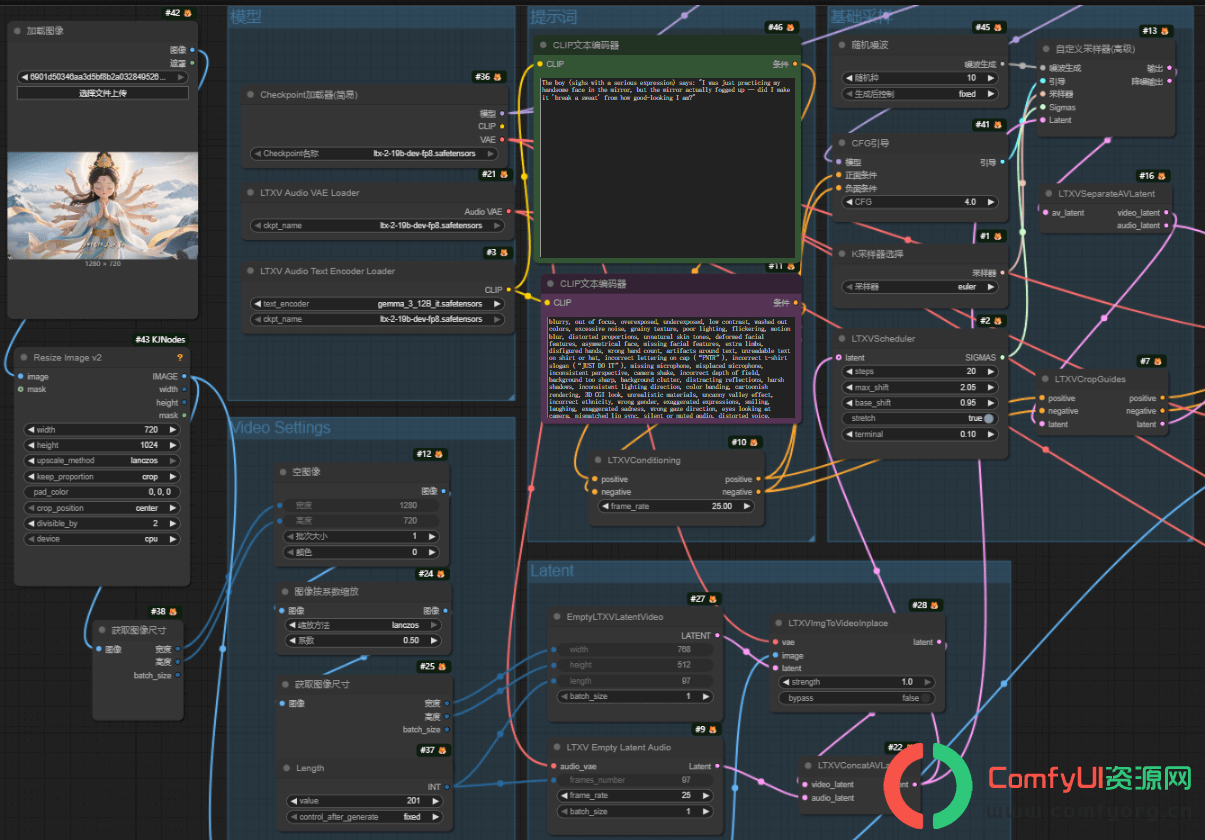
尺寸要求:
宽度和高度的设置必须是 32 的倍数加 1。
帧数必须是 8 的倍数加 1。
使用无效参数运行不会导致报错。相反,工作流会自动静默选择最接近的有效参数。
默认情况下,我们使用 720p 分辨率。如果您的 GPU 性能强劲,可以尝试 1920*1088。
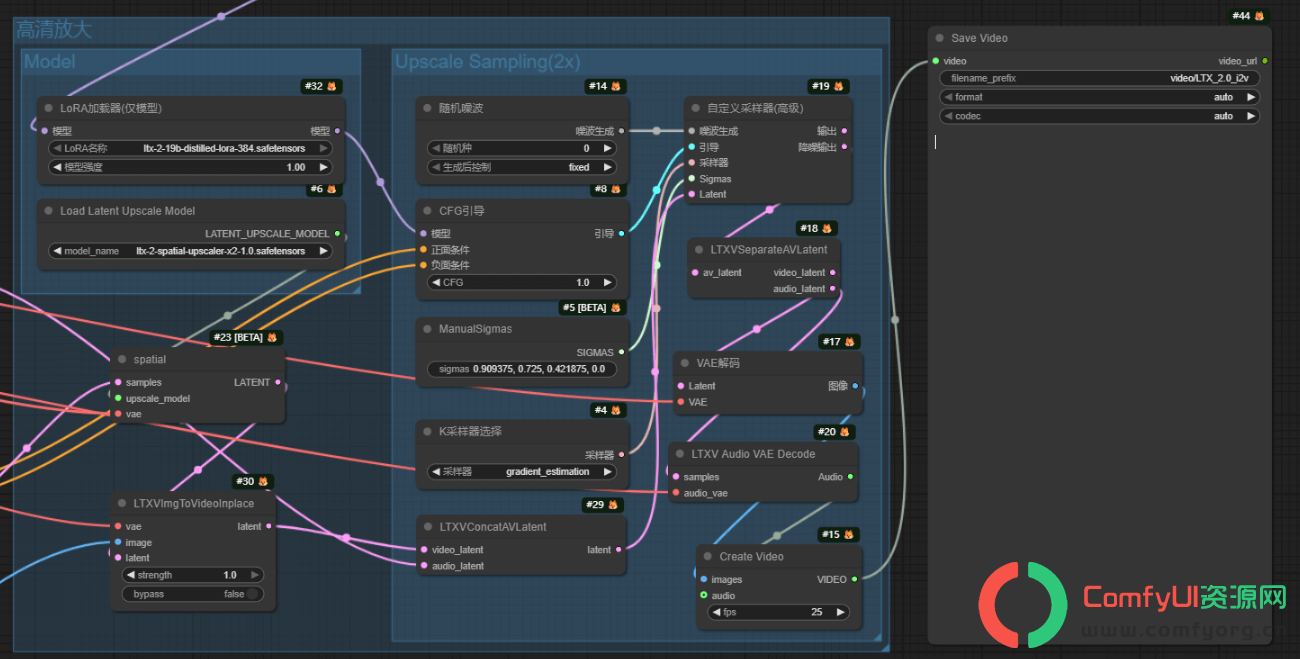
图生视频工作流示例:
LTX-2的提示词工程:
官方提示词使用手册:https://ltx.io/model/model-blog/prompting-guide-for-ltx-2
LTX-2对描述性、场景聚焦的提示词响应最好。遵循以下指南:
良好的提示词结构:
[主体] [动作] [场景] [氛围/风格] [镜头运动] [音频描述]示例提示词:
简单场景:
一只金毛寻回犬小狗在阳光明媚的花园里玩耍,兴奋地摇着尾巴。
轻柔的环境音,鸟儿鸣叫和树叶沙沙作响。缓慢的镜头平移。复杂场景:
一位穿着粉色制服的1950年代餐厅女服务员在柜台为顾客端咖啡。
复古美学,温暖的灯光。镜头从左向右推移。
背景喧闹声、餐具碰撞声和欢快的爵士乐。
结论
LTX-2.0是Lightricks推出的开源视频生成模型,支持文生视频、图生视频及深度转视频等多种任务,具备生成4K分辨率视频、最长可达20秒且内置同步音频的能力。该模型突破了此前5秒时长和480P分辨率的限制,采用二阶段采样流程,结合空间与时间升频模块提升画质,并引入蒸馏模型优化性能。LTX-2将专业级同步音视频生成带到了ComfyUI,使消费级硬件上的高级AI视频创作成为可能。
大佬、请问这个和万象2.2版有何不同?