


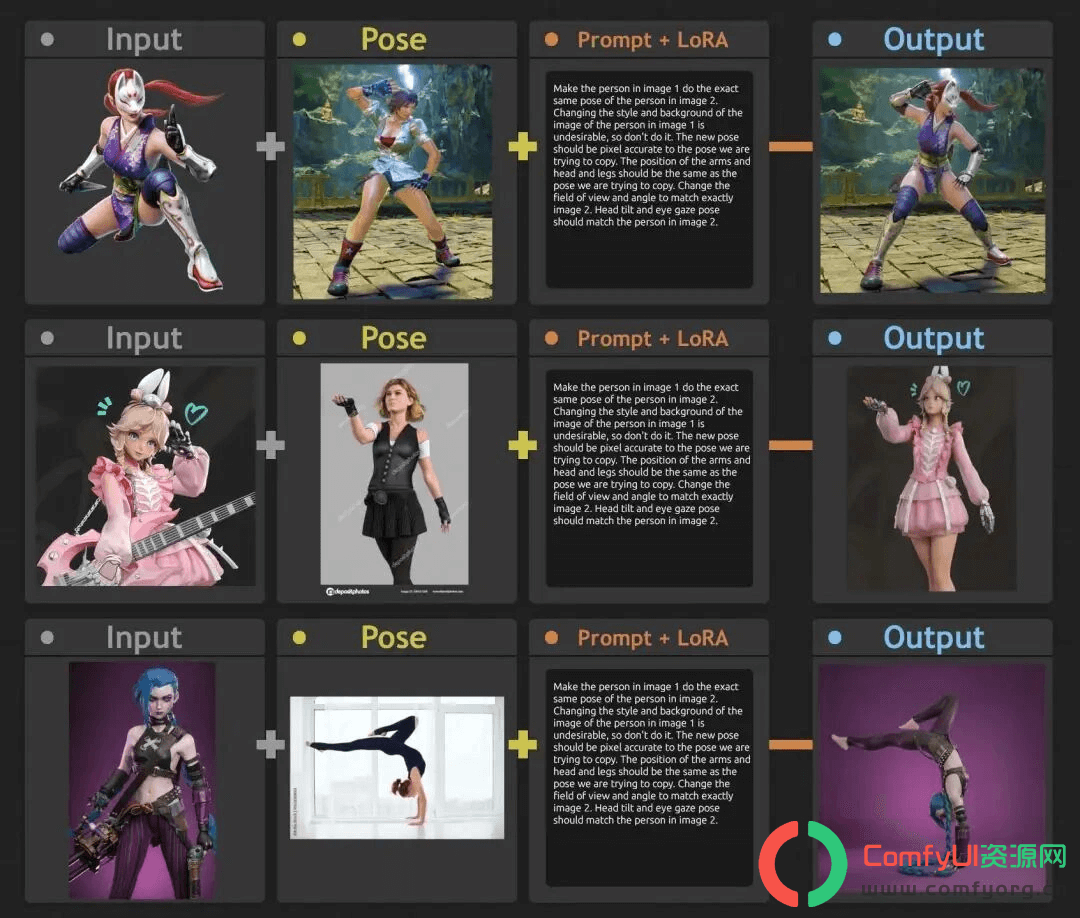
基于 Qwen-Image-Edit-2511 的 lora 技术,AnyPose 能够通过动作参考图来调整特定人物的动作,仅需一句提示词,参考图姿态即可完美“瞬移”给原图人物!4步极速出图。解决 ControlNet 姿势控制无效的痛点,用 AnyPose lora 轻松实现人物姿势替换, 还分享了复杂姿势避坑、服装细节保留的提示词技巧; 两种放大方案实测对比,按需选择 4K 超清输出或零偏移放大,全程无废话纯实操!
一、AnyPose姿势lora介绍
随着Qwen-Image-Edit-2511的发布,周边lora生态跟上的挺快,今天分享的这个lora是用来提高姿势参考的成功率的,不需要再转成骨架图,直接参考原图就可以。
以前 ControlNet 最大的痛点是,如果参考图里的人被遮挡了,或者姿势太扭曲,OpenPose 经常识别不出来,或者少一条胳膊。
AnyPose 是基于语义理解的。它“看懂”了参考图里的动作,而不是死板地去对齐骨骼点。这意味着即使是复杂的遮挡动作,它也能通过 AI 的脑补能力,画出合理的肢体。
🌟 功能亮点:
- 专为Qwen Image Edit 2511设计
- 免去复杂骨骼标注,直接图像驱动
- 支持自定义IP与各类动态姿势 轻松实现姿势迁移,让人物活起来
二、相关安装
模型地址:https://huggingface.co/lilylilith/AnyPose/tree/main

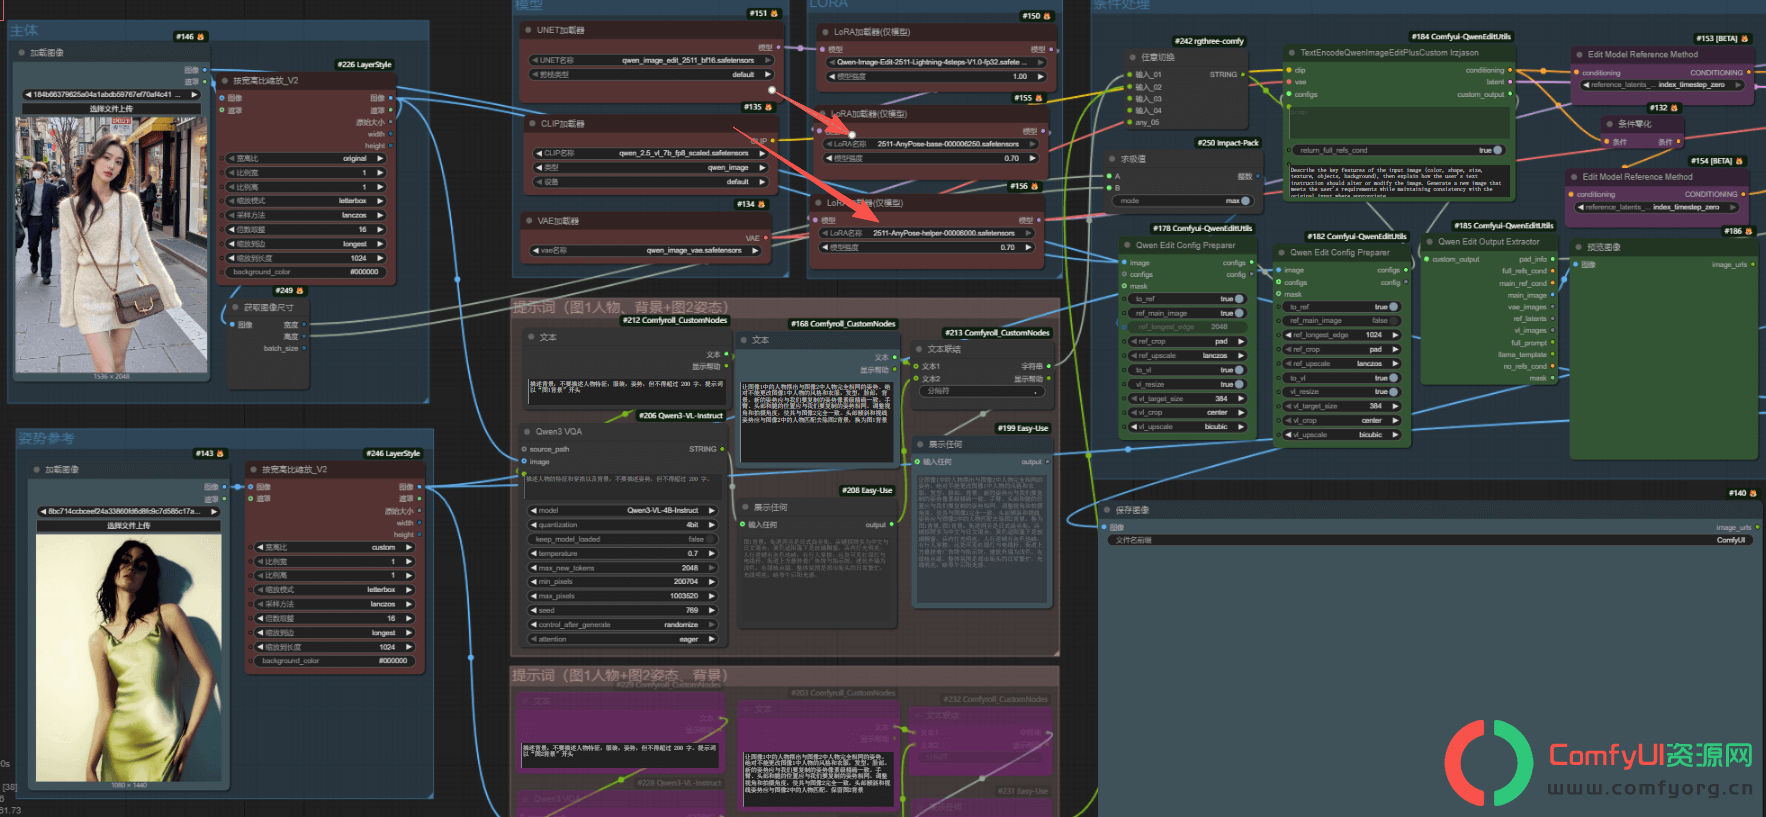
这里配套的是两个Lora模型,权重作者推荐都用0.7
- 2511-AnyPose-base-000006250.safetensors
- 2511-AnyPose-helper-00006000.safetensors
模型路径:
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 text_encoders/
│   │      └── qwen_2.5_vl_7b_fp8_scaled.safetensors
│   ├── 📂 loras/
│   │      └── Qwen-Image-Edit-2511-Lightning-4steps-V1.0-bf16.safetensors
│   │      └── 2511-AnyPose-base-000006250.safetensors
│   │      └── 2511-AnyPose-helper-00006000.safetensors
│   ├── 📂 diffusion_models/
│   │      └── qwen_image_edit_2511_bf16.safetensors
│   └── 📂 vae/
│          └── qwen_image_vae.safetensors
固定提示词:
Make the person in image 1 do the exact same pose of the person in image 2. Changing the style and background of the image of the person in image 1 is undesirable, so don't do it. The new pose should be pixel accurate to the pose we are trying to copy. The position of the arms and head and legs should be the same as the pose we are trying to copy. Change the field of view and angle to match exactly image 2. Head tilt and eye gaze pose should match the person in image 2.
三、工作流及体验
上传:
1️⃣ 你的动漫角色图
2️⃣ 任意姿势参考图
加载模型:
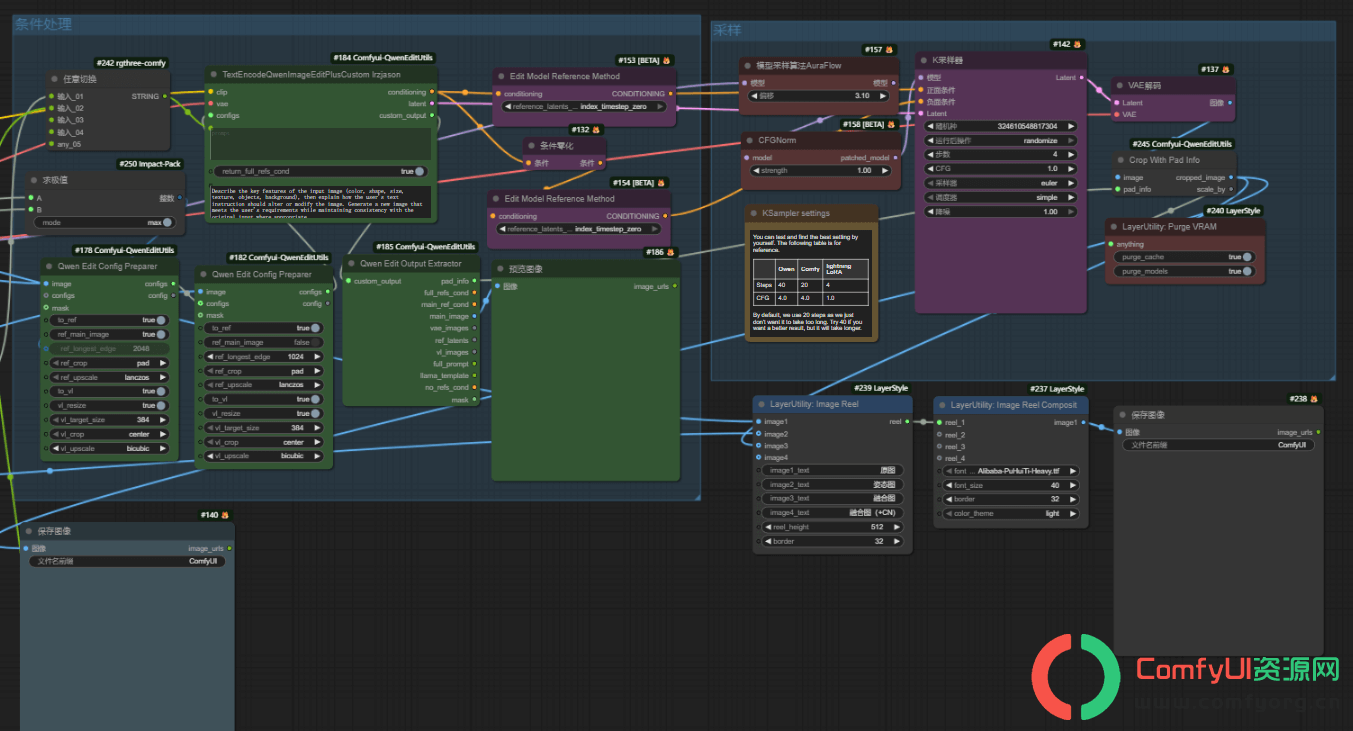
AnyPose LoRA,设置强度为0.7,复制提示词,一键运行—10秒即可生成角色同步姿势的图片!
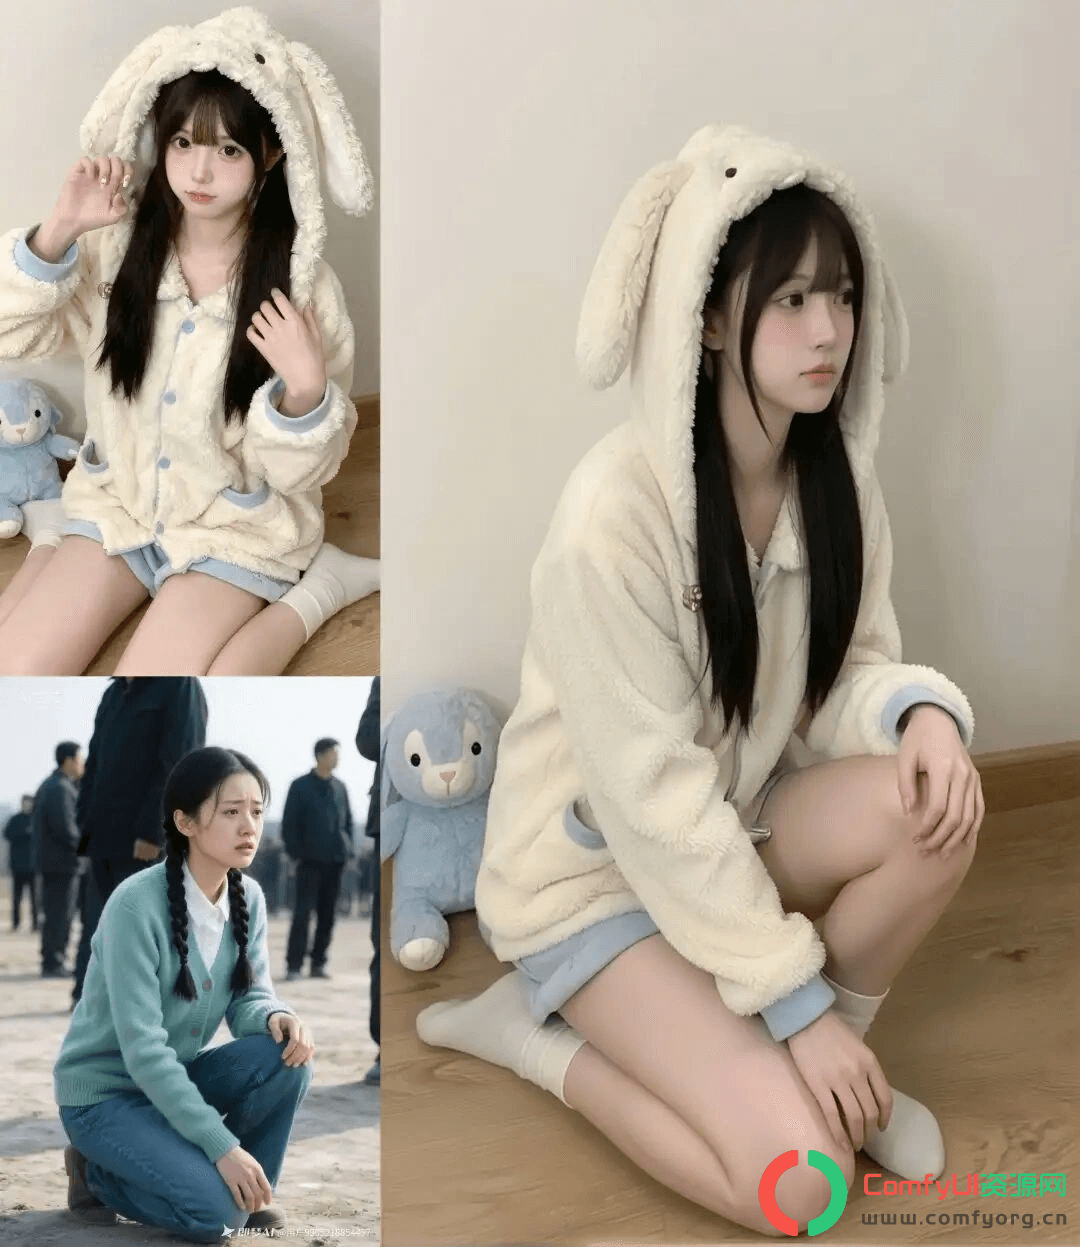
案例展示
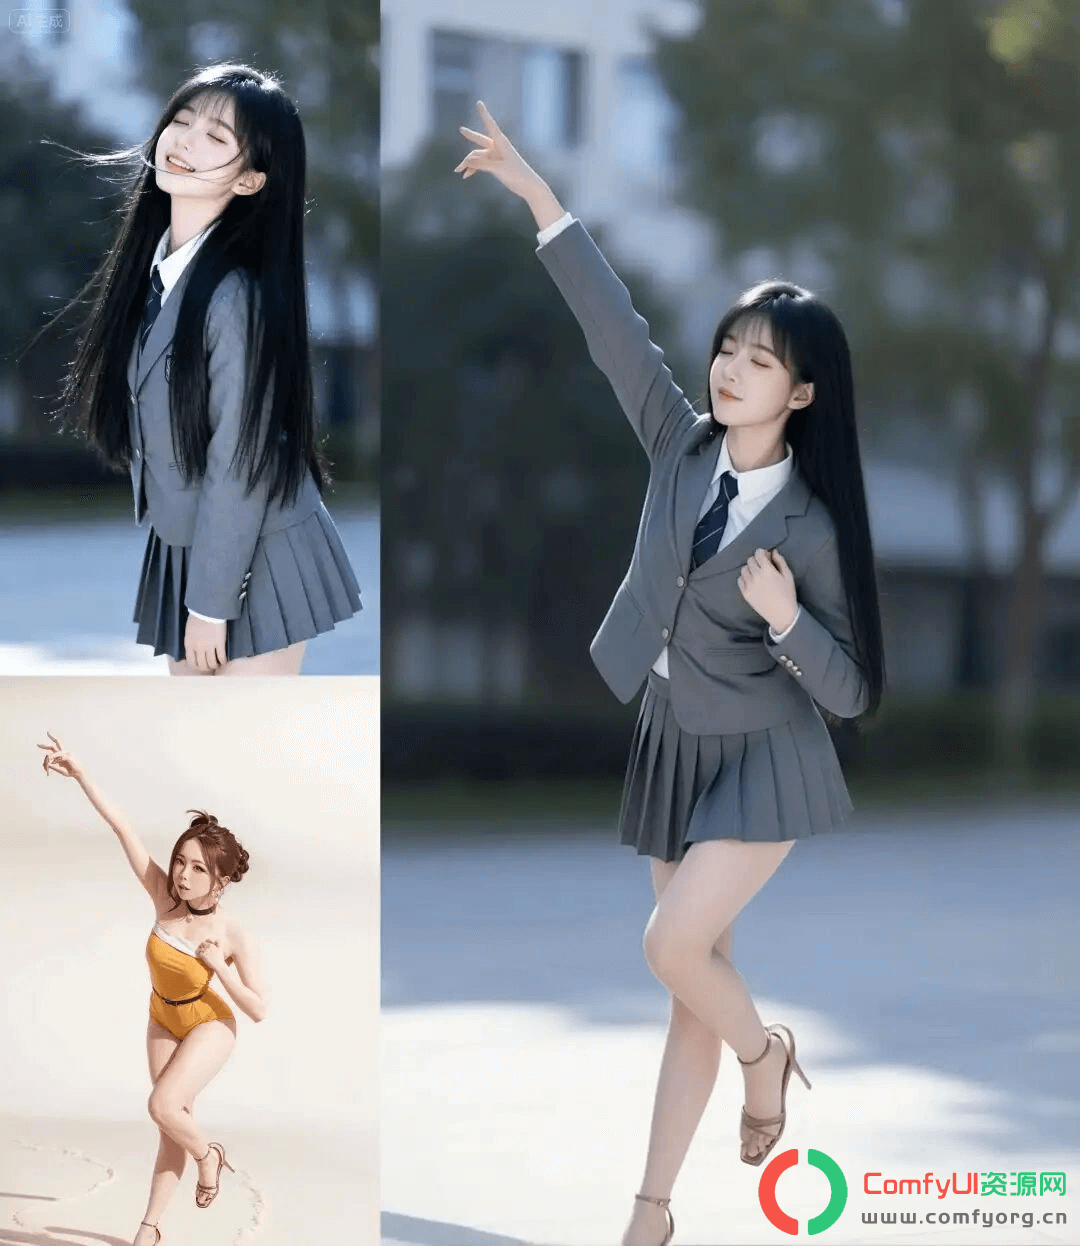
我跑了一些案例,确实成功率会比单纯用2511跑来的高,所以这套lora模型还是有效果的,推荐大家也用起来。
总结:
使用适用于 Qwen Image Edit 2511 的 4 步 lightning LoRA。将 AnyPose 的两个 LoRA 权重(基础版和辅助版)强度均设置为 0.7。上传两张图像,一张包含初始输入的角色,另一张包含你希望复制到第一个角色上的姿势。使用以下提示词:“让图像 1 中的人物做出与图像 2 中的人物完全相同的姿势。不希望改变图像 1 中人物的风格和背景,所以请勿进行此类修改。新姿势应与我们试图复制的姿势在像素级别上精确一致。手臂、头部和腿部的位置应与我们试图复制的姿势完全相同。改变视野和角度以精确匹配图像 2。头部倾斜和凝视方向应与图像 2 中的人物匹配。” 如果需要额外信息(例如模型未见过的服装),请在末尾补充提示。背景未与初始输入图像保持一致?在末尾添加:“移除图像 2 的背景,并替换为图像 1 的背景。”
目前计划推出 V2 版本来解决部分此类问题,同时将支持更多独特/非类人角色,并提升姿态迁移的整体一致性。
欢迎对权重进行试验!我们始终鼓励更多的尝试! 😃
膜拜大佬
膜拜大神,谢谢分享