


一、Qwen-Image-i2L介绍
最近阿里开源的图像模型家族里,多了个很有意思的新角色——Qwen-Image-i2L。简单说,它干的一件事就是:“给它一张图,它还你一个 lora。”对于玩 AIGC、撸大模型工作流的同学来说,这基本属于“生产力暴击”级别的更新。
以前我们想搞一个专属画风 lora,基本流程是:找一堆素材图、清洗、标注、调参、训练,一套下来少说也要折腾几小时甚至几天。而 Qwen-Image-i2L 直接把这件事缩减成一句话: 你只需要给它一张代表性图片,它就能自动分析出这张图的“风格基因”,打包成一个可复用的 LoRA 模块。
Qwen-Image-i2L 背后用的是SigLIP2 + DINOv3 + Qwen-VL这套多模态特征提取组合,相当于给图片做了一次“深度体检”,把一张图拆解成多种可学习要素,比如:画风和整体美学气质,人物或物体的造型特征,构图习惯、镜头感,色彩倾向、光影风格。
这些信息最终会被压缩成一个轻量级 LoRA。好处很直接:体积小,加载快;可以直接挂在你的生成模型上使用;非常适合做“单图风格迁移”——比如把一张插画的风格搬到你的角色设计上,把某个漫画分镜的色调迁移到别的场景里。
二、相关安装
ComfyUI_RH_QwenImageI2L(Image-to-LoRA):https://github.com/HM-RunningHub/ComfyUI_RH_QwenImageI2L
相关模型
- Qwen-Image-i2L-Style.safetensors:第一个称得上训练成功的模型,它的细节保持能力非常弱,但这反而让它能够有效地提取出图片中的风格信息,因此这个模型可用于风格迁移。
- Qwen-Image-i2L-Coarse.safetensors:它产生的 LoRA 已经能够保留图片中的内容信息,但细节并不完善。如果将这个模型用于风格迁移,则需要输入更多图片,否则模型将倾向于生成输入图片中的内容。我们不建议单独使用这个模型。
- Qwen-Image-i2L-Fine.safetensors: Qwen-Image-i2L-Coarse 的增量更新版本,必须与 Qwen-Image-i2L-Coarse 同时使用。它将 Qwen-VL 的图像编码分辨率提高到了 1024 x 1024
- Qwen-Image-i2L-Bias.safetensors:静态的补充 LoRA其生成的 LoRA 生成的图片与 Qwen-Image 的偏好对齐不一致。使用此 LoRA 模型后,生成的图片会更接近 Qwen-Image 的风格。
1)插件安装:
cd ComfyUI/custom_nodes
git clone https://github.com/HM-RunningHub/ComfyUI_RH_QwenImageI2L.git
安装 Python 依赖:
cd ComfyUI/custom_nodes/ComfyUI_RH_QwenImageI2L
pip install -r requirements.txt
2)安装 DiffSynth-Studio(必须)
本项目依赖 DiffSynth-Studio 提供的 diffsynth。请安装最新版:
git clone https://github.com/modelscope/DiffSynth-Studio.git
cd DiffSynth-Studio
pip install -e .部分模型仓库需要 Git LFS:
git lfs install安装完成后重启 ComfyUI,节点才会出现在菜单中。
模型路径:
ComfyUI/models/
├─ DiffSynth-Studio/
│  ├─ General-Image-Encoders/
│  │  ├─ SigLIP2-G384/model.safetensors
│  │  └─ DINOv3-7B/model.safetensors
│  └─ Qwen-Image-i2L/
│     ├─ Qwen-Image-i2L-Style.safetensors
│     ├─ Qwen-Image-i2L-Coarse.safetensors
│     ├─ Qwen-Image-i2L-Fine.safetensors
│     └─ Qwen-Image-i2L-Bias.safetensors
└─ Qwen/
   ├─ Qwen-Image/
   │  └─ text_encoder/model*.safetensors
   └─ Qwen-Image-Edit/
      └─ processor/
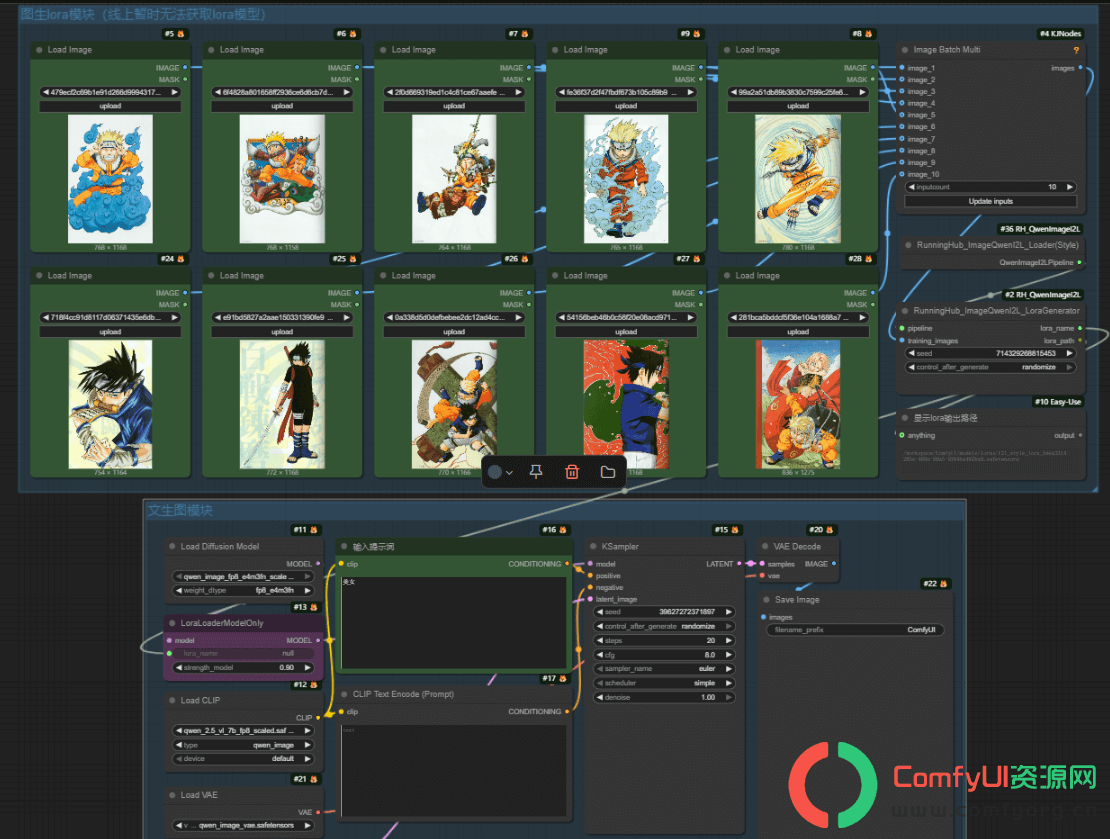
三、工作流
四、效果展示
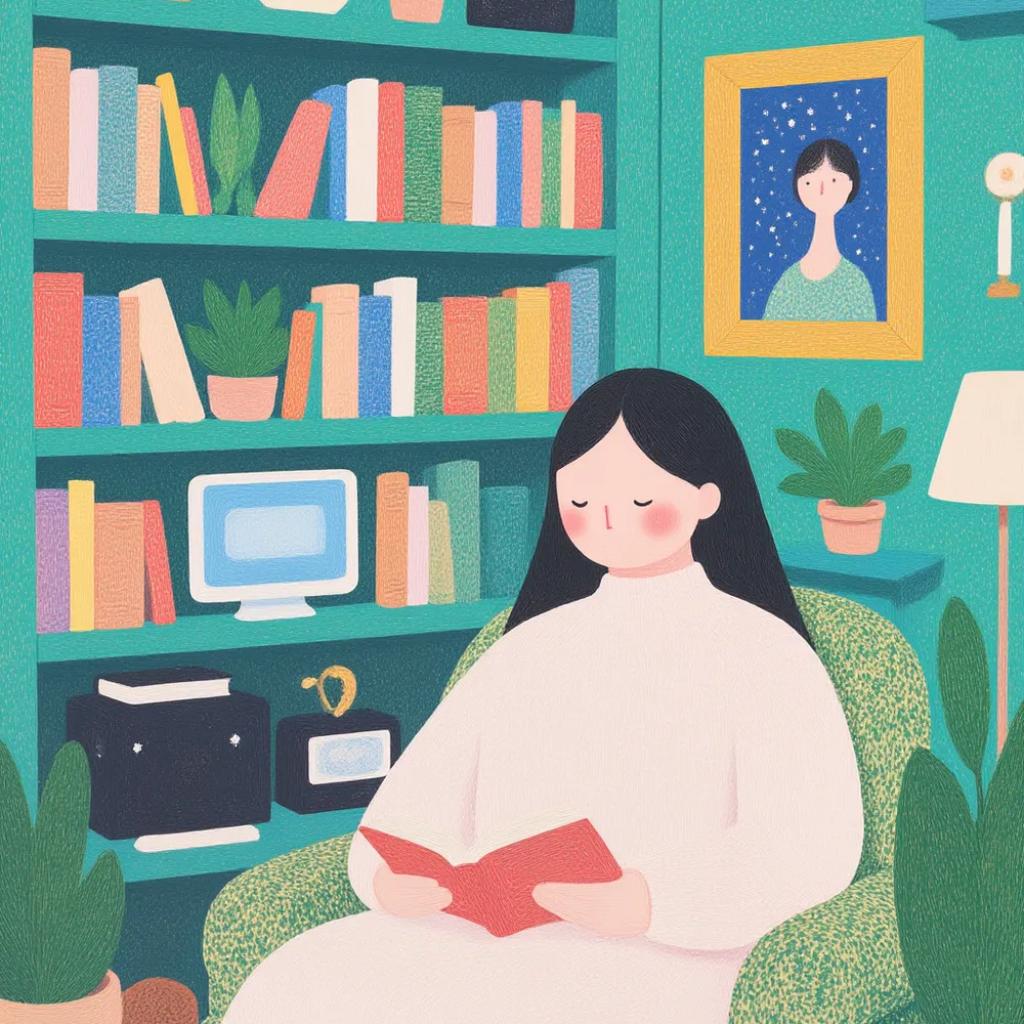
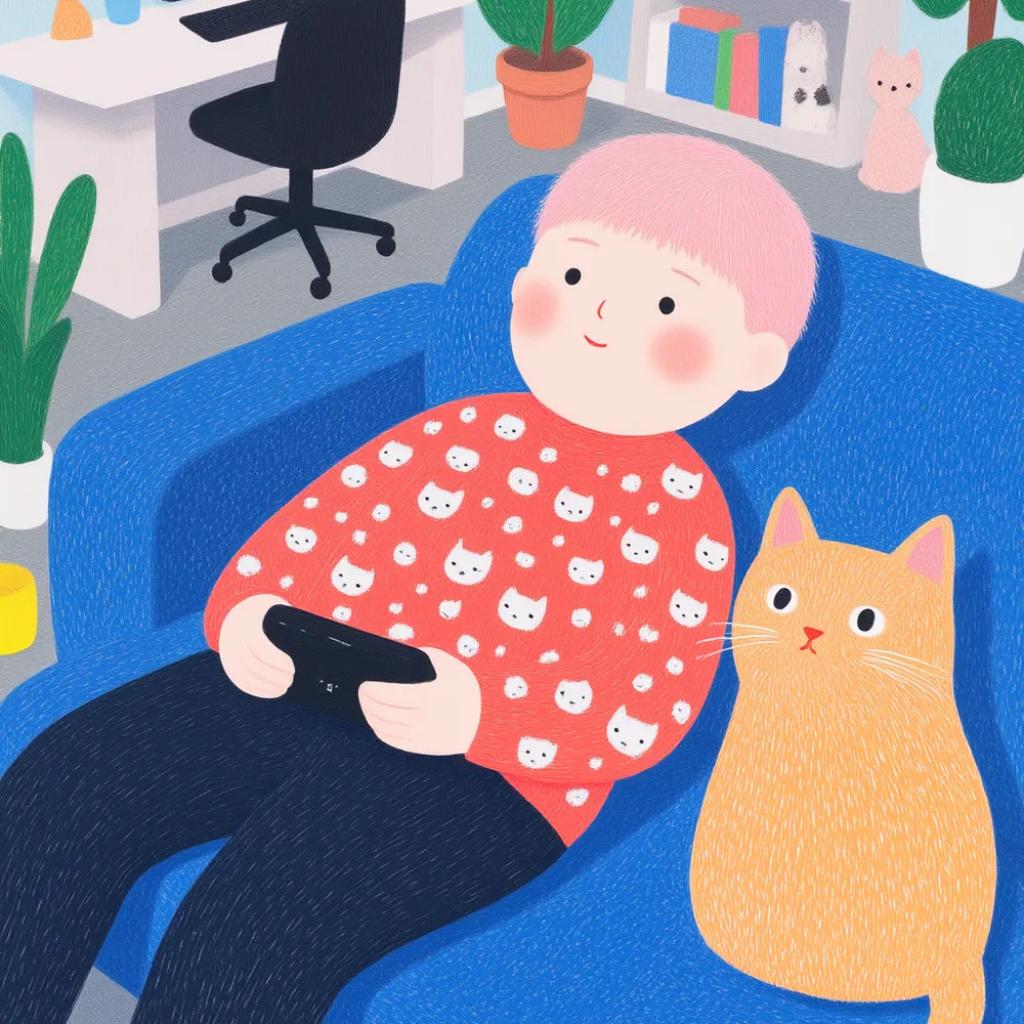
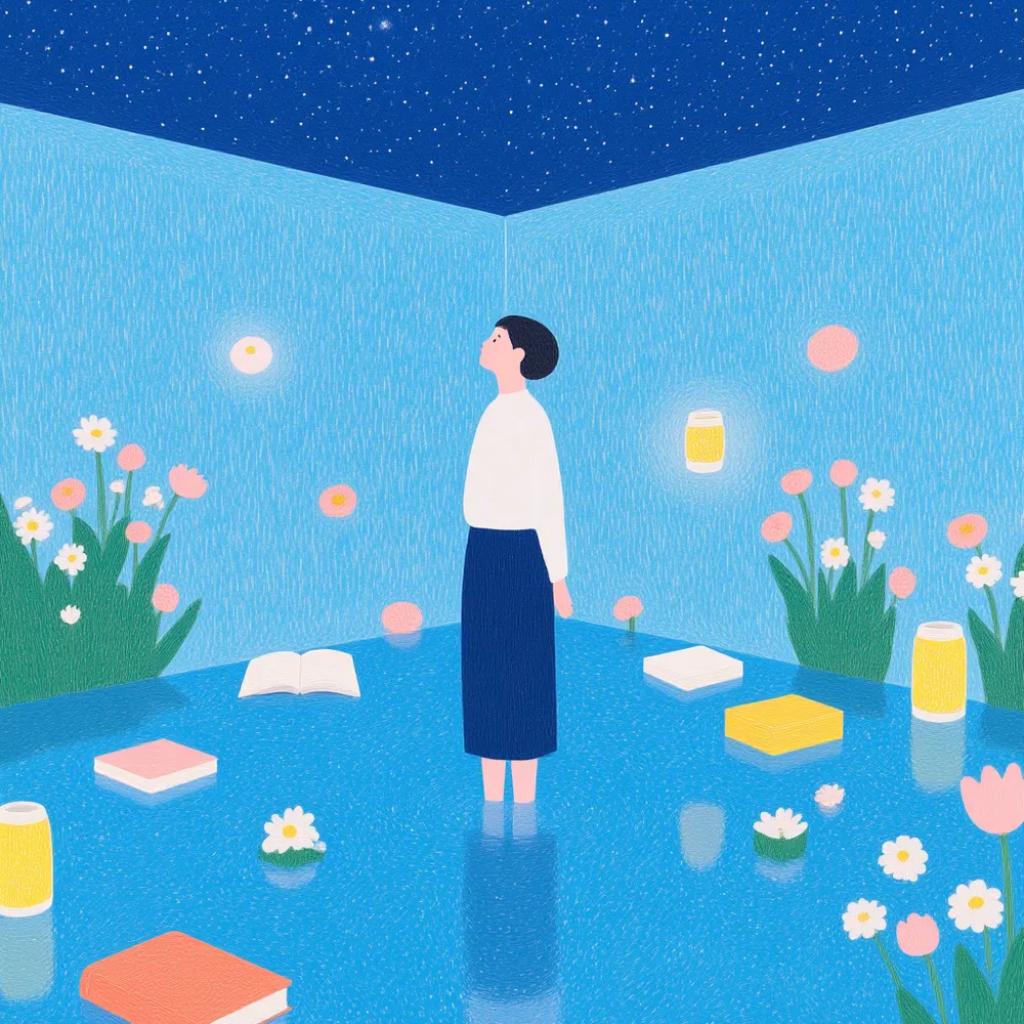
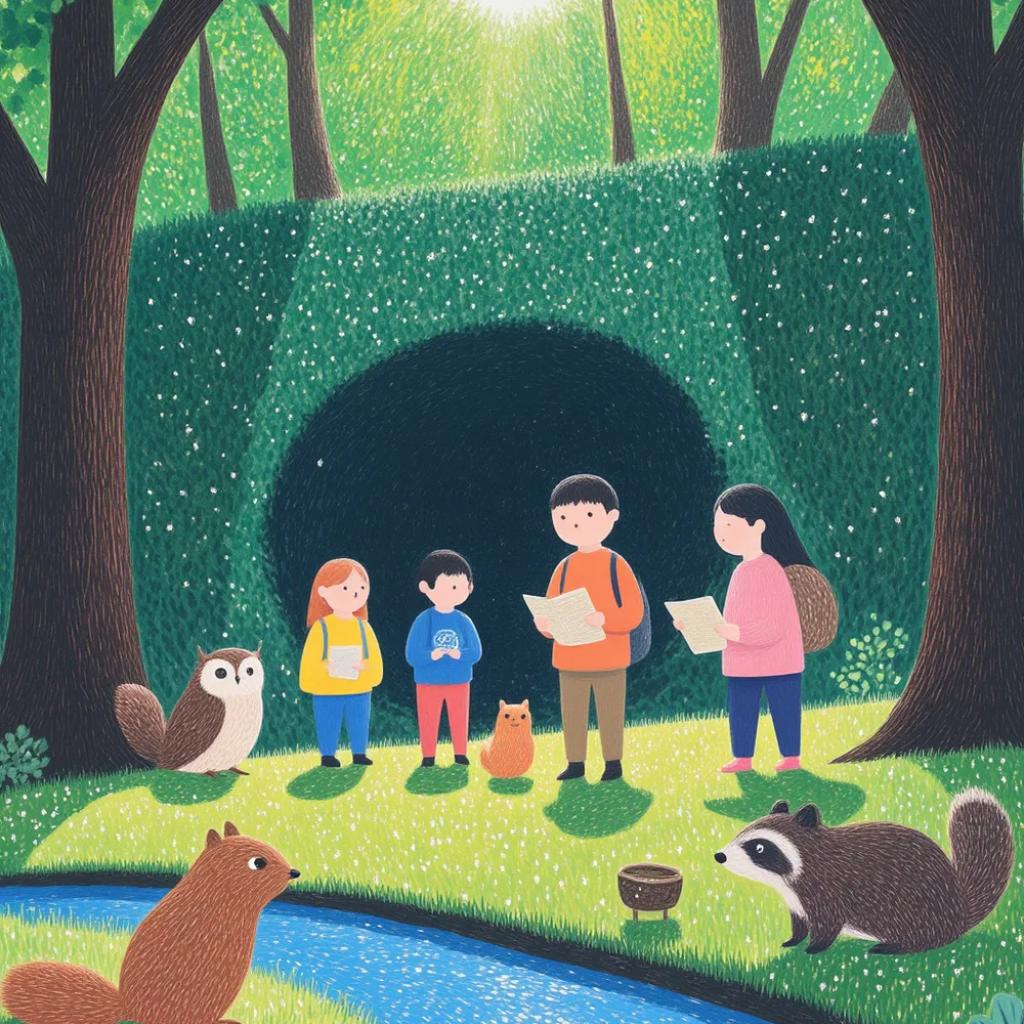
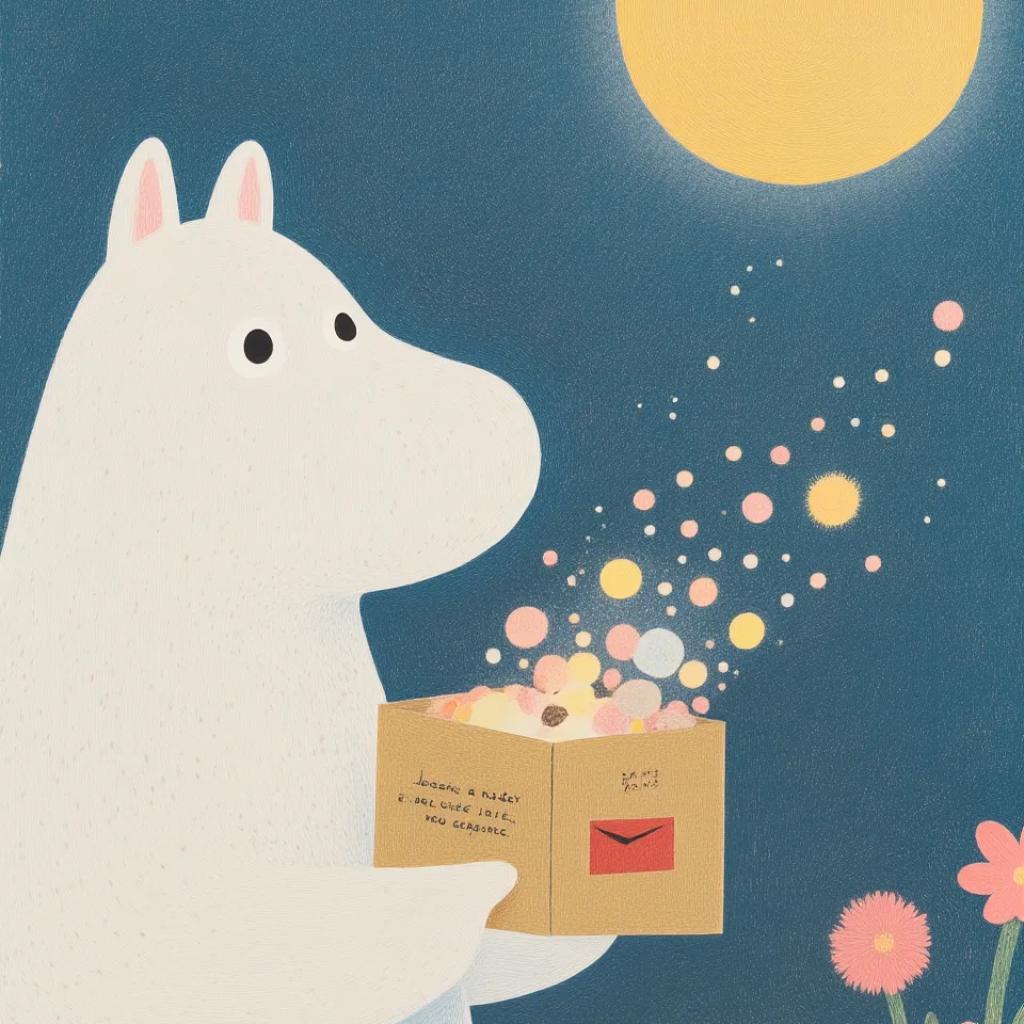
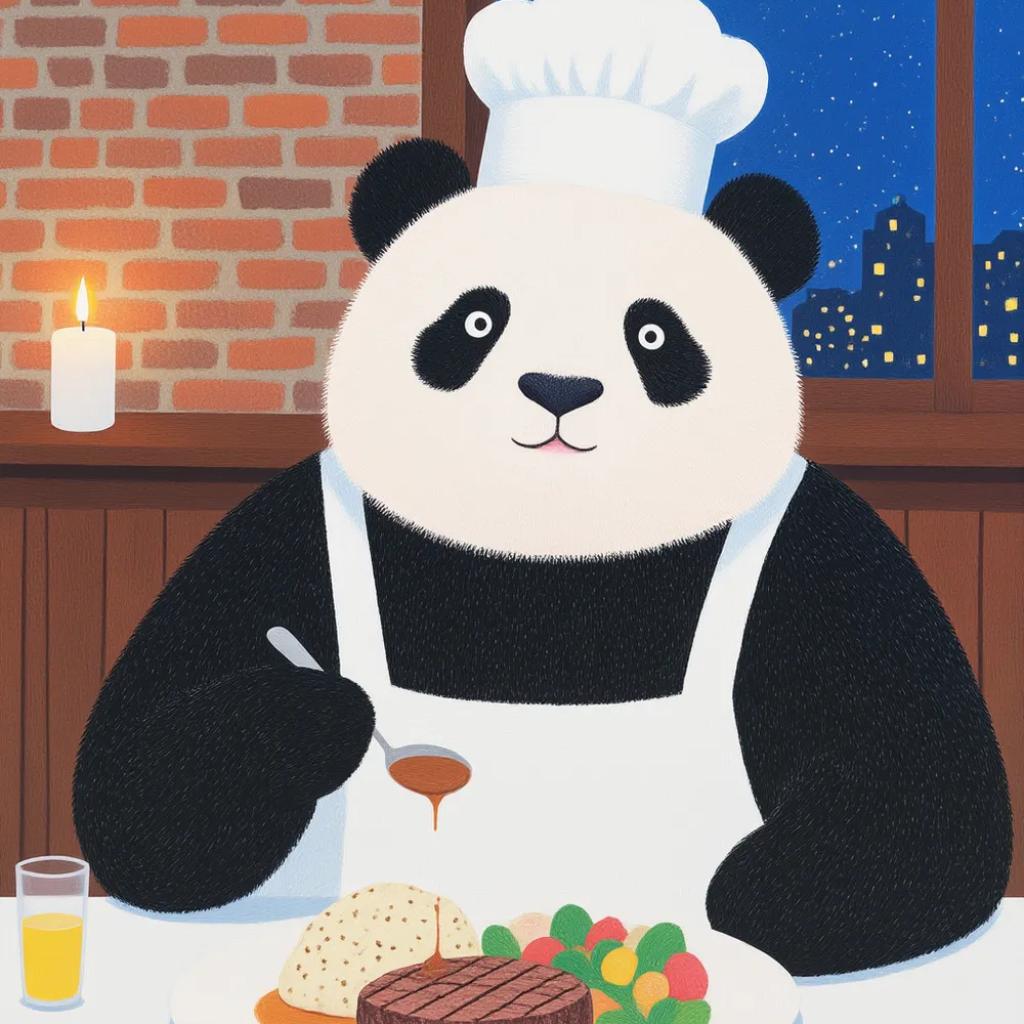
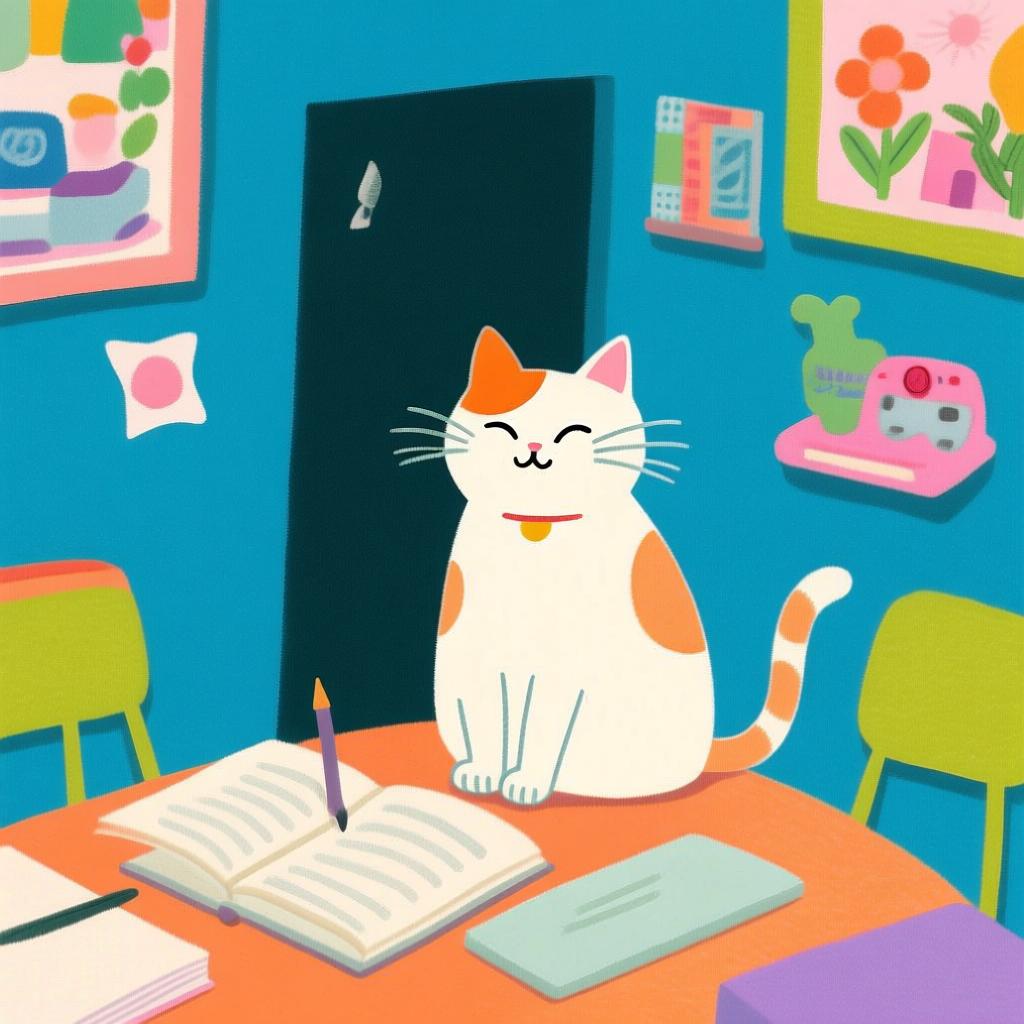
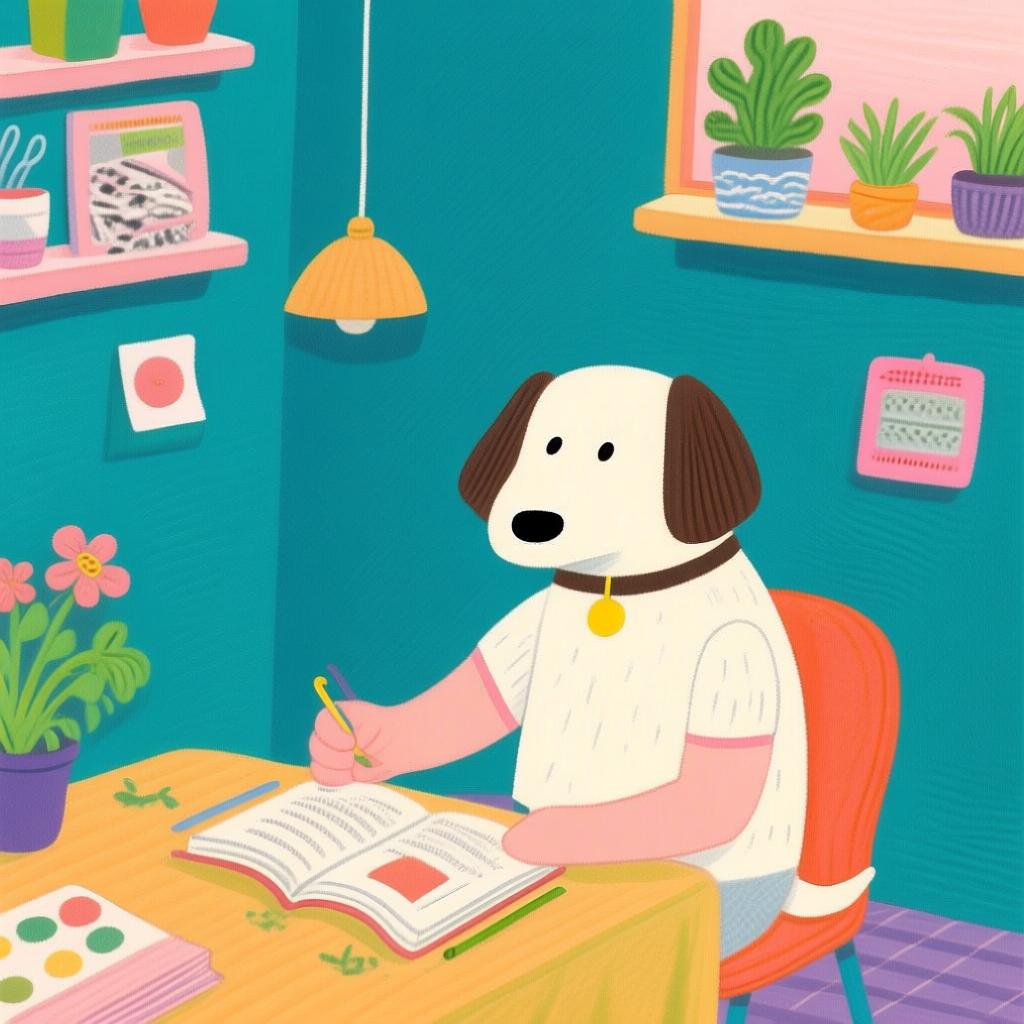
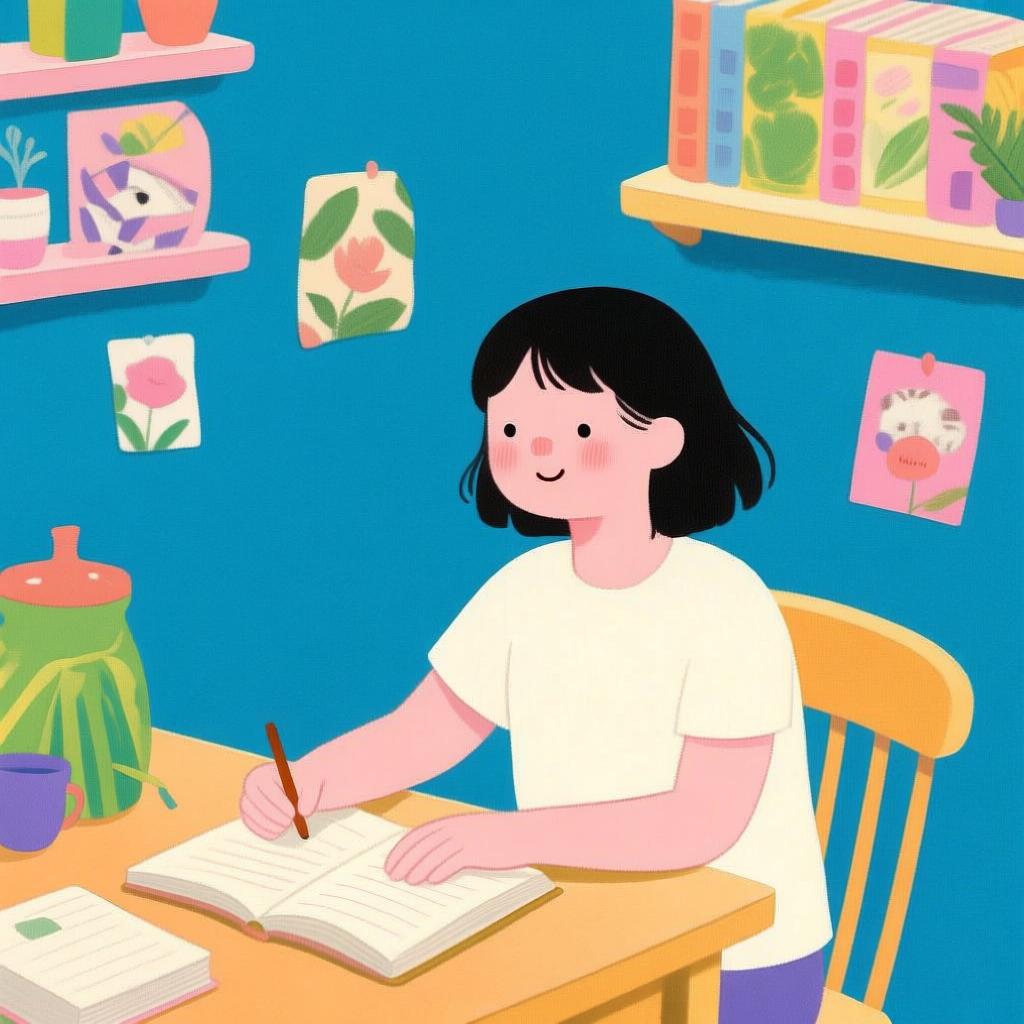
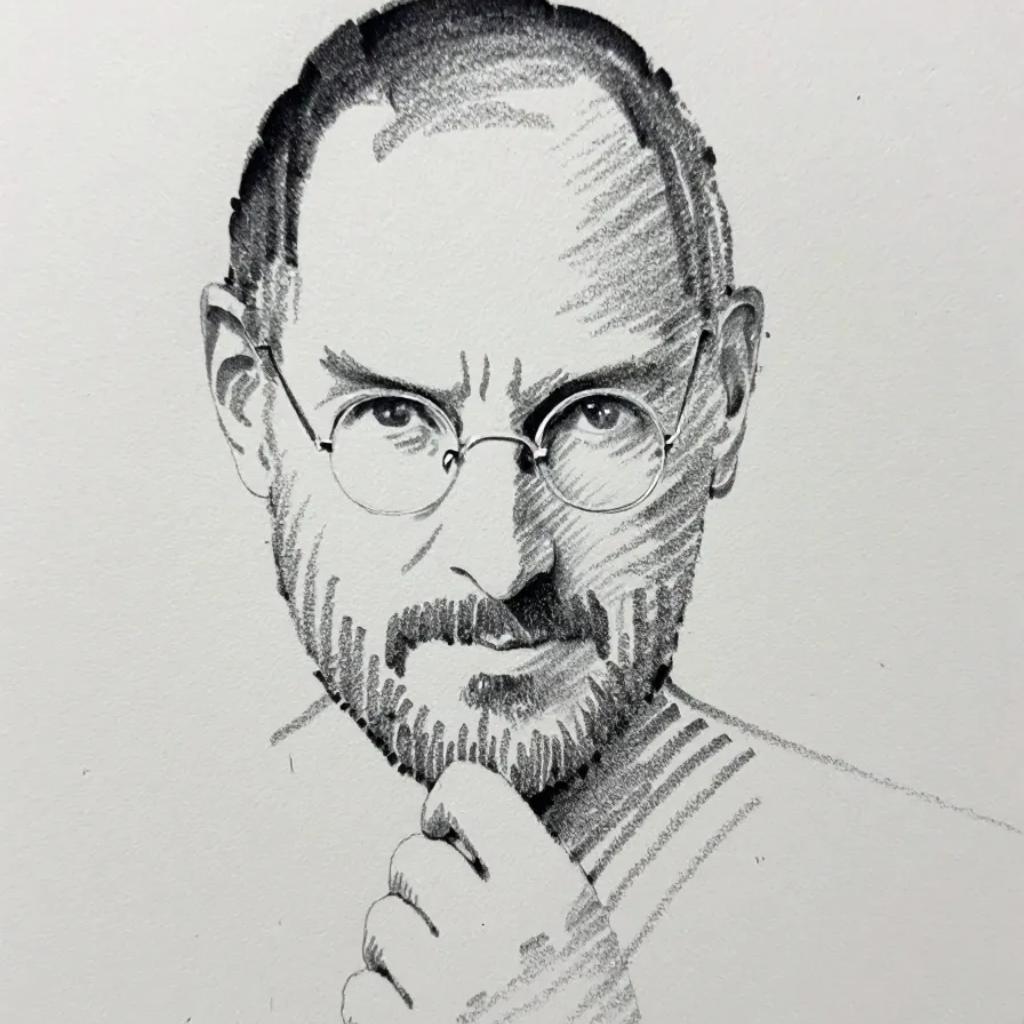
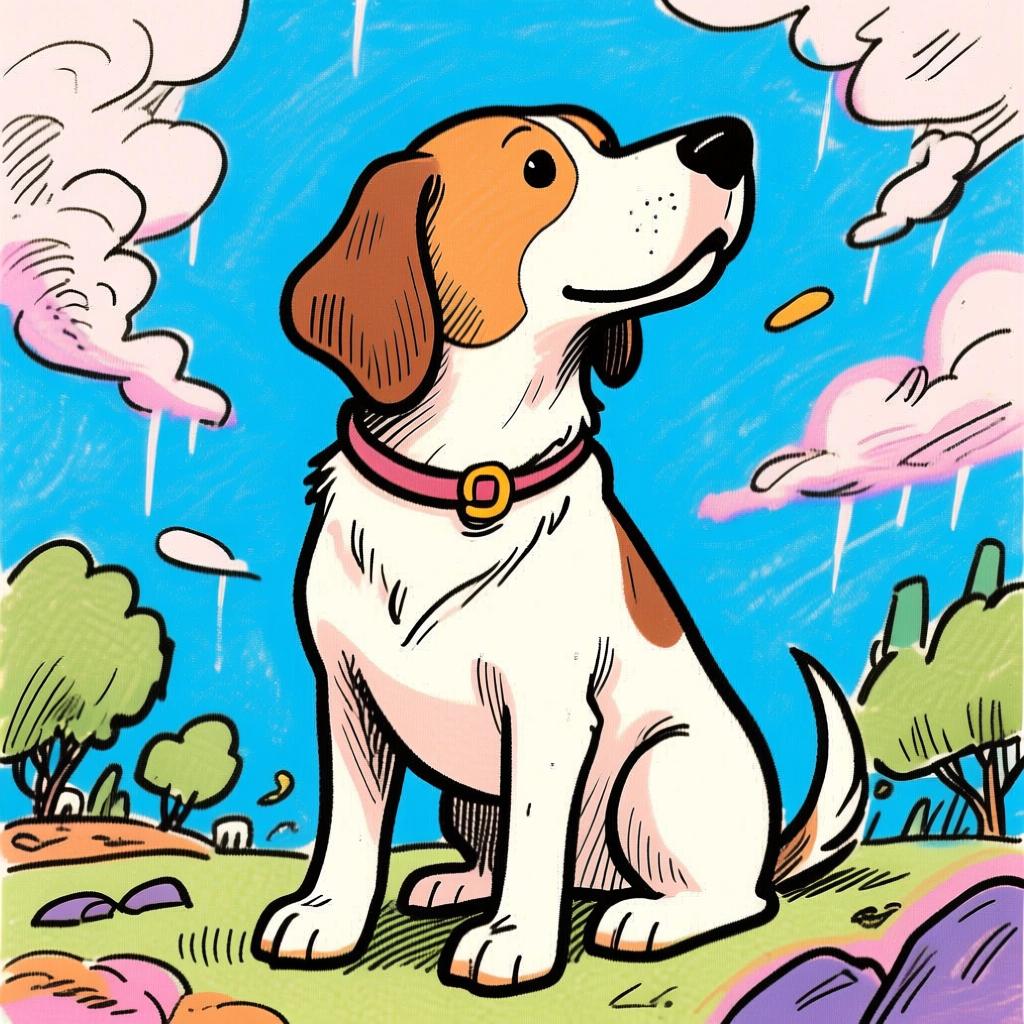
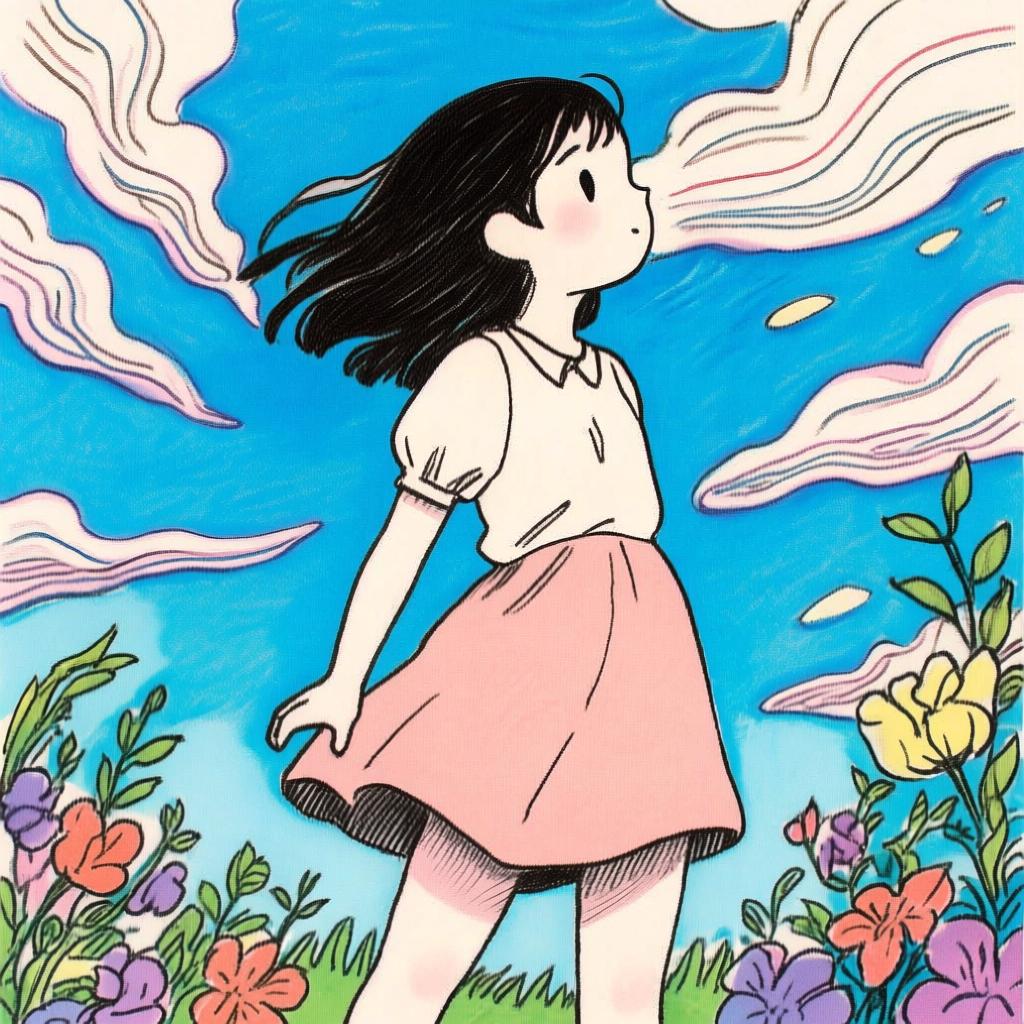
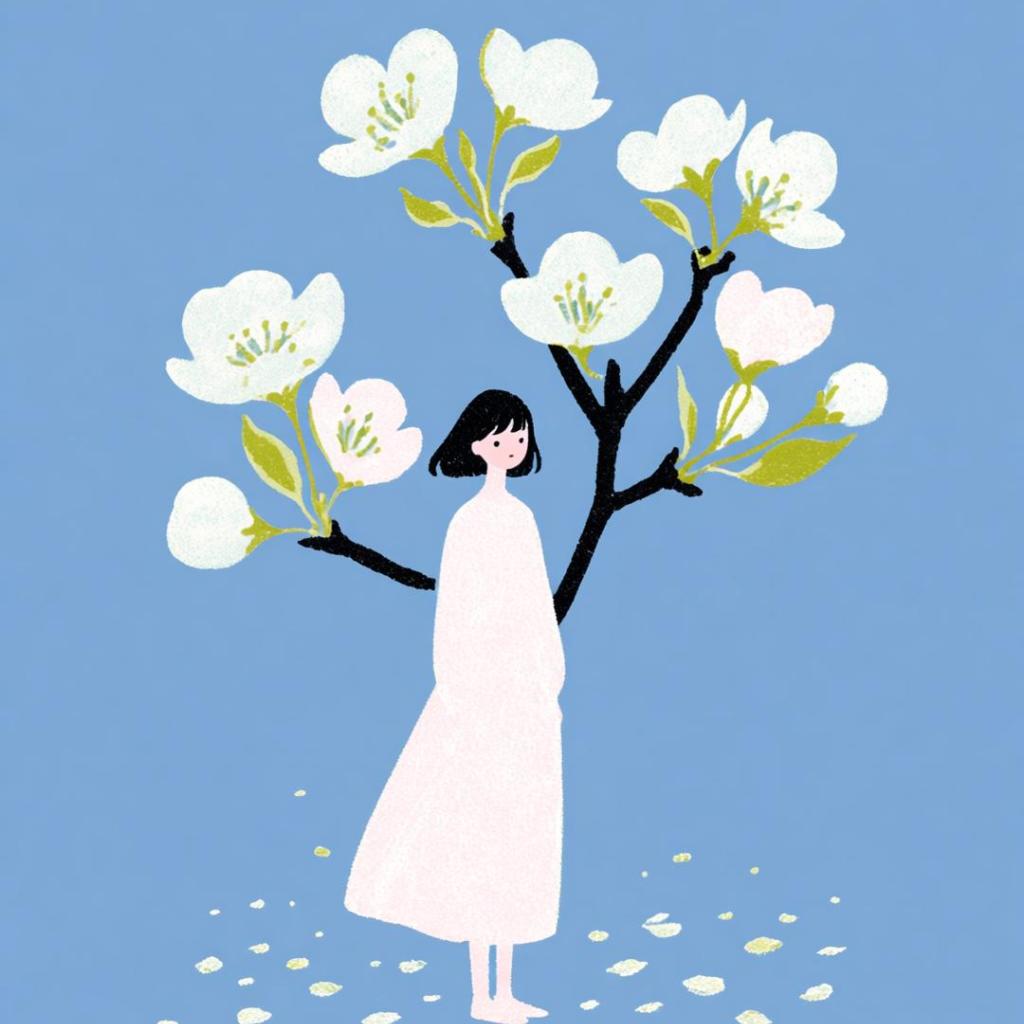
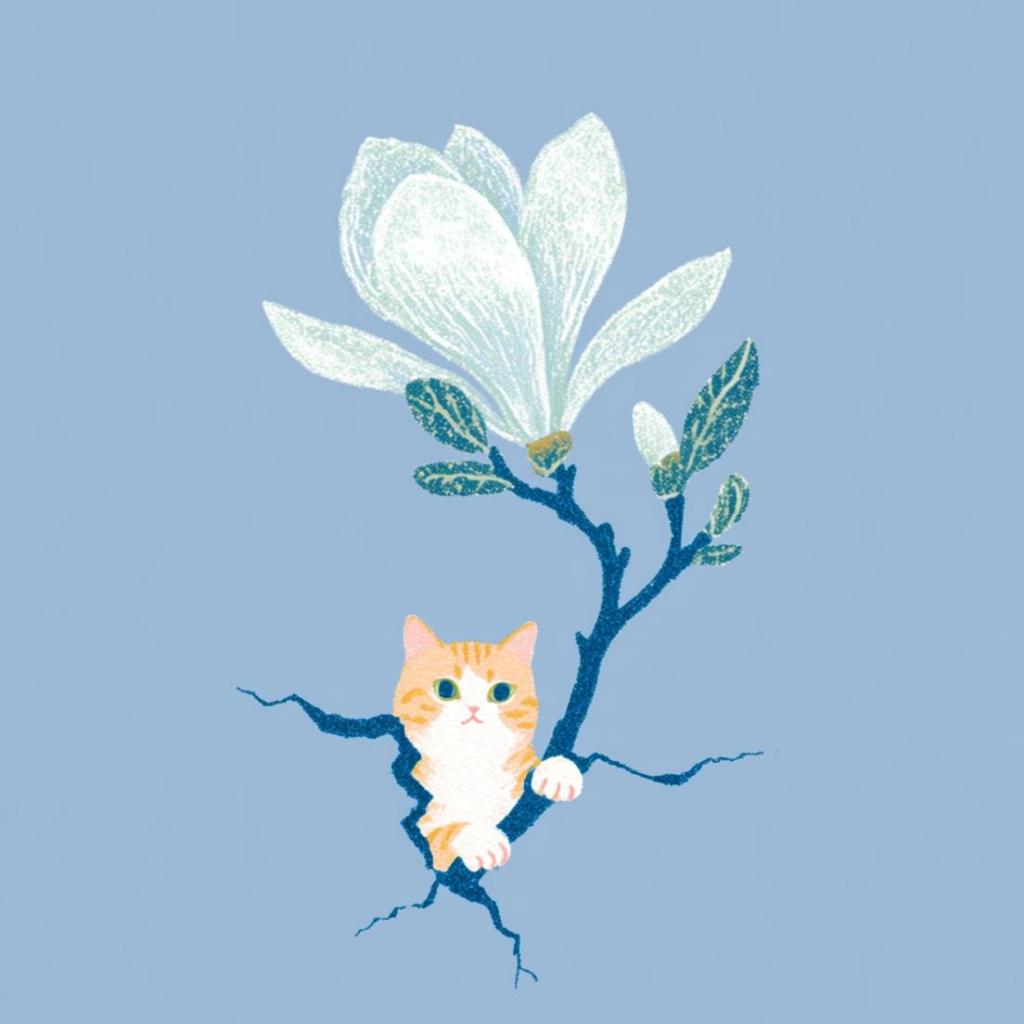
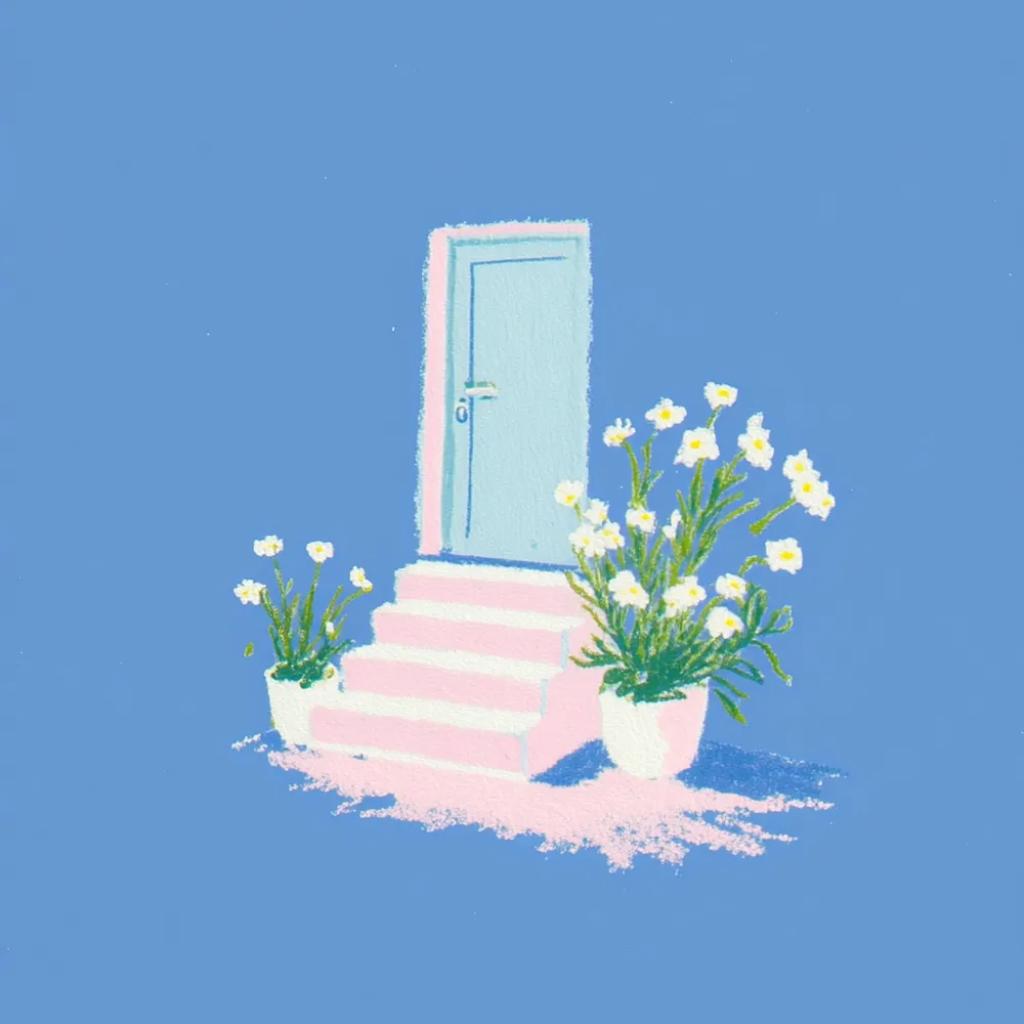
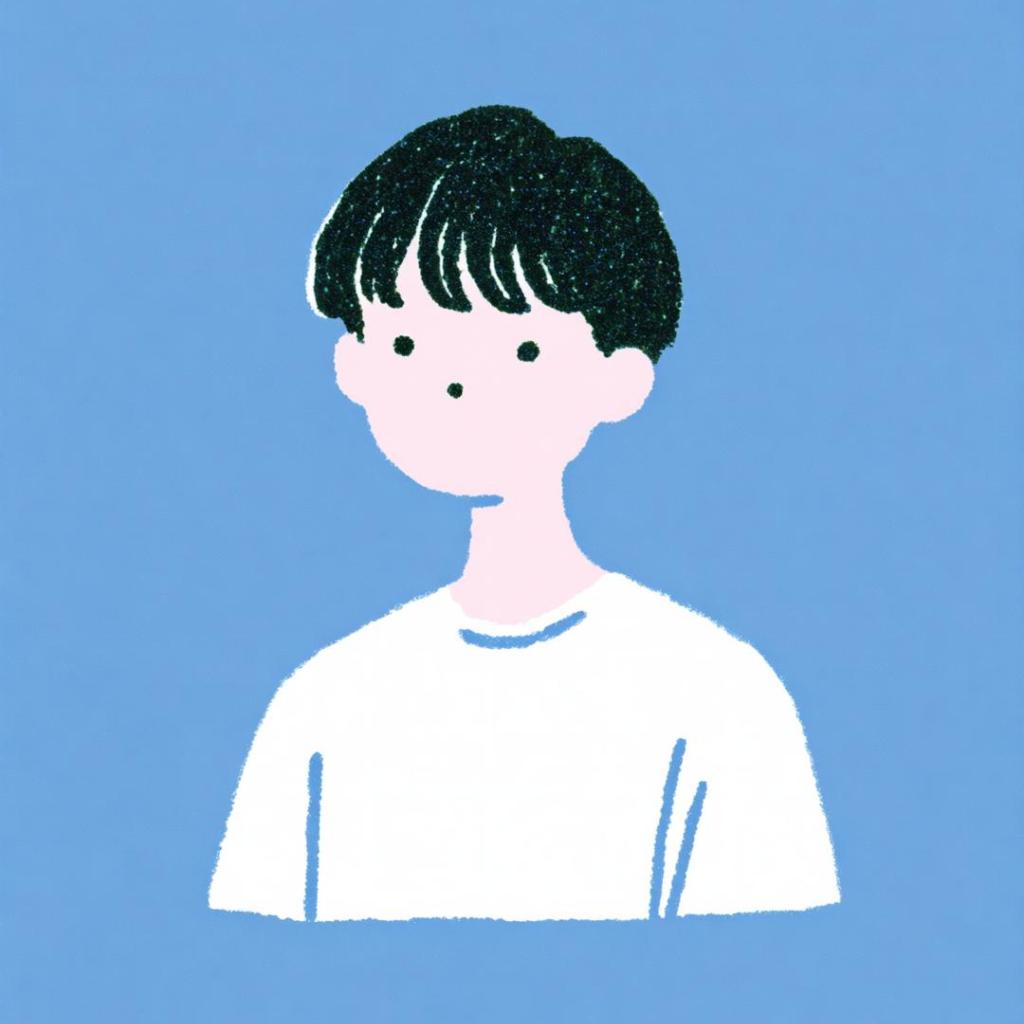
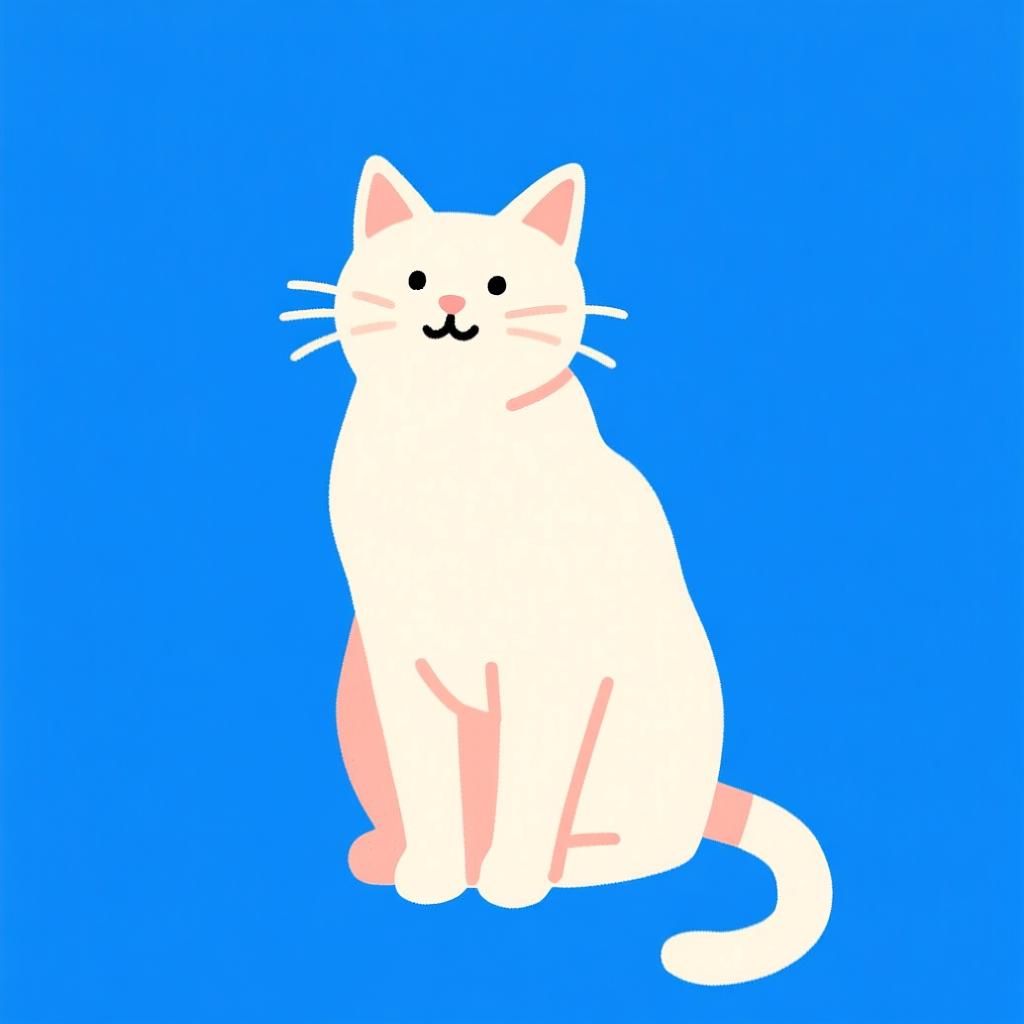
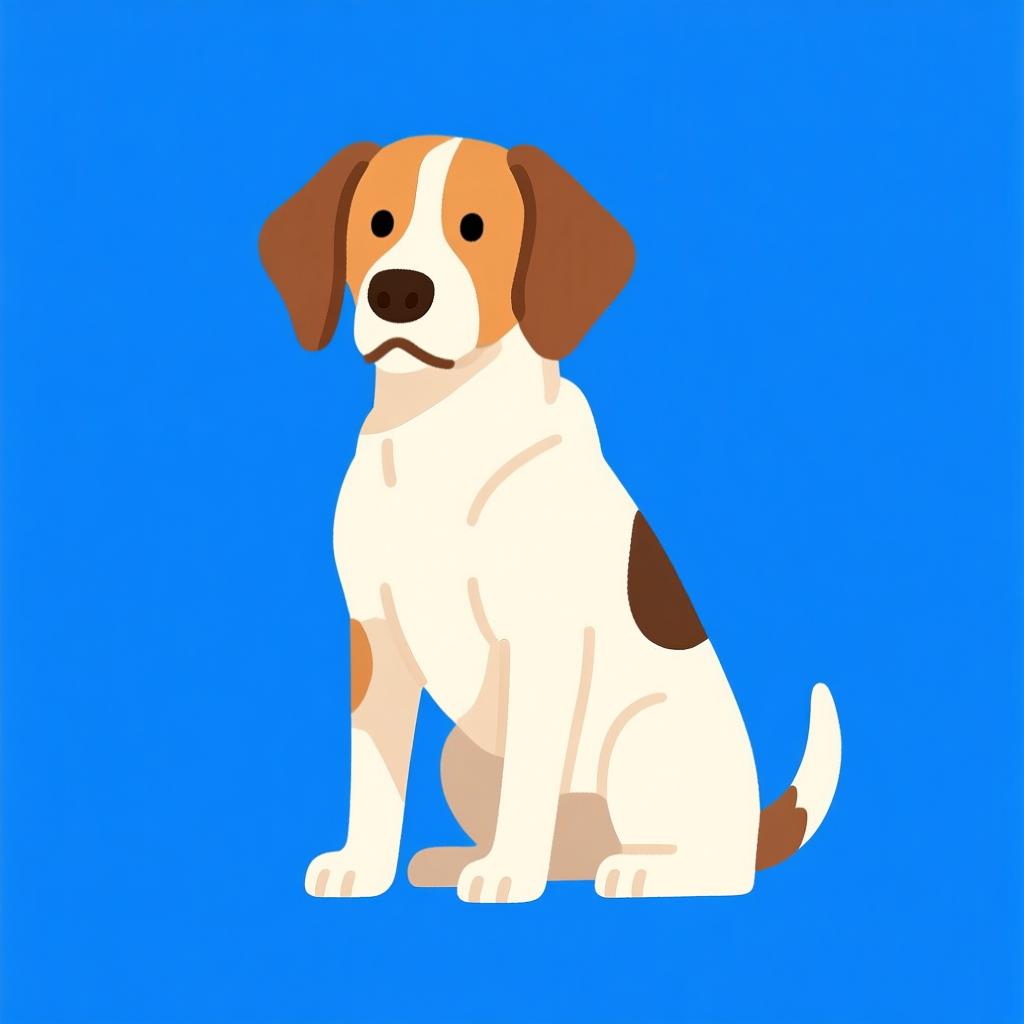
Qwen-Image-i2L-Style 模型可用于快速生成风格 LoRA,只需输入几张风格统一的图像。以下是我们生成的结果,随机种子都是 0。
风格1:抽象矢量
输入图像:
 |
 |
 |
 |
 |
 |
|---|
生成图像:
| a cat | a dog | a girl |
|---|---|---|
 |
 |
 |
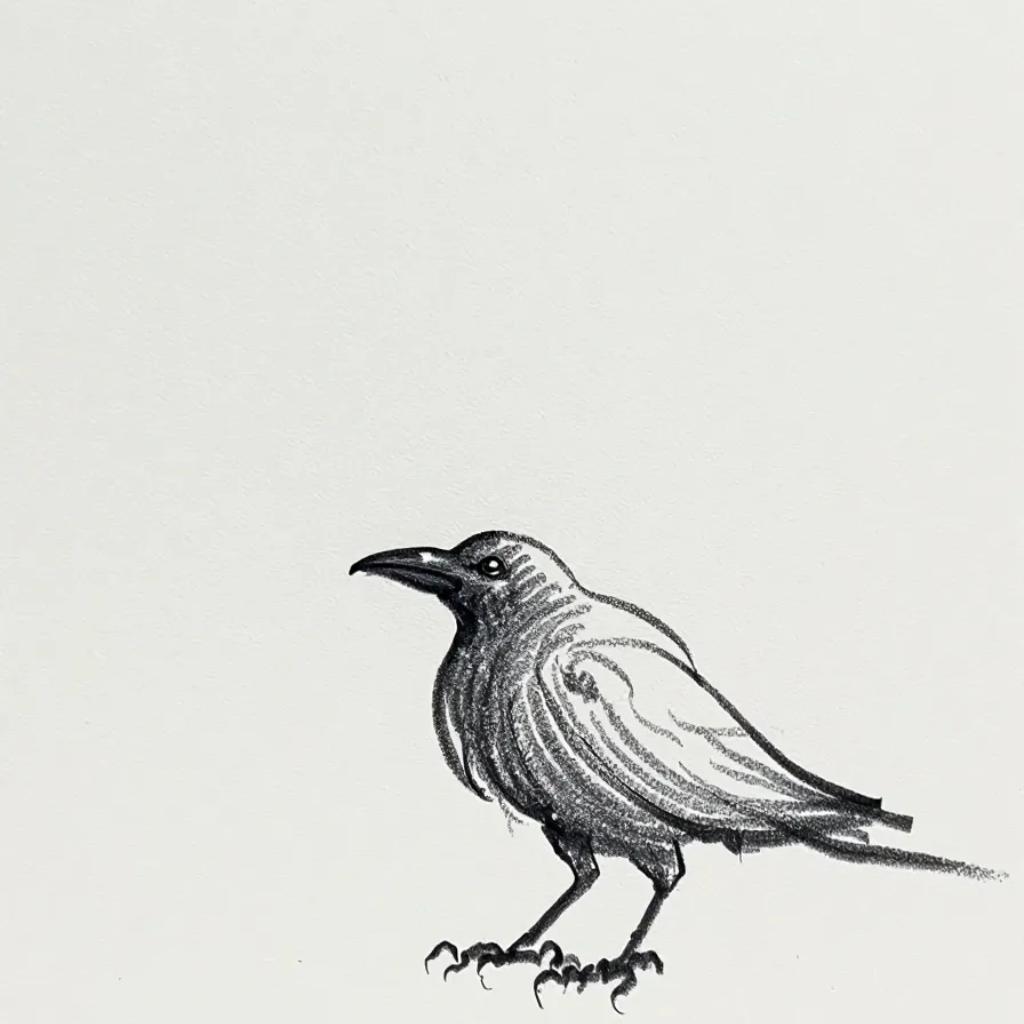
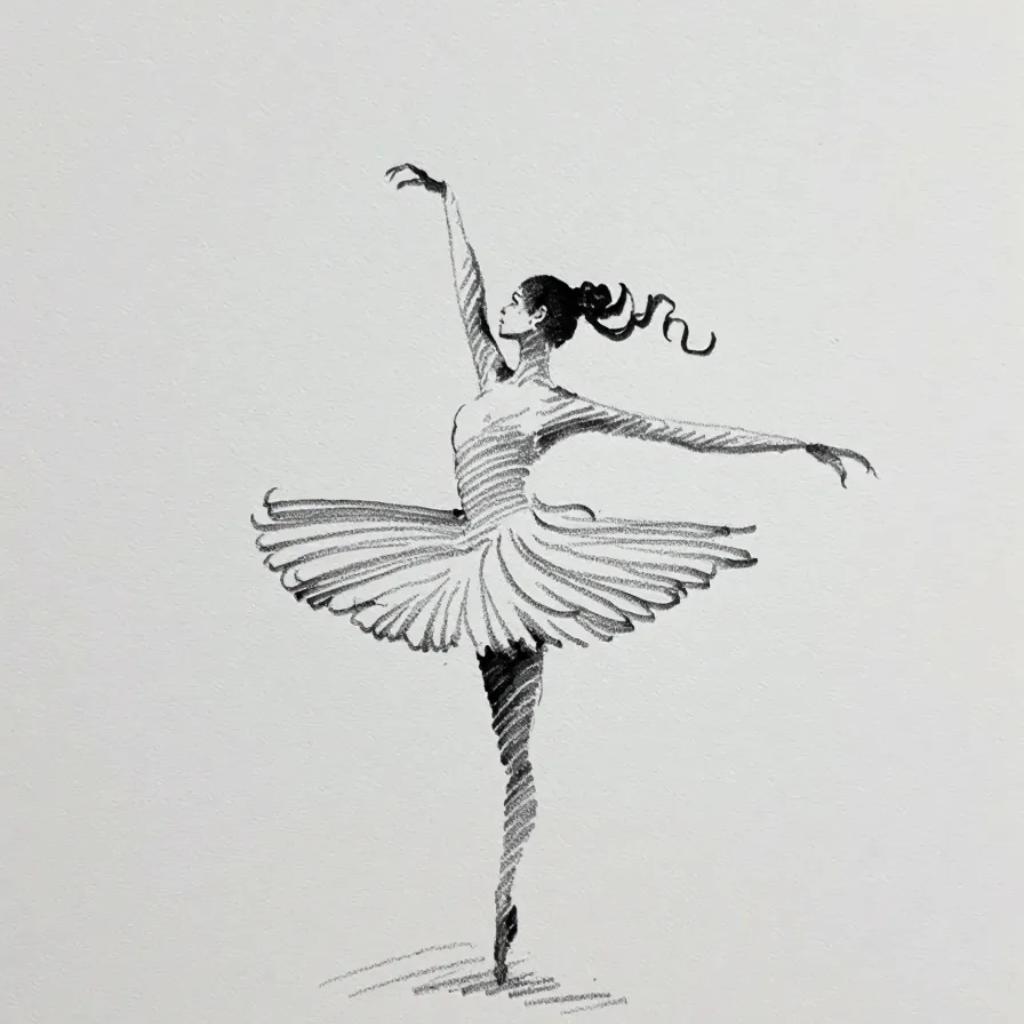
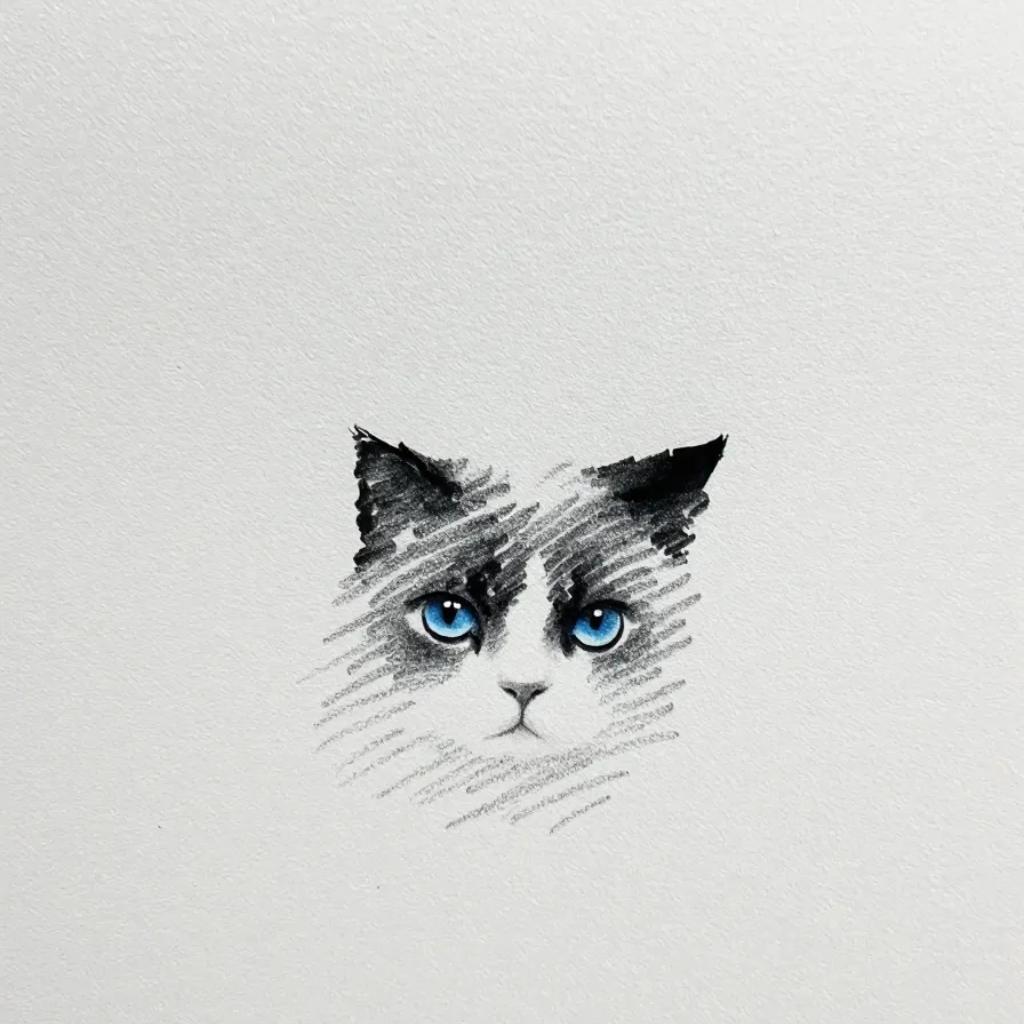
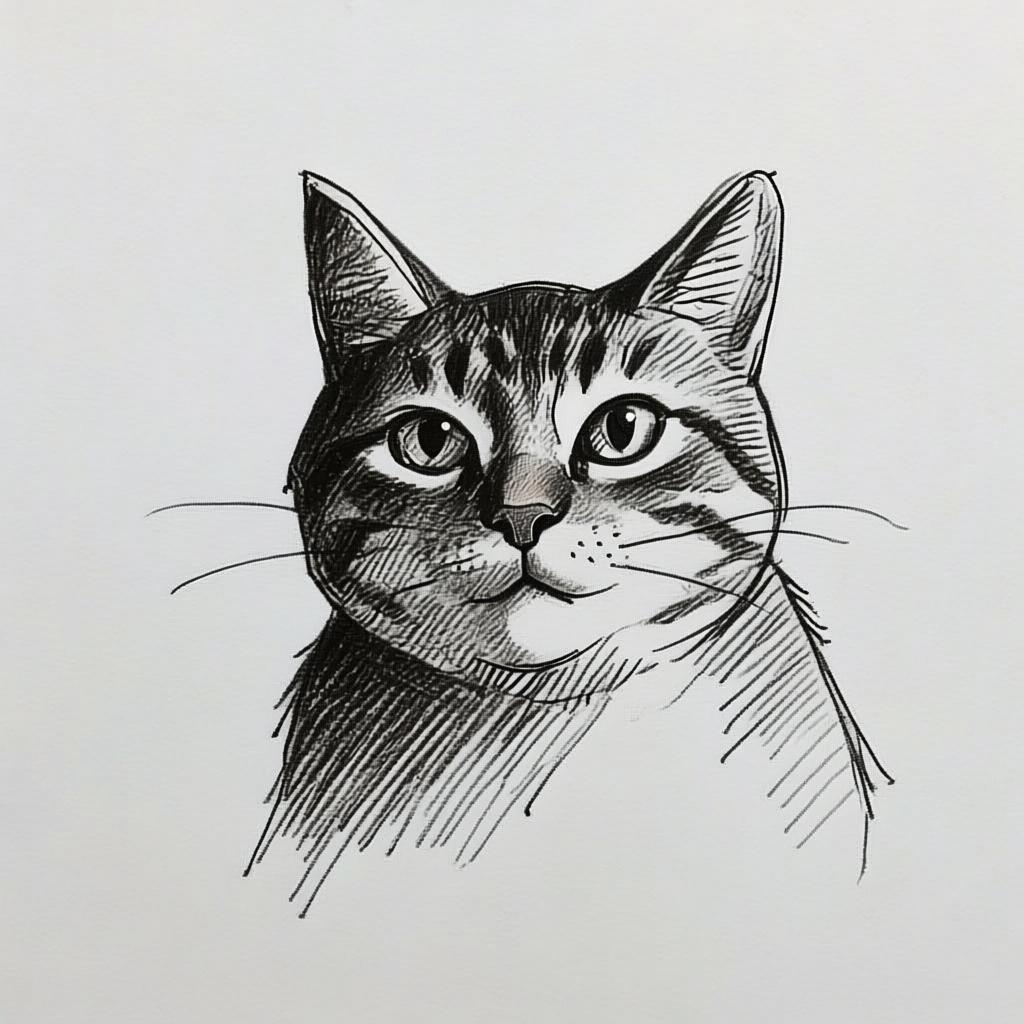
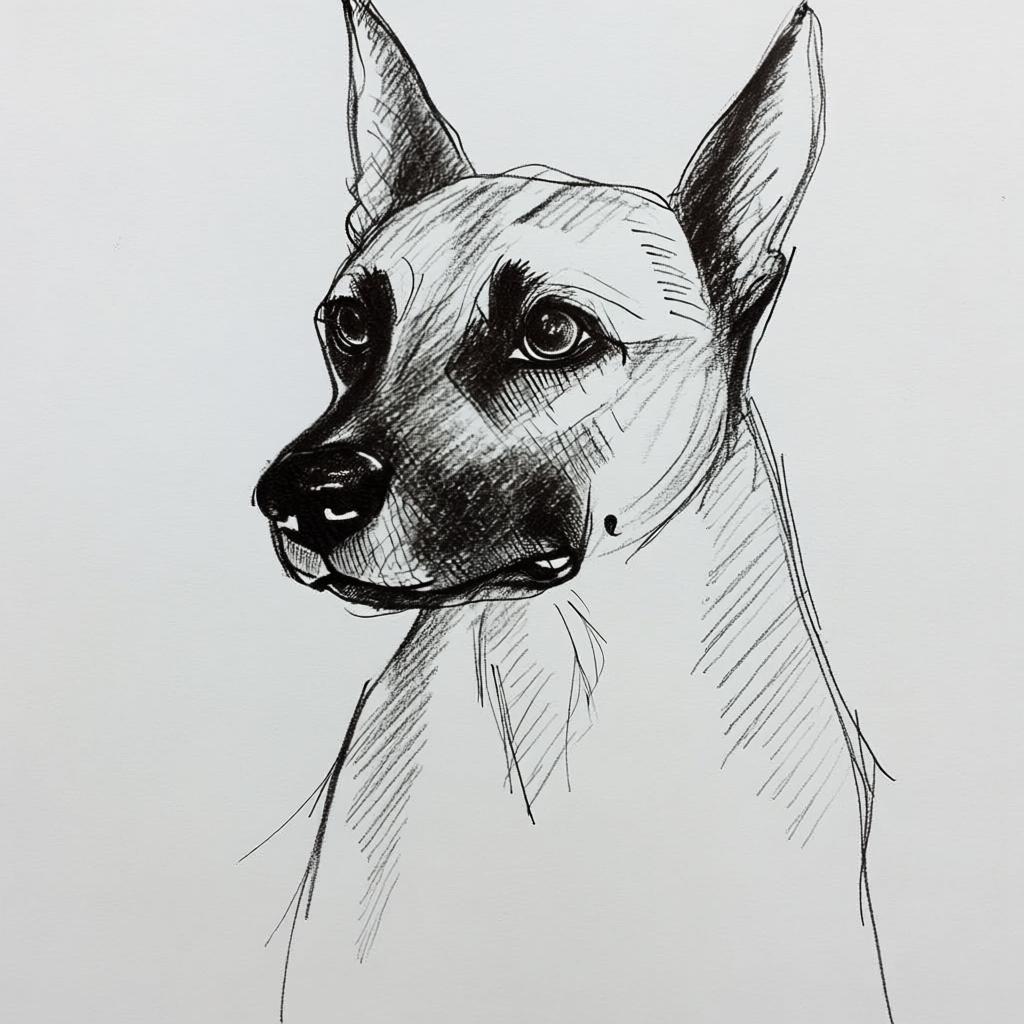
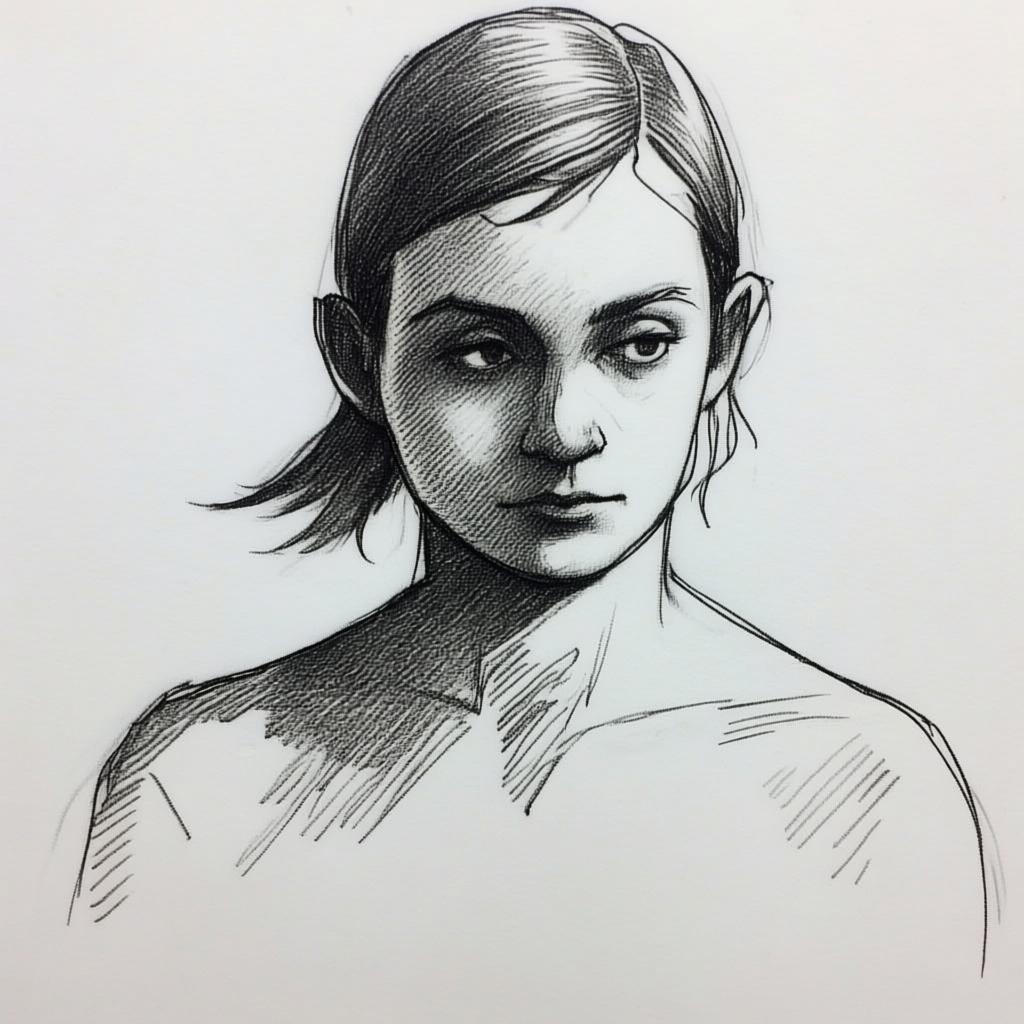
风格2:黑白素描
输入图像:
 |
 |
 |
 |
|---|
生成图像:
| a cat | a dog | a girl |
|---|---|---|
 |
 |
 |
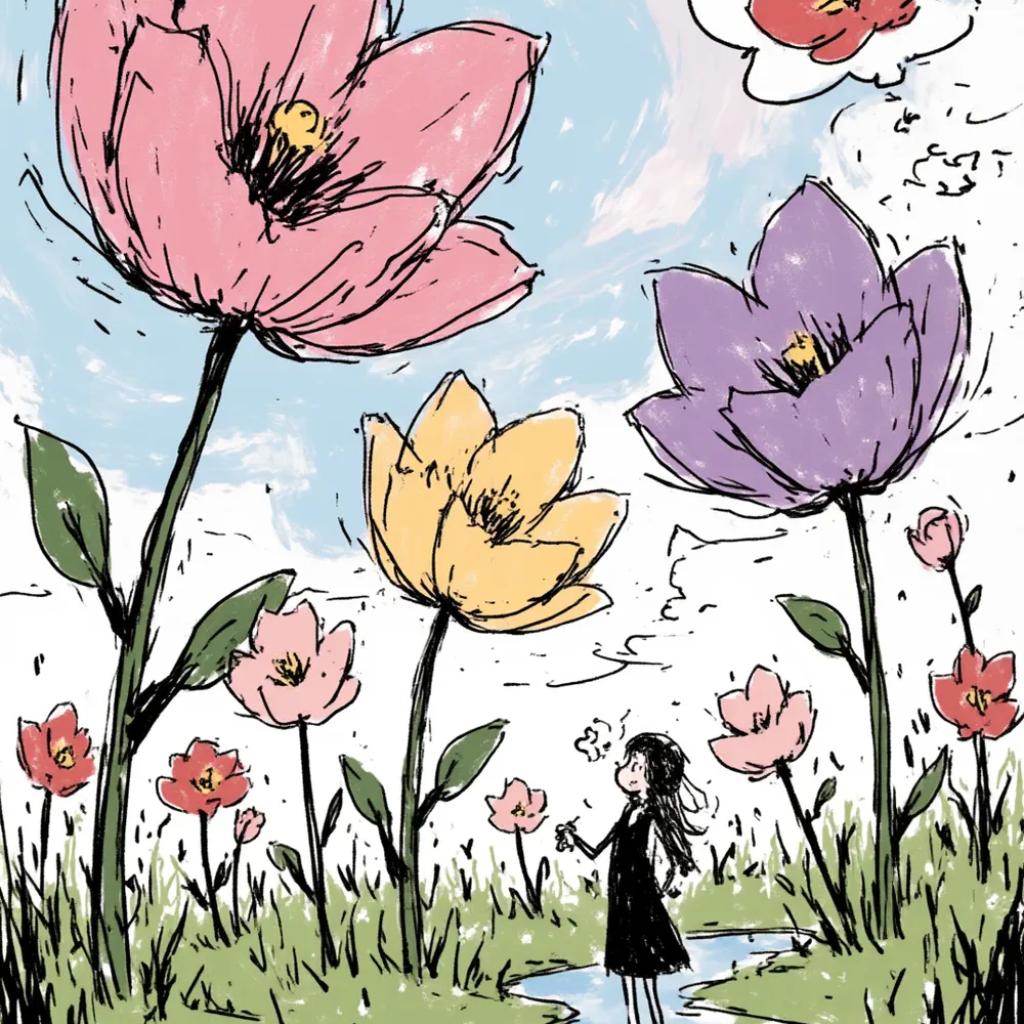
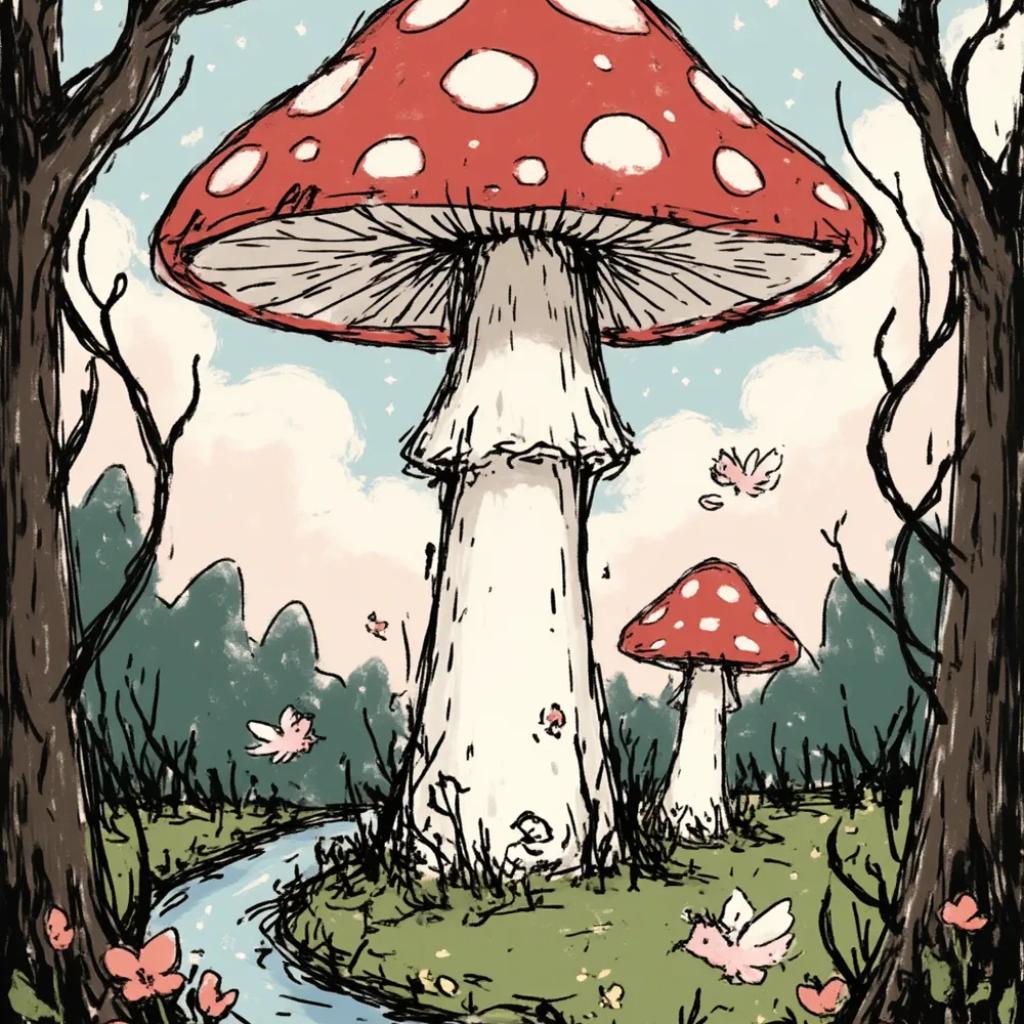
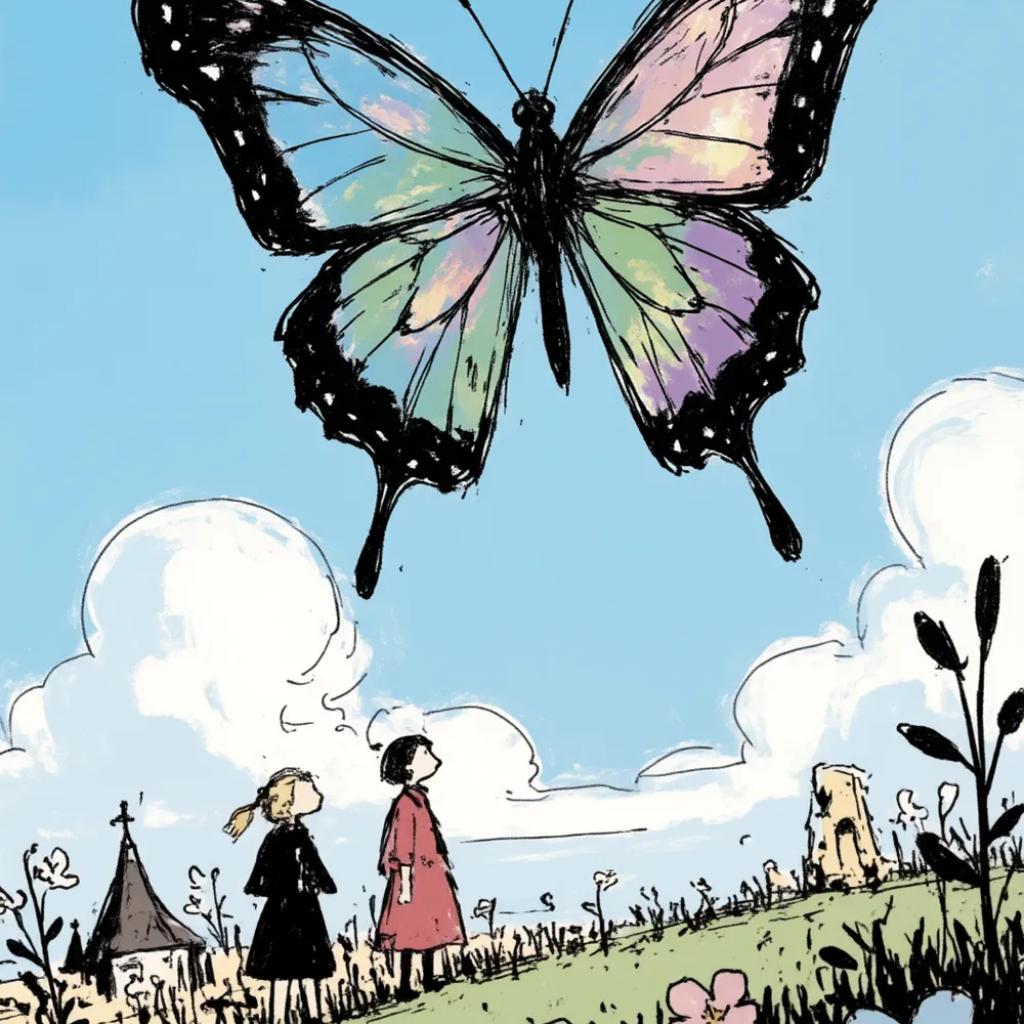
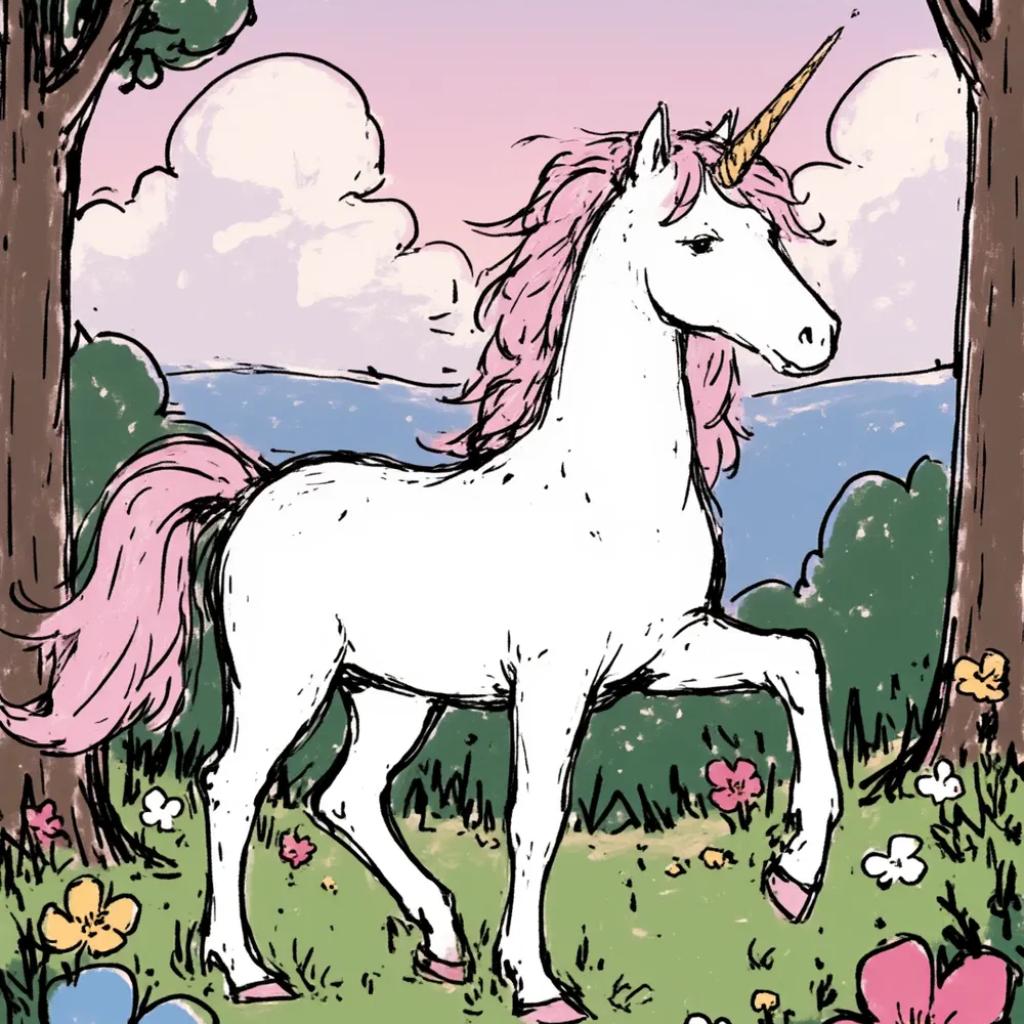
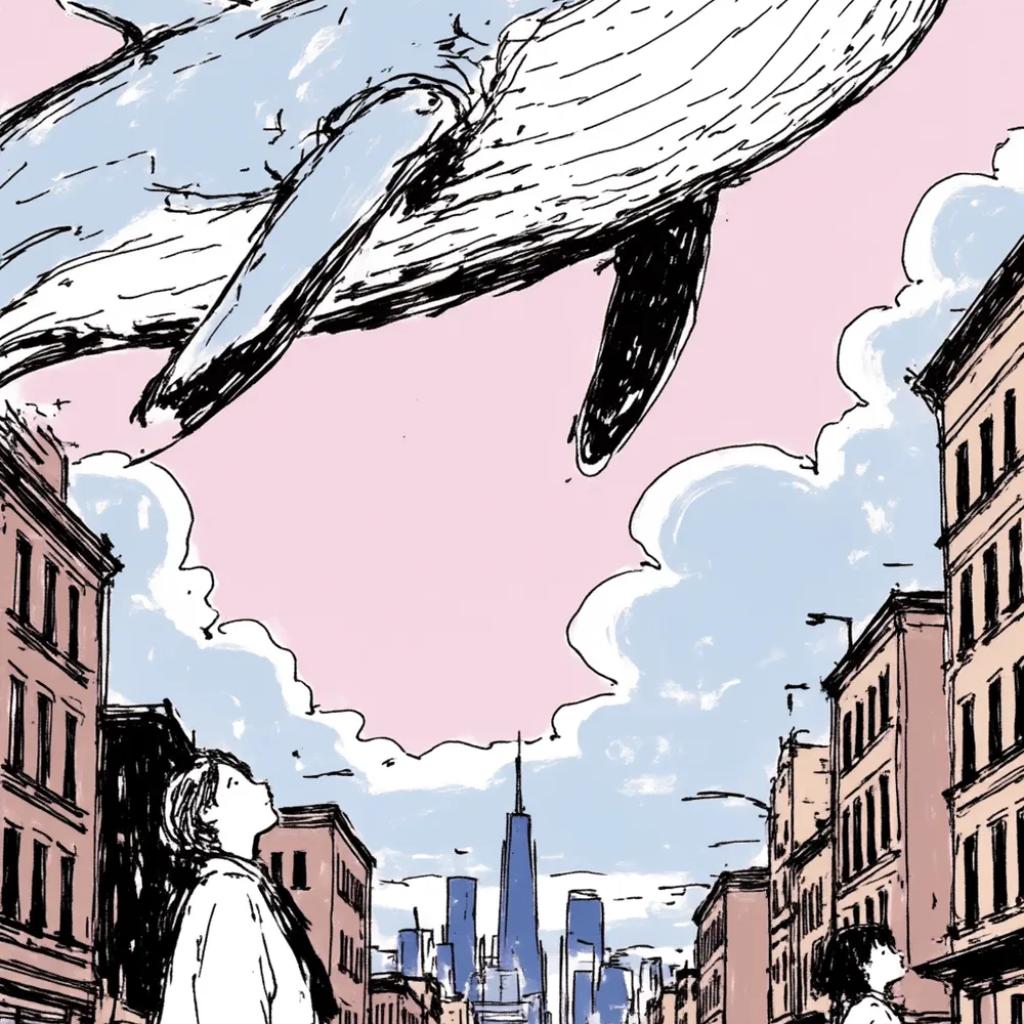
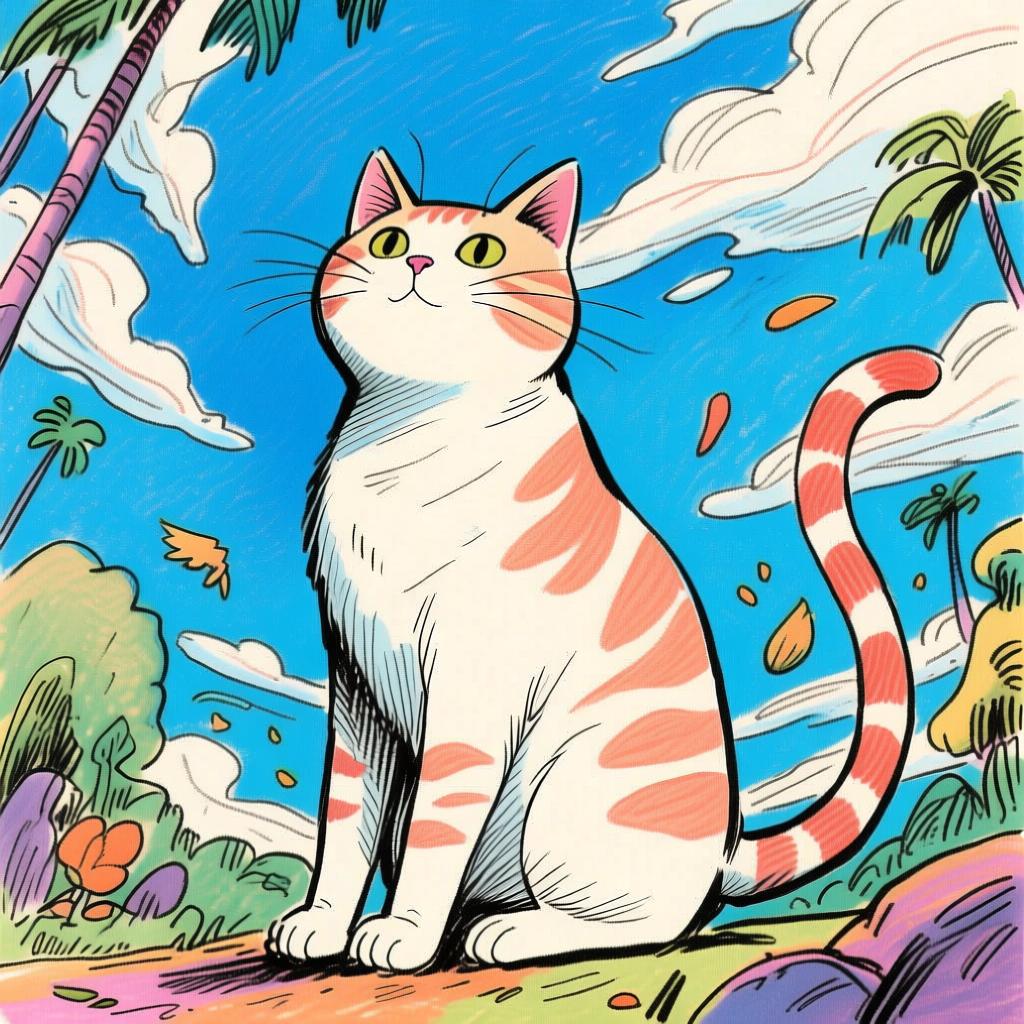
风格3:潦草手绘
输入图像:
 |
 |
 |
 |
 |
|---|
生成图像:
| a cat | a dog | a girl |
|---|---|---|
 |
 |
 |
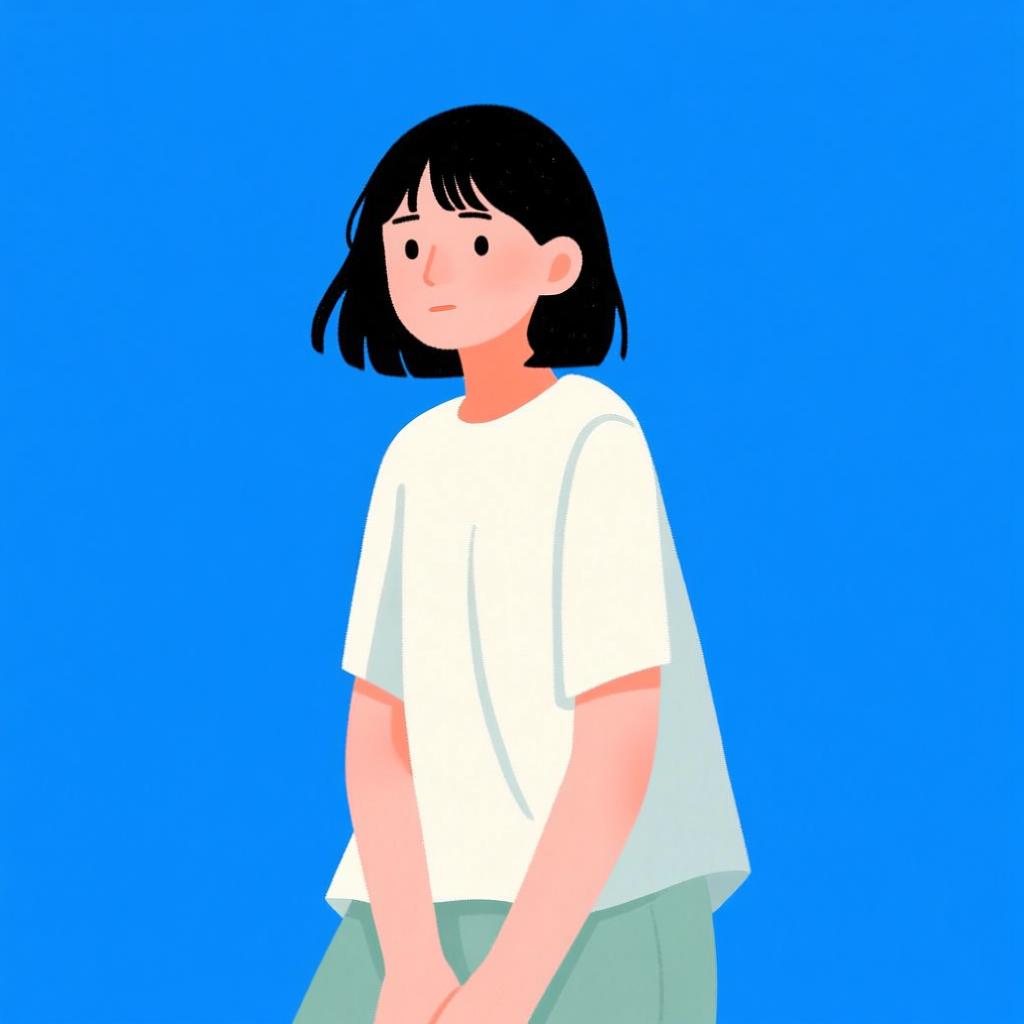
风格4:蓝底扁平
输入图像:
 |
 |
 |
 |
|---|
生成图像:
| a cat | a dog | a girl |
|---|---|---|
 |
 |
 |
Coarse + Fine + Bias
Qwen-Image-i2L-Coarse、Qwen-Image-i2L-Fine、Qwen-Image-i2L-Bias 三者组合后可以生成保留图像内容和细节信息的 LoRA 权重,这组权重作为 LoRA 训练的初始化权重能够加速收敛速度。
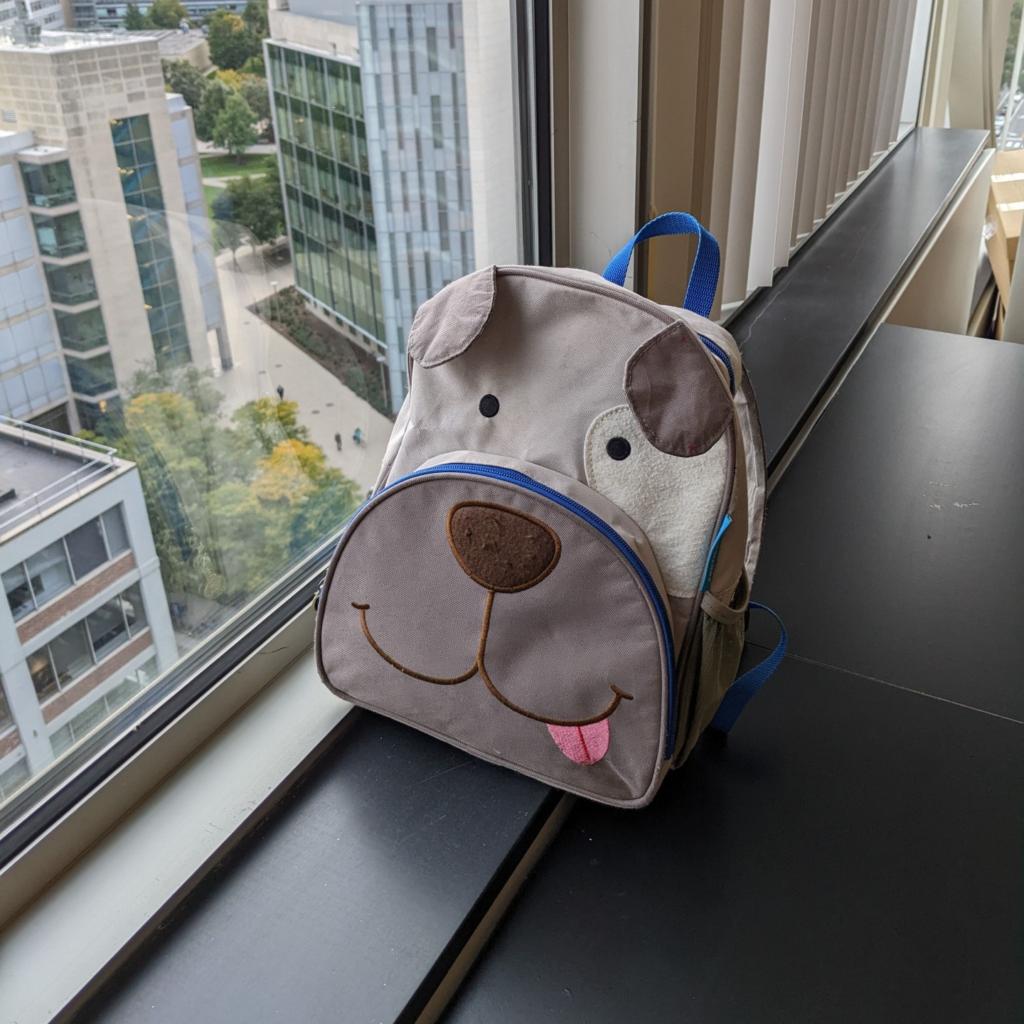
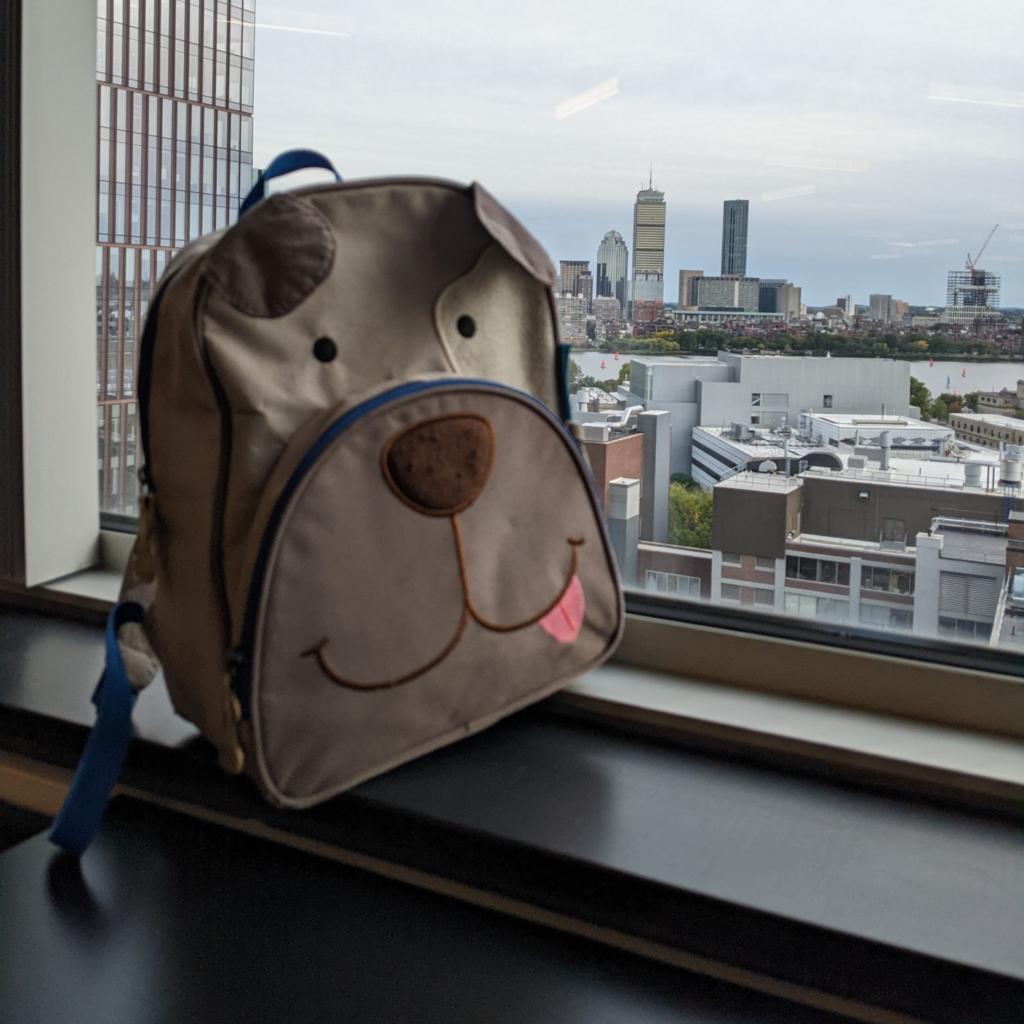
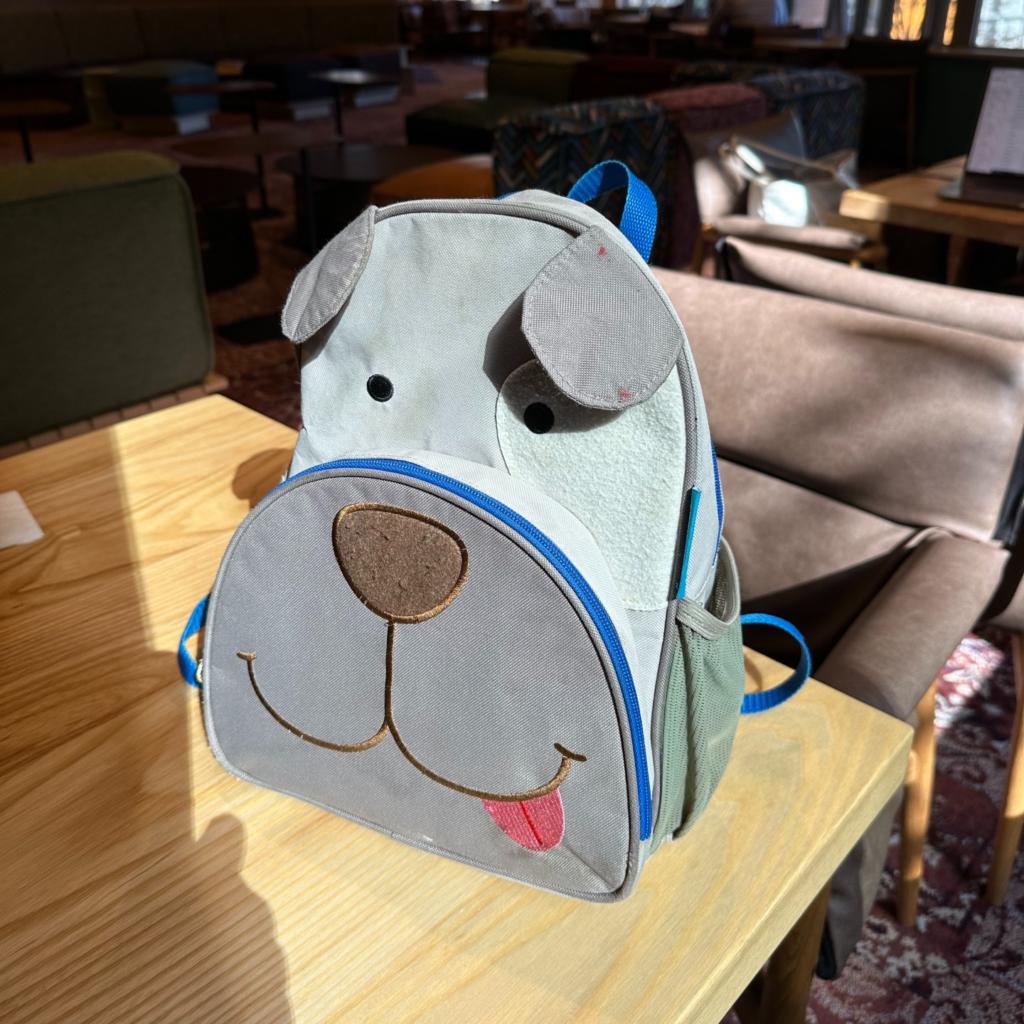
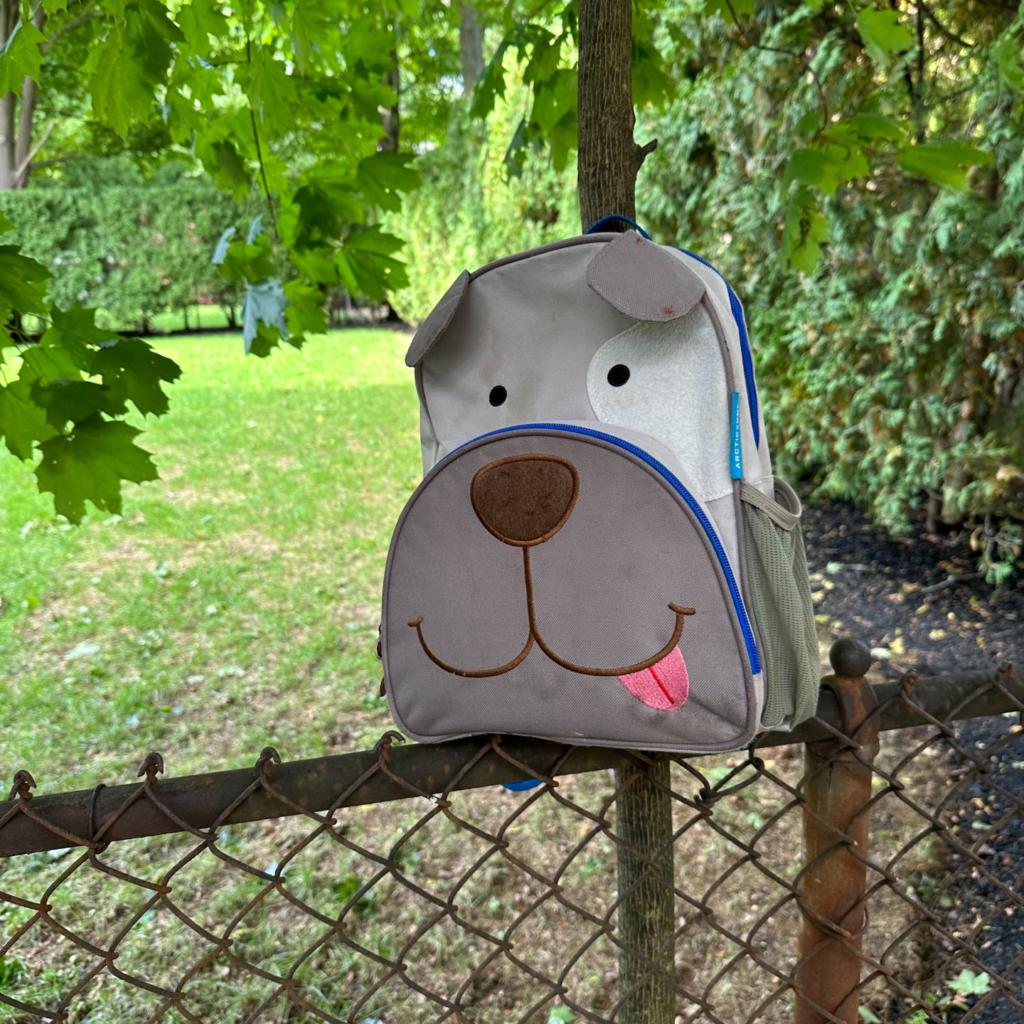
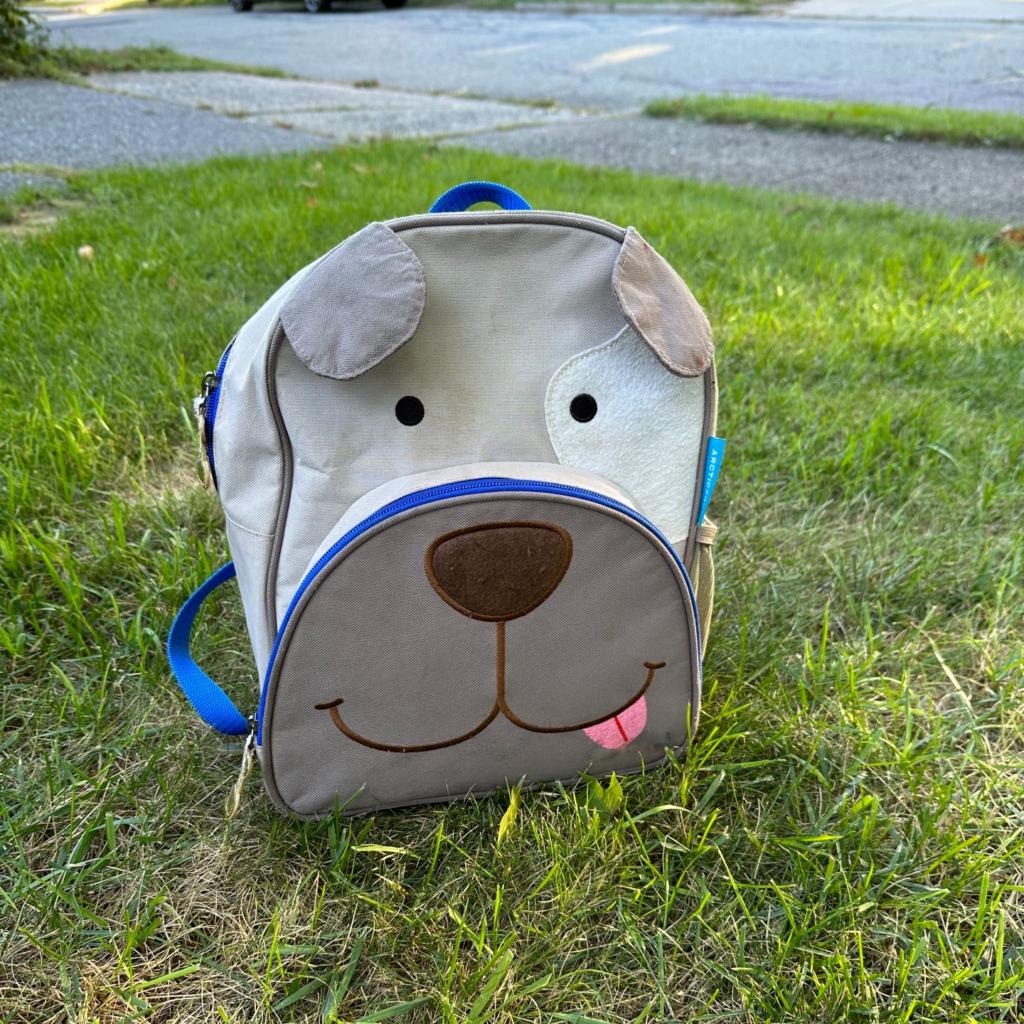
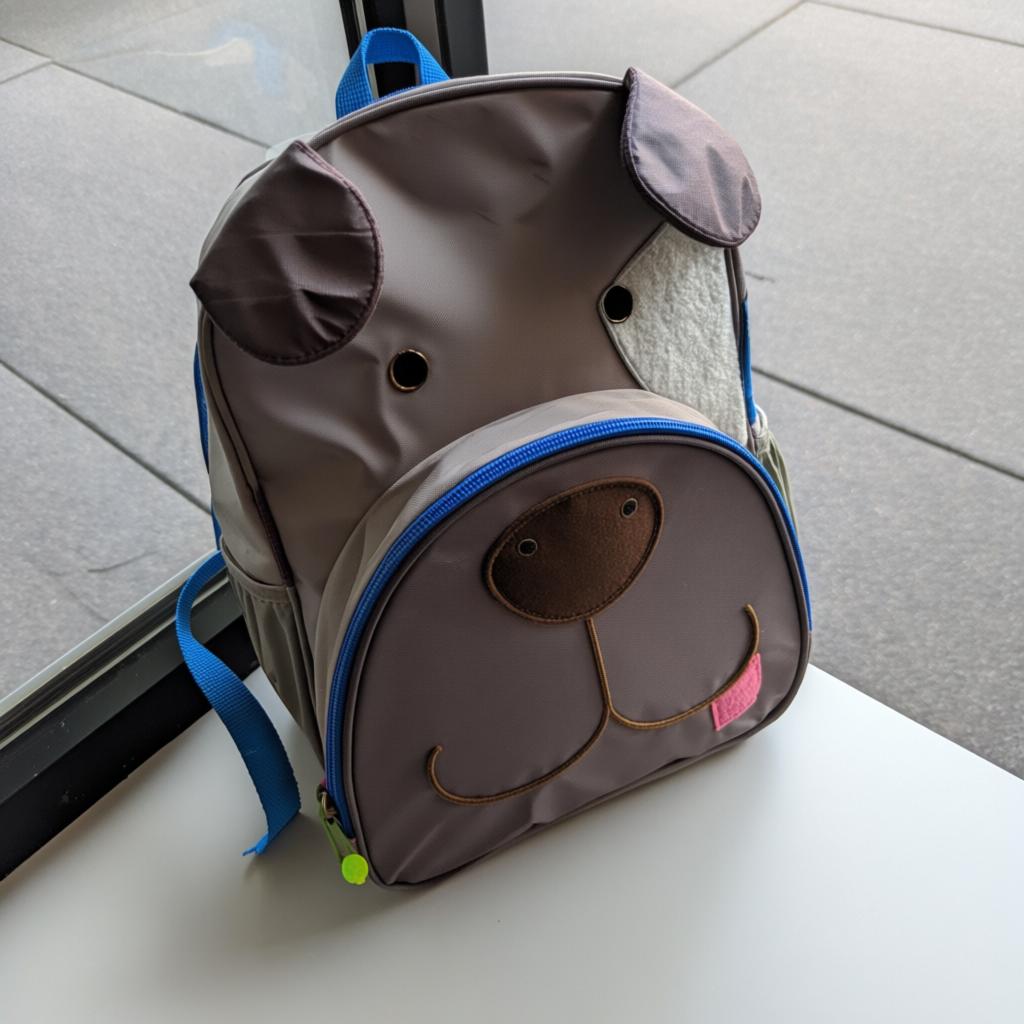
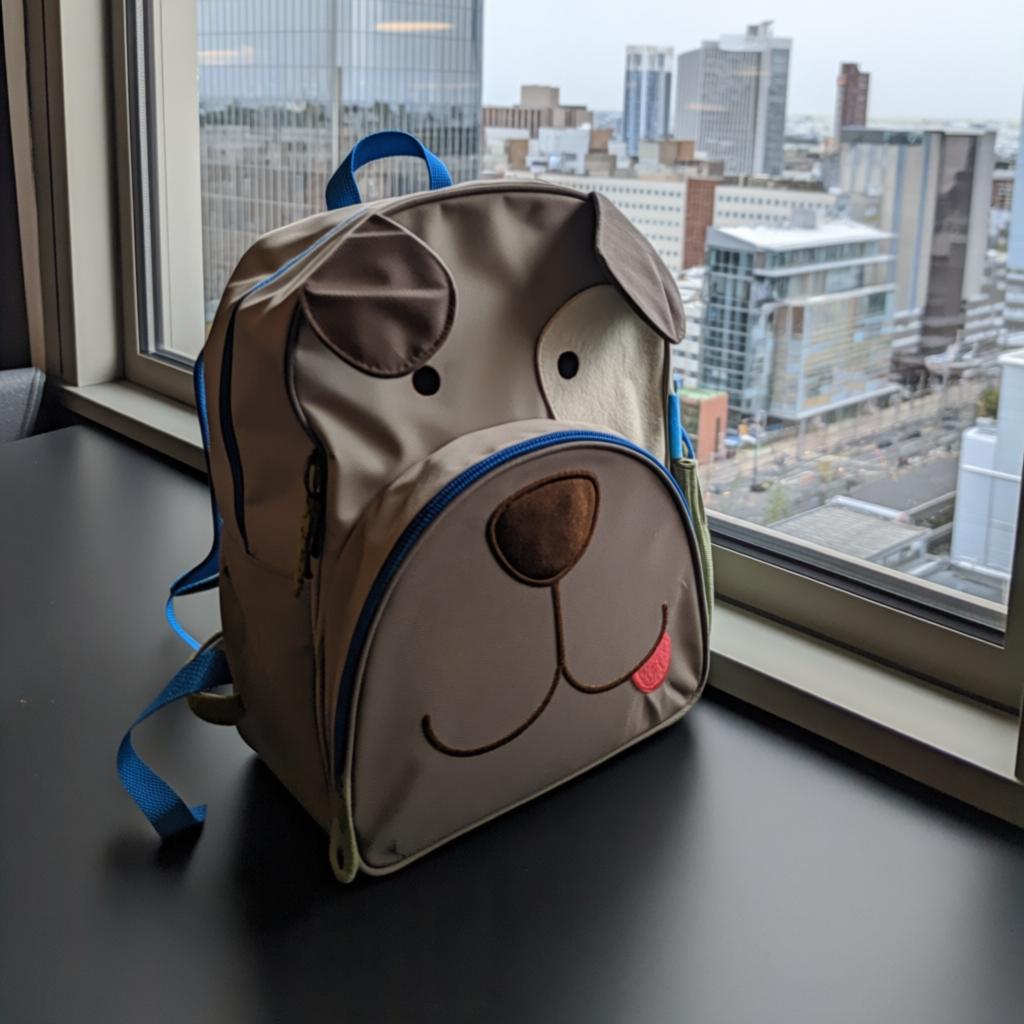
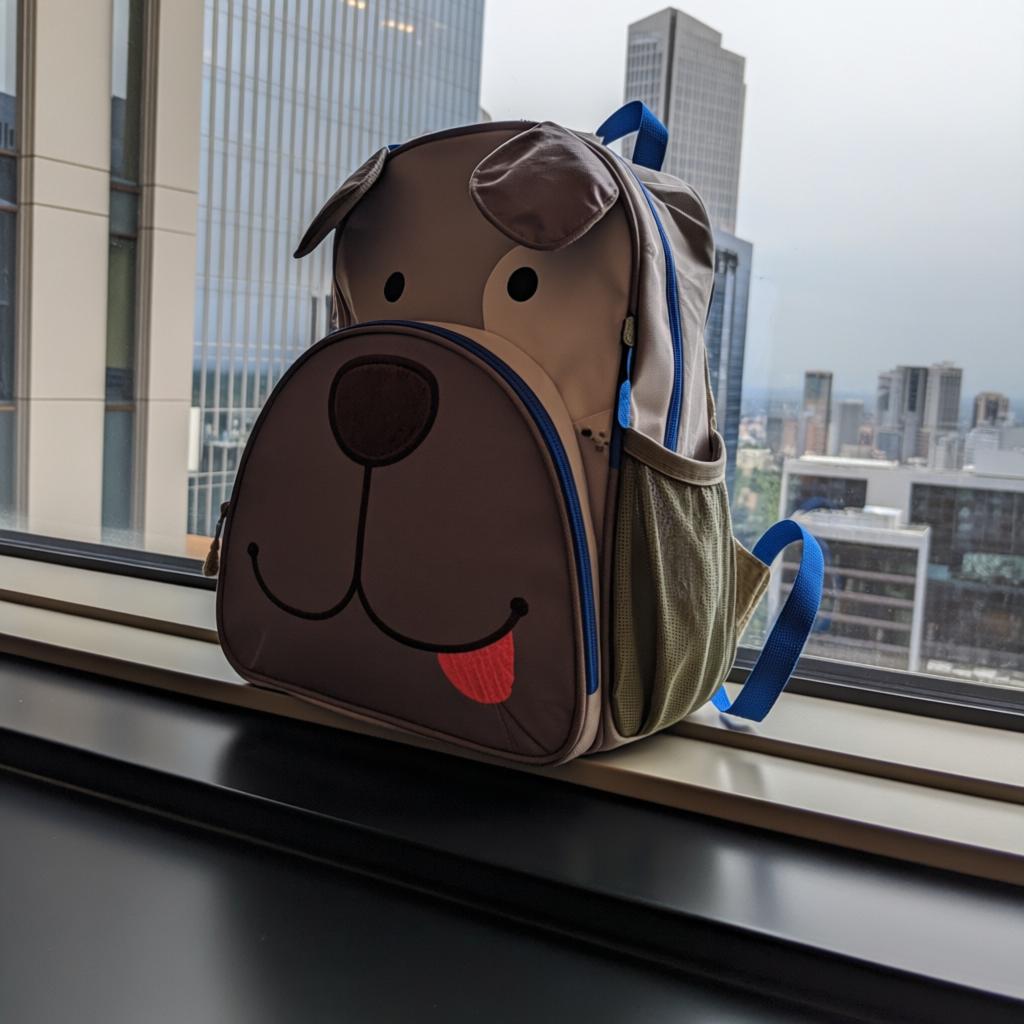
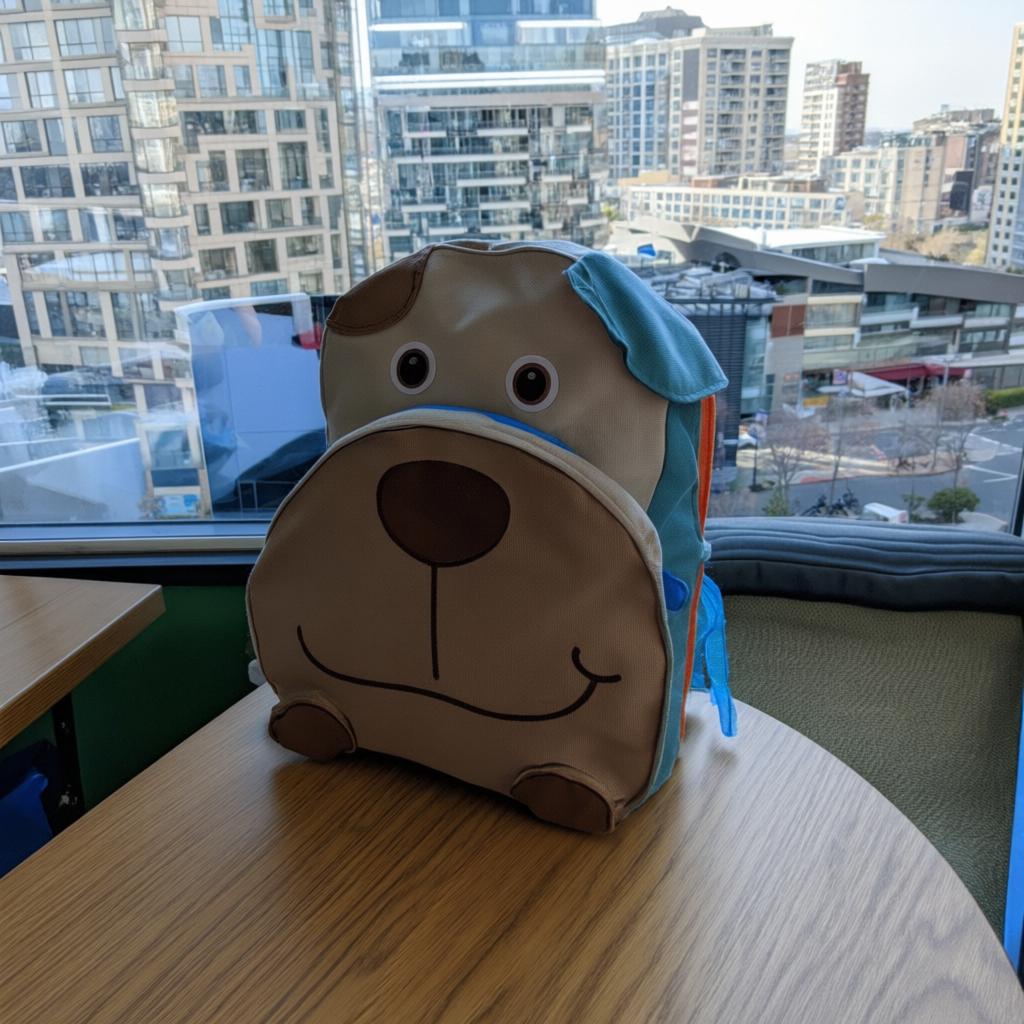
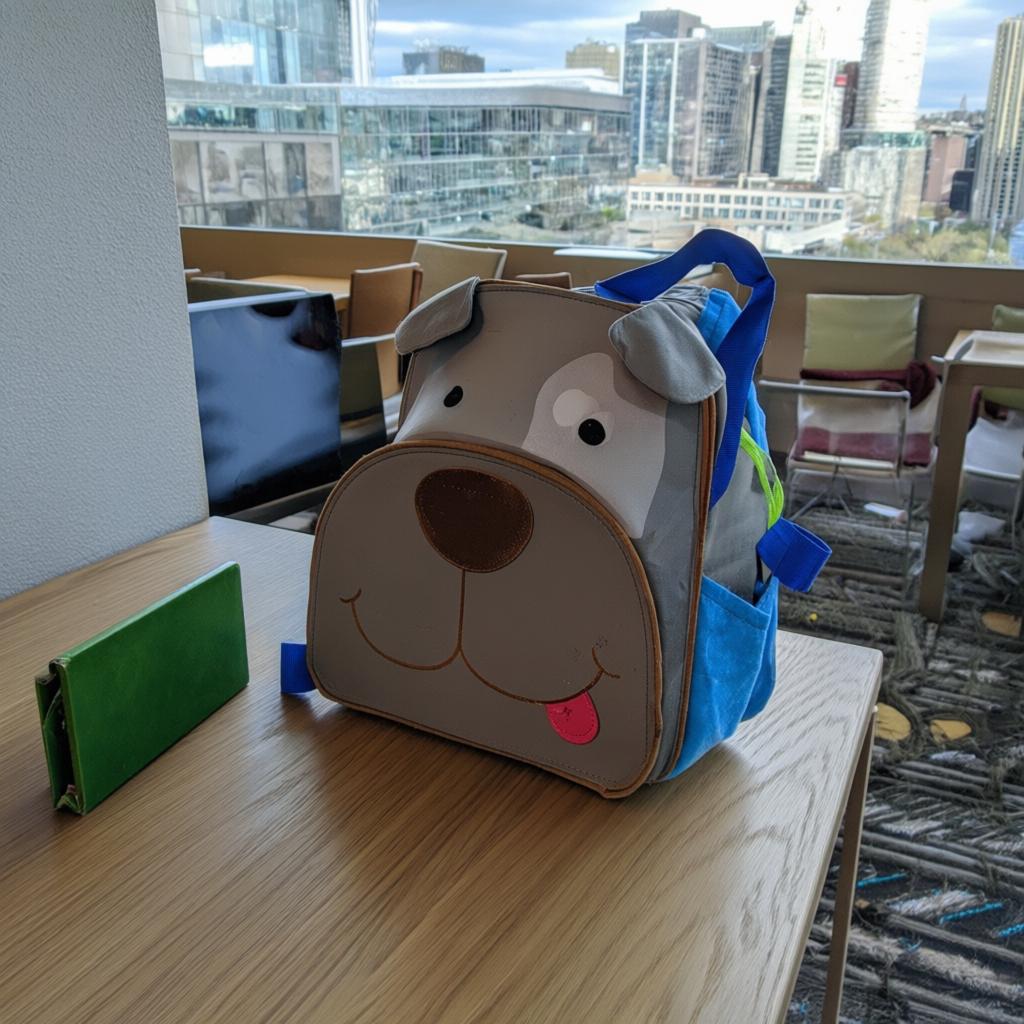
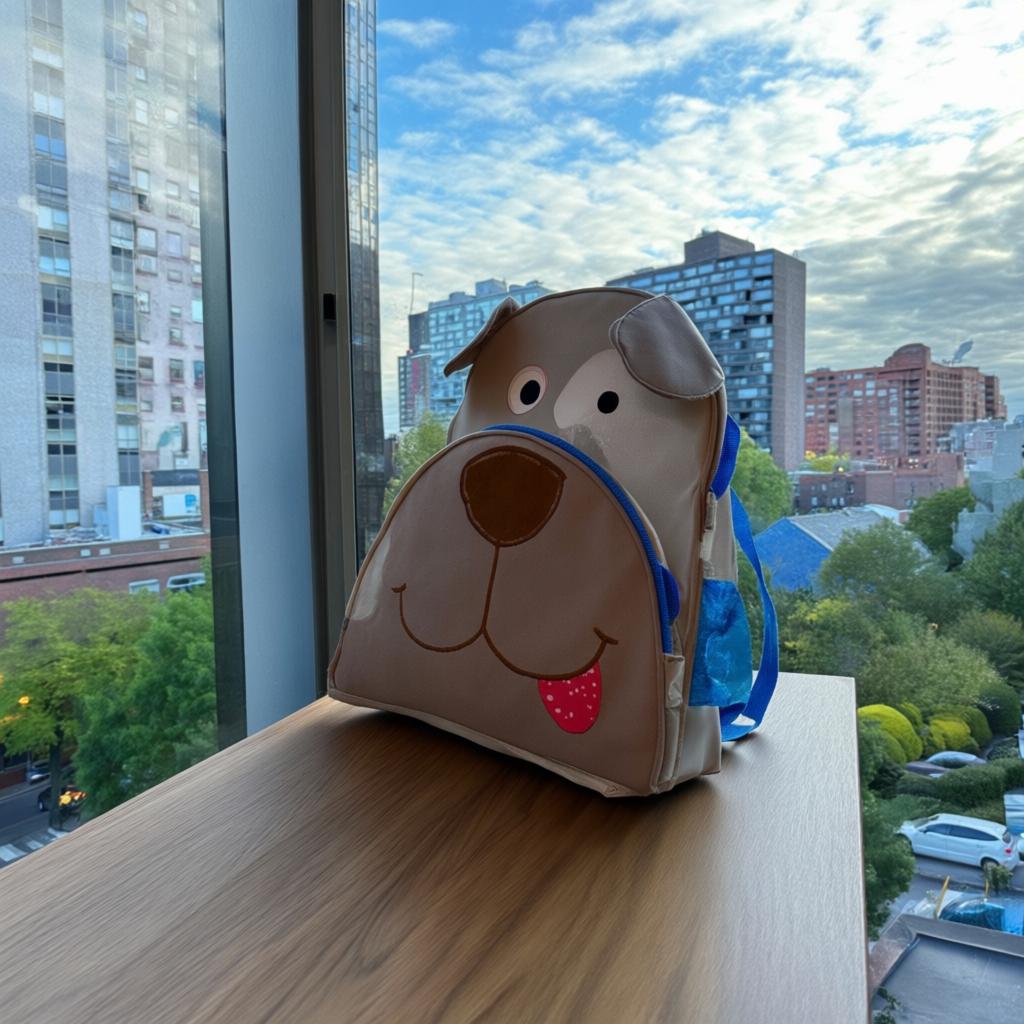
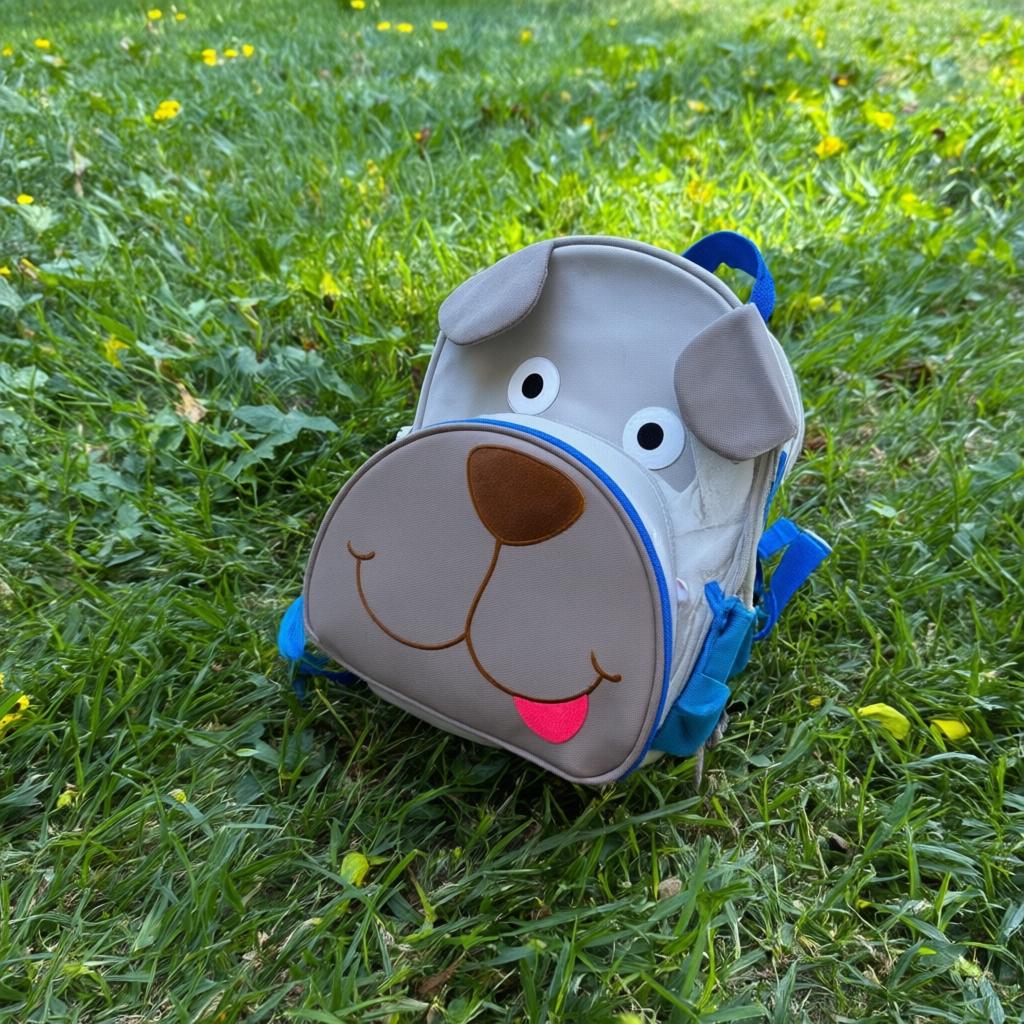
LoRA 数据集:小狗背包
训练数据:
 |
 |
 |
 |
 |
|---|
训练中的样图生成:
| 训练步数:100 | 训练步数:200 | 训练步数:300 | 训练步数:400 | 训练步数:500 | |
|---|---|---|---|---|---|
| 随机初始化 | 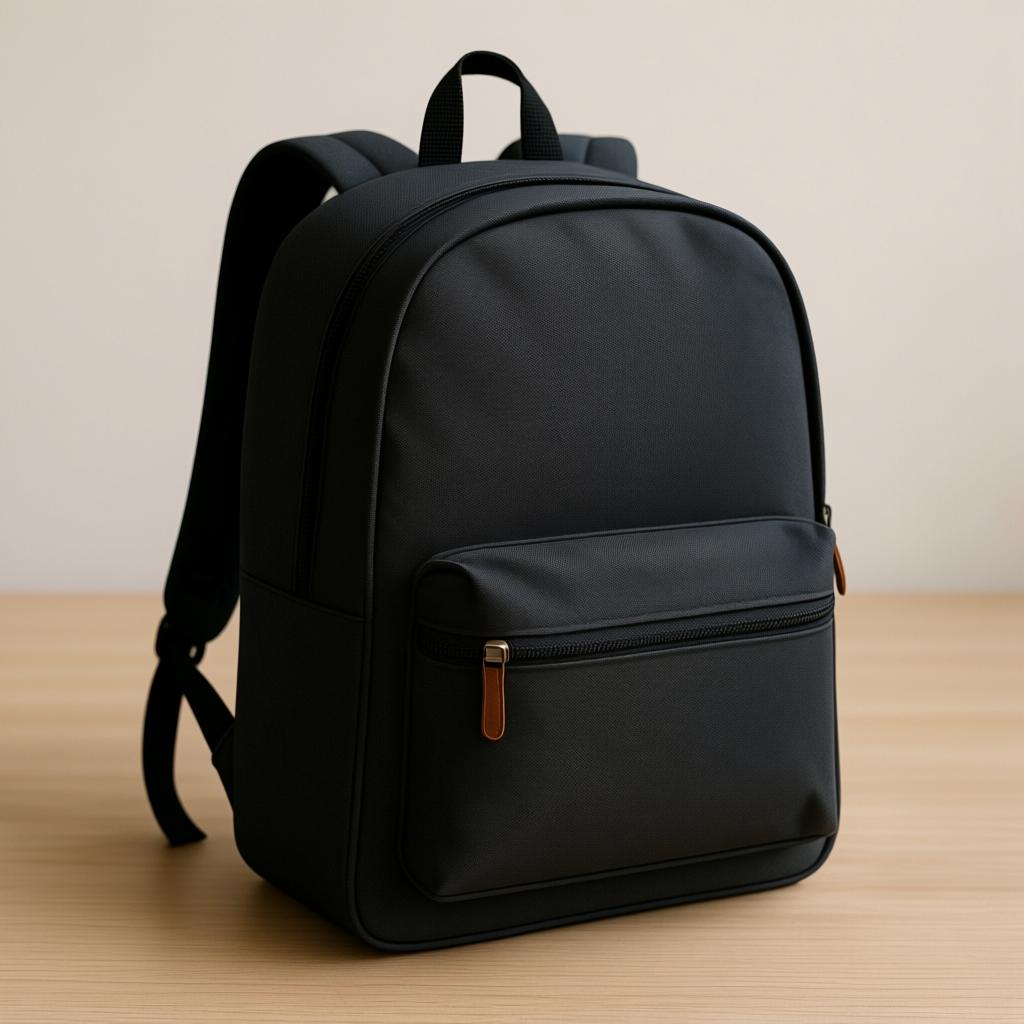 |
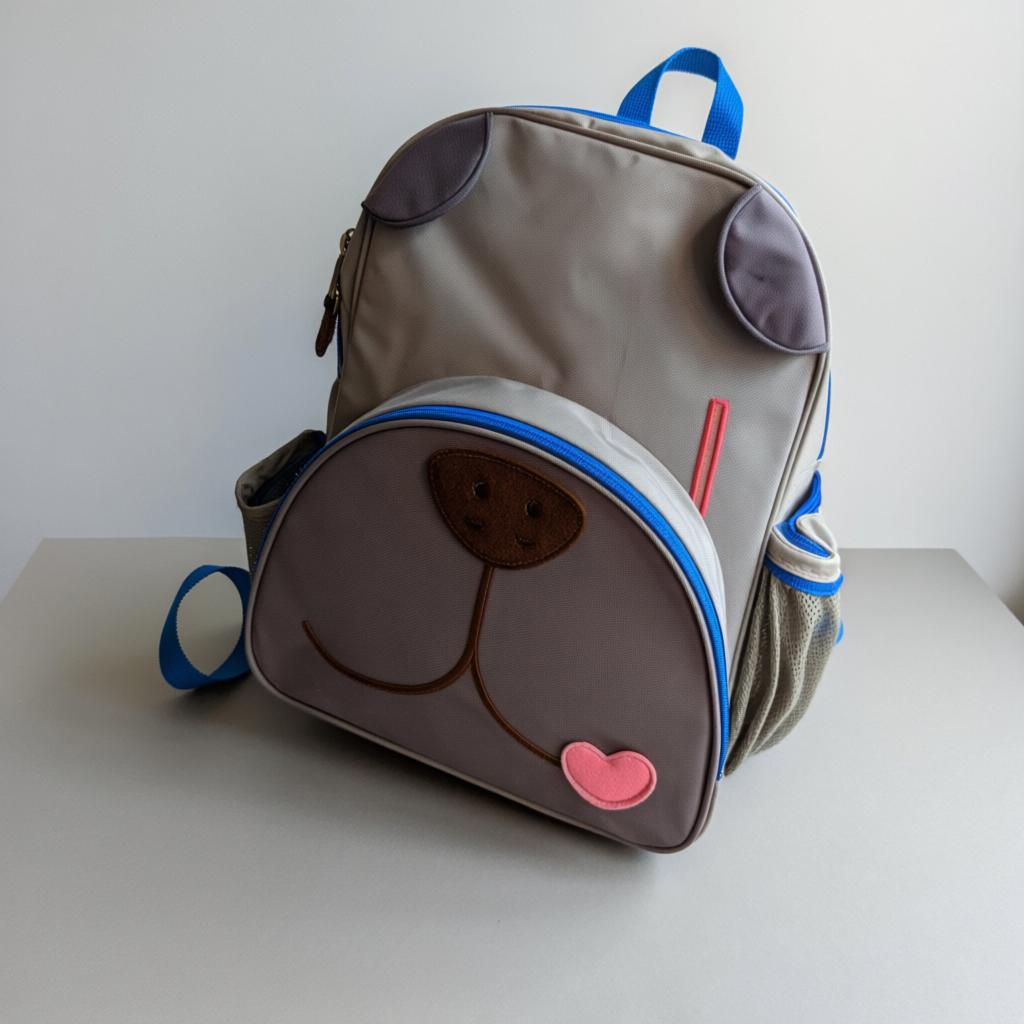 |
 |
 |
 |
| Image to LoRA 初始化 | 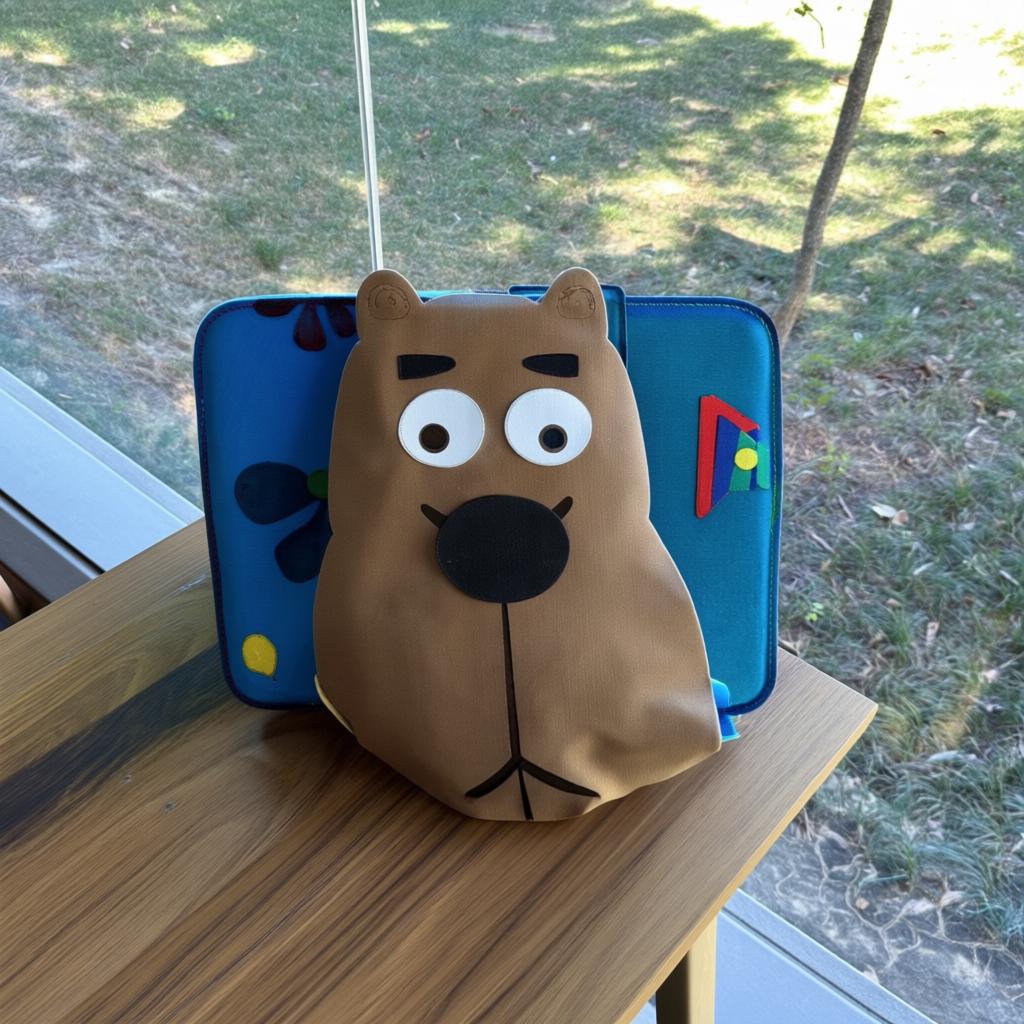 |
 |
 |
 |
 |
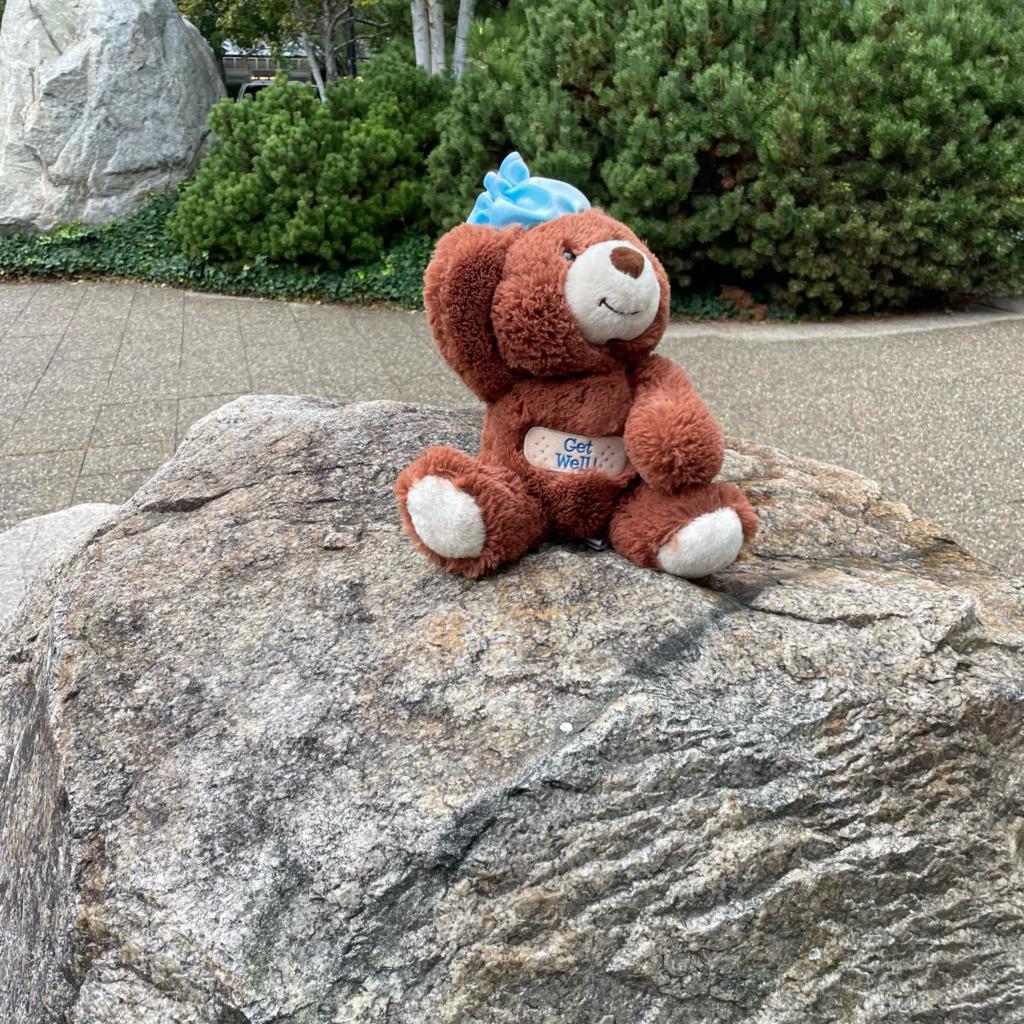
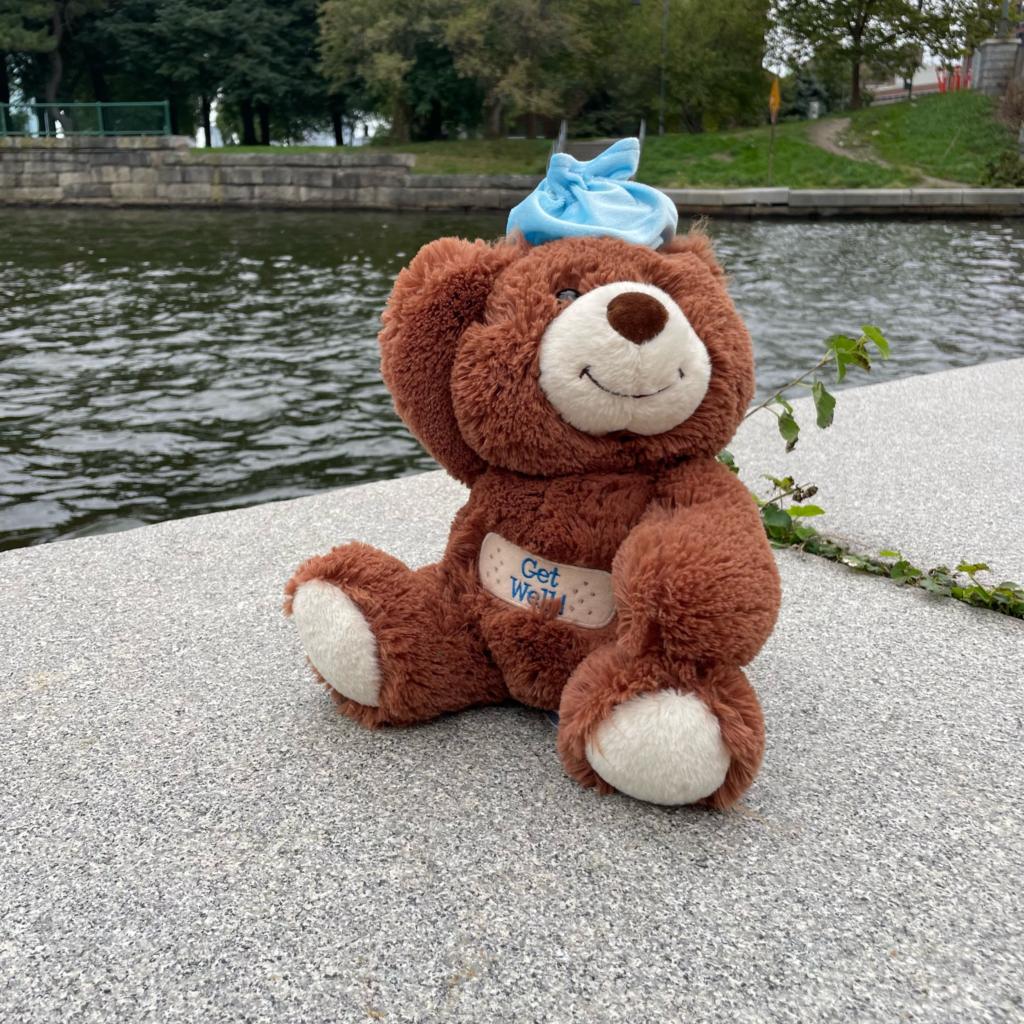
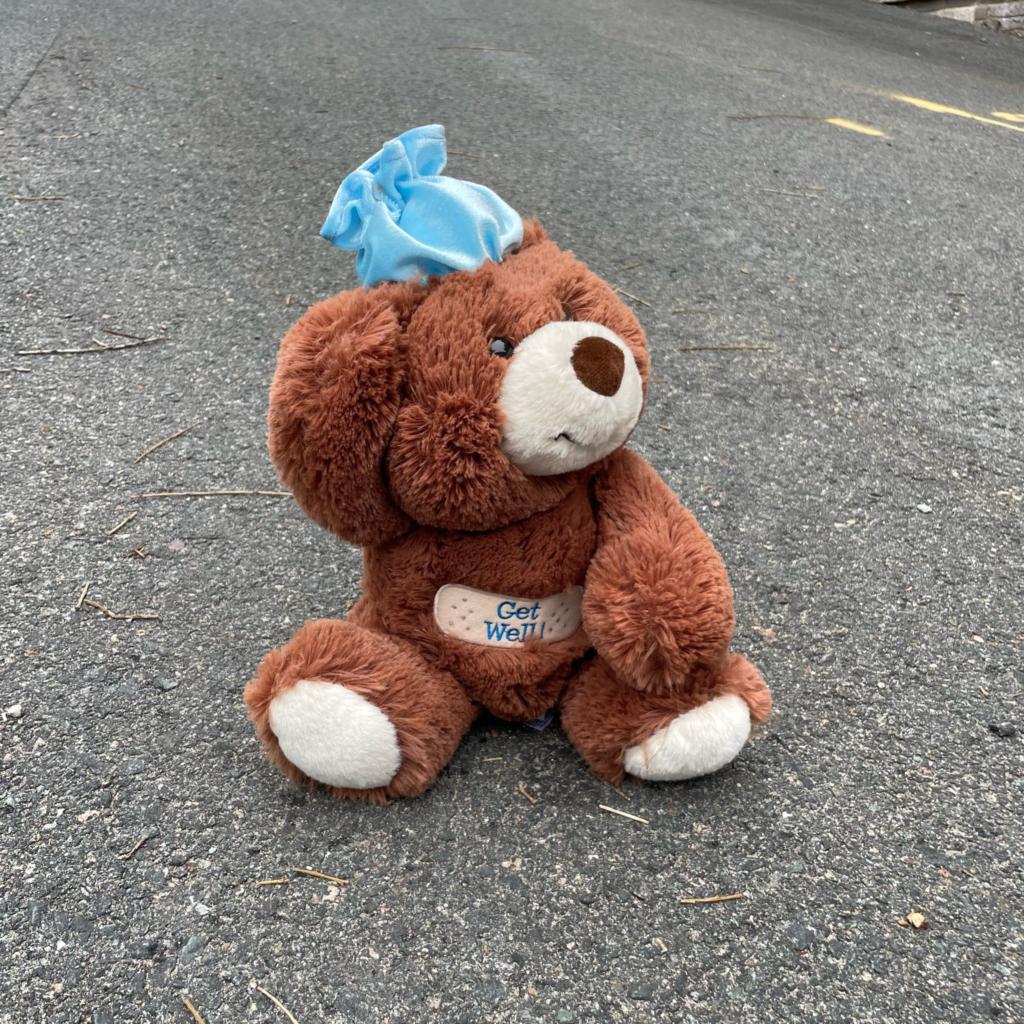
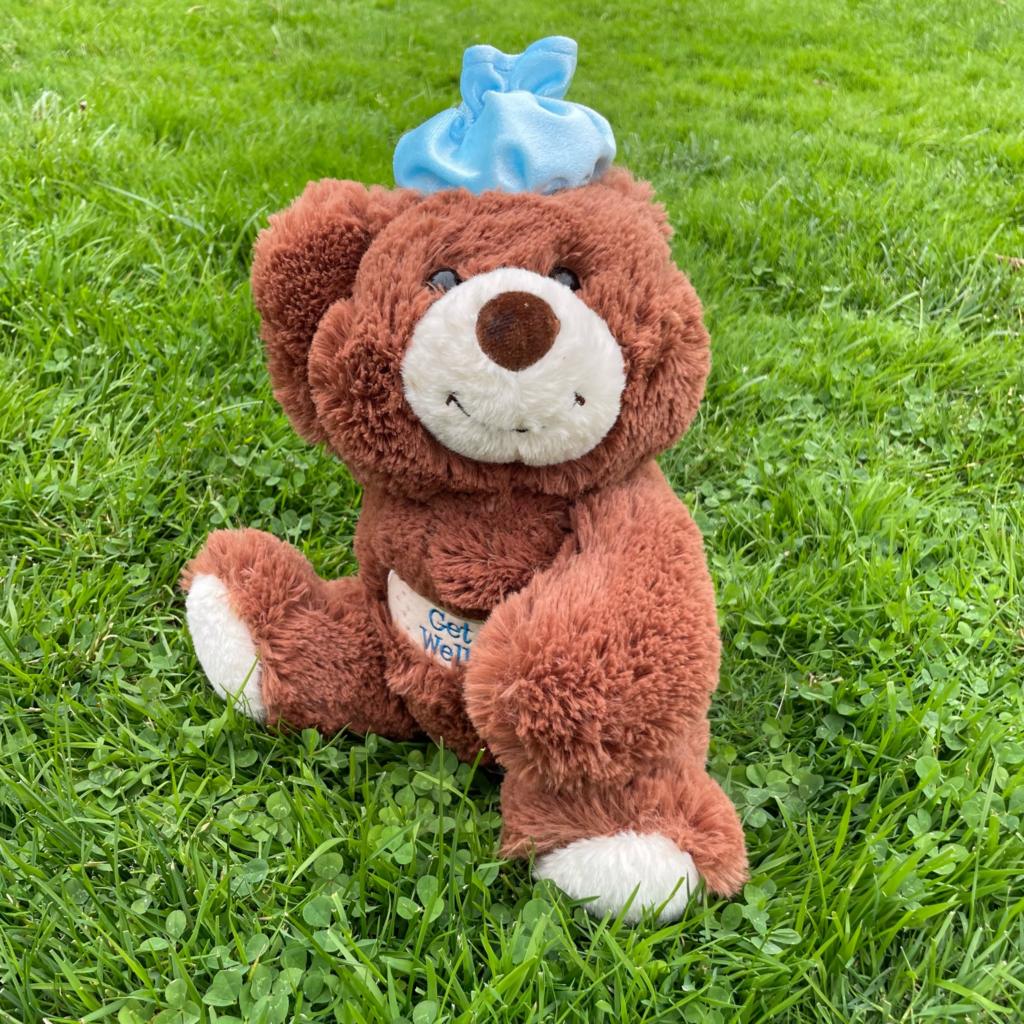
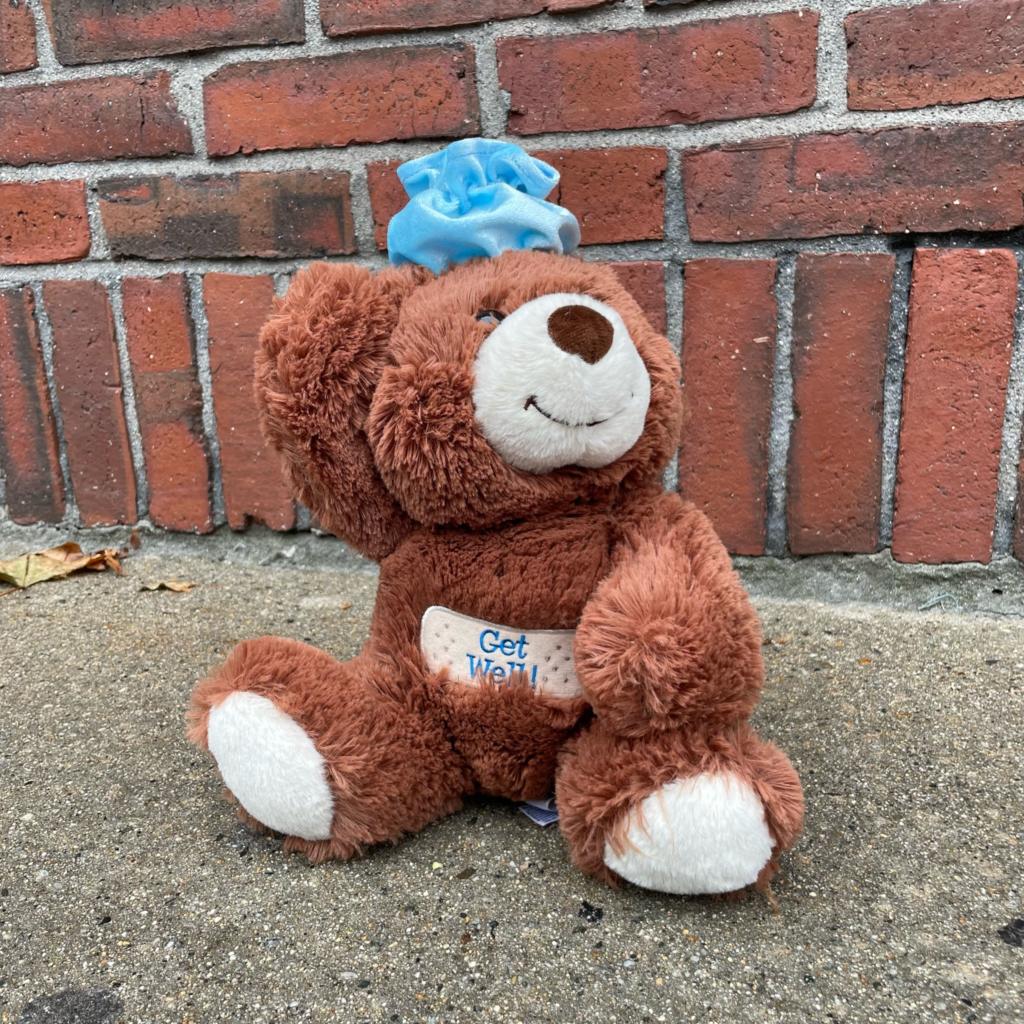
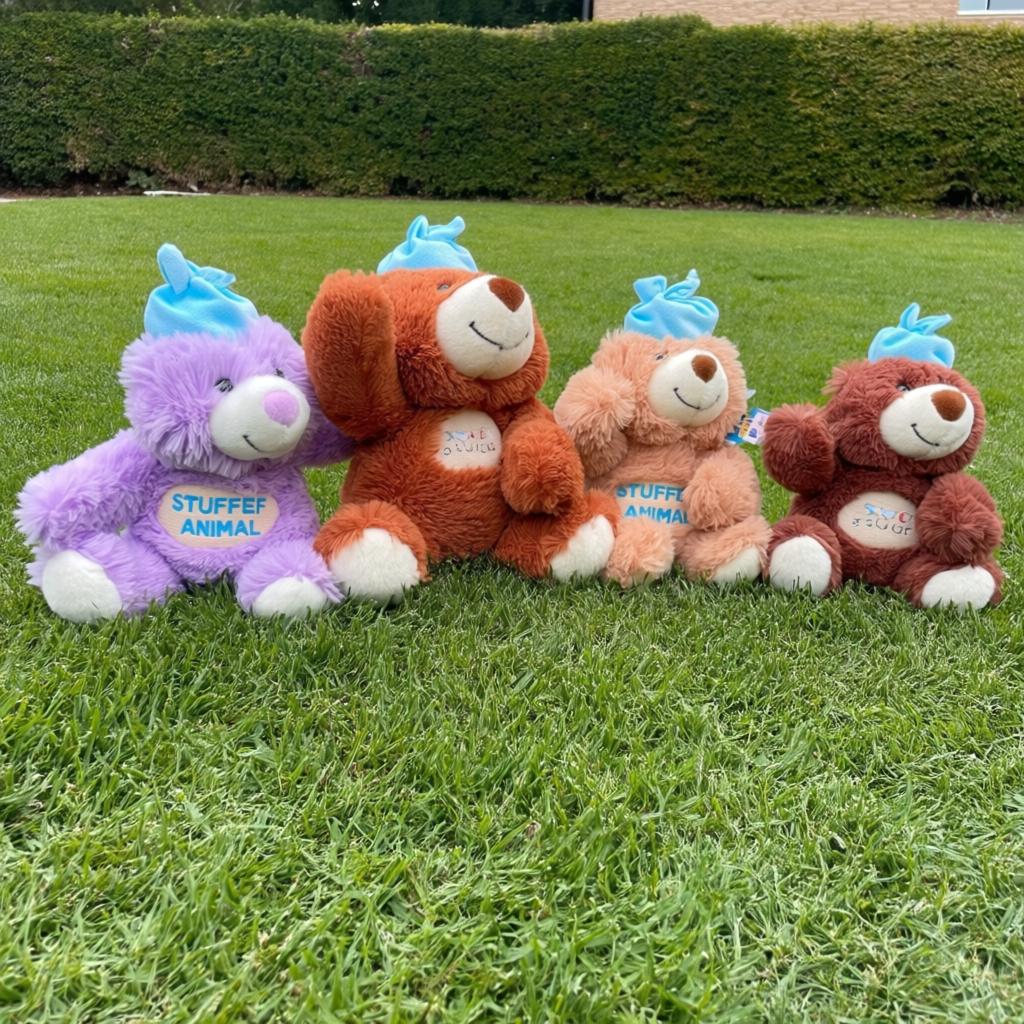
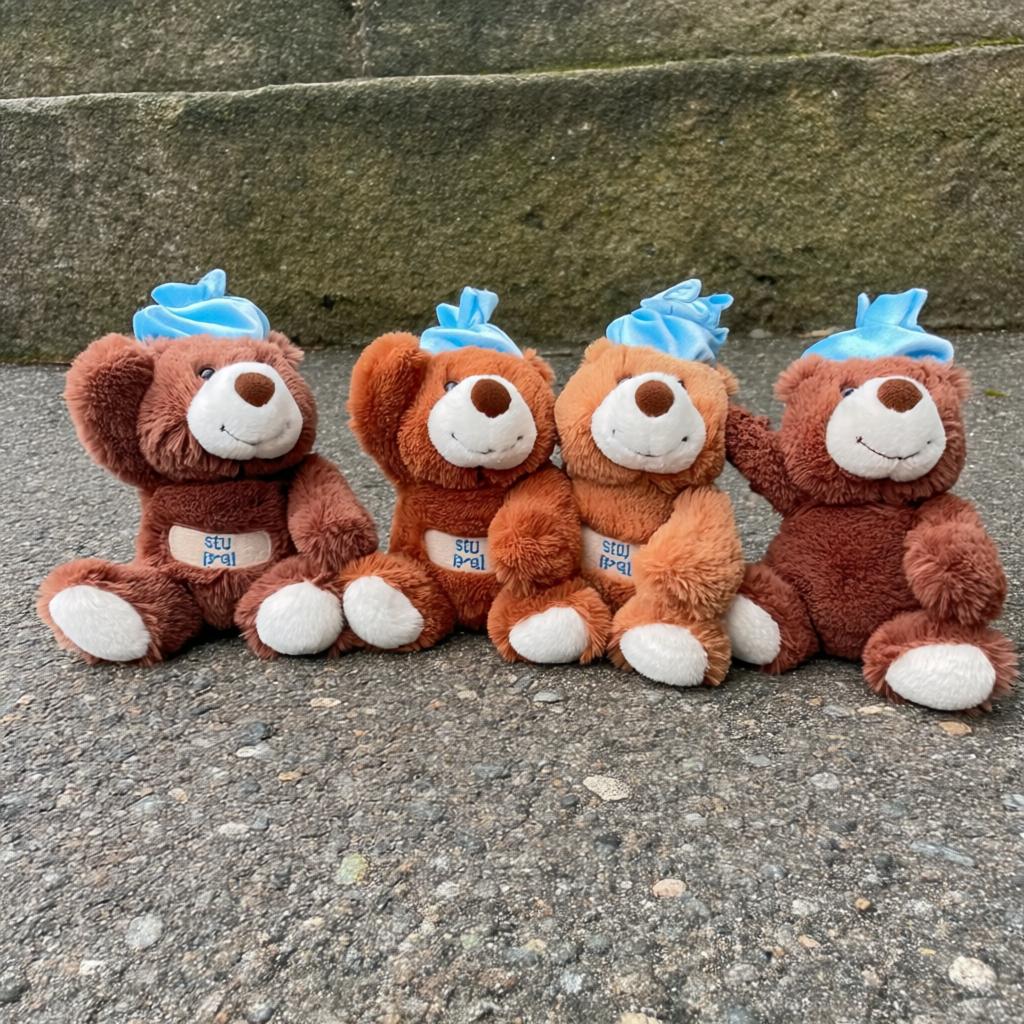
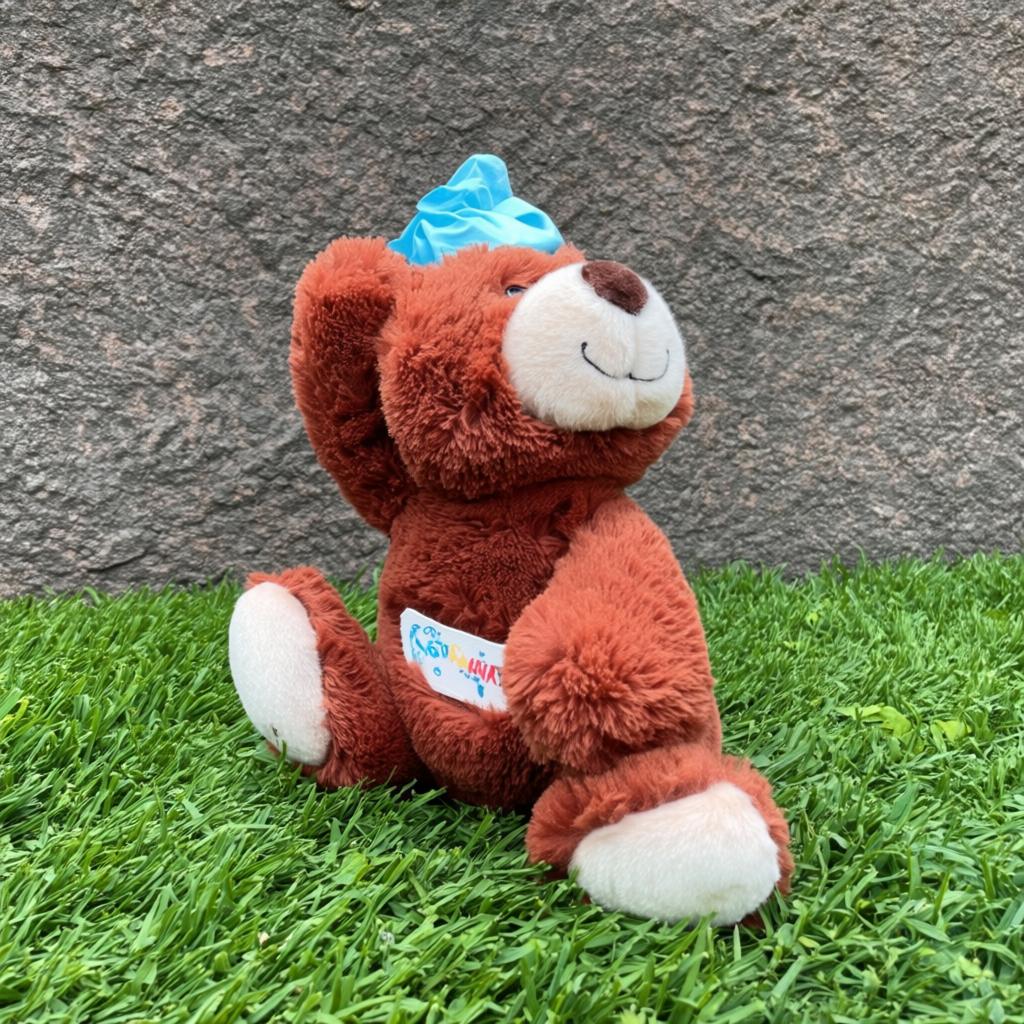
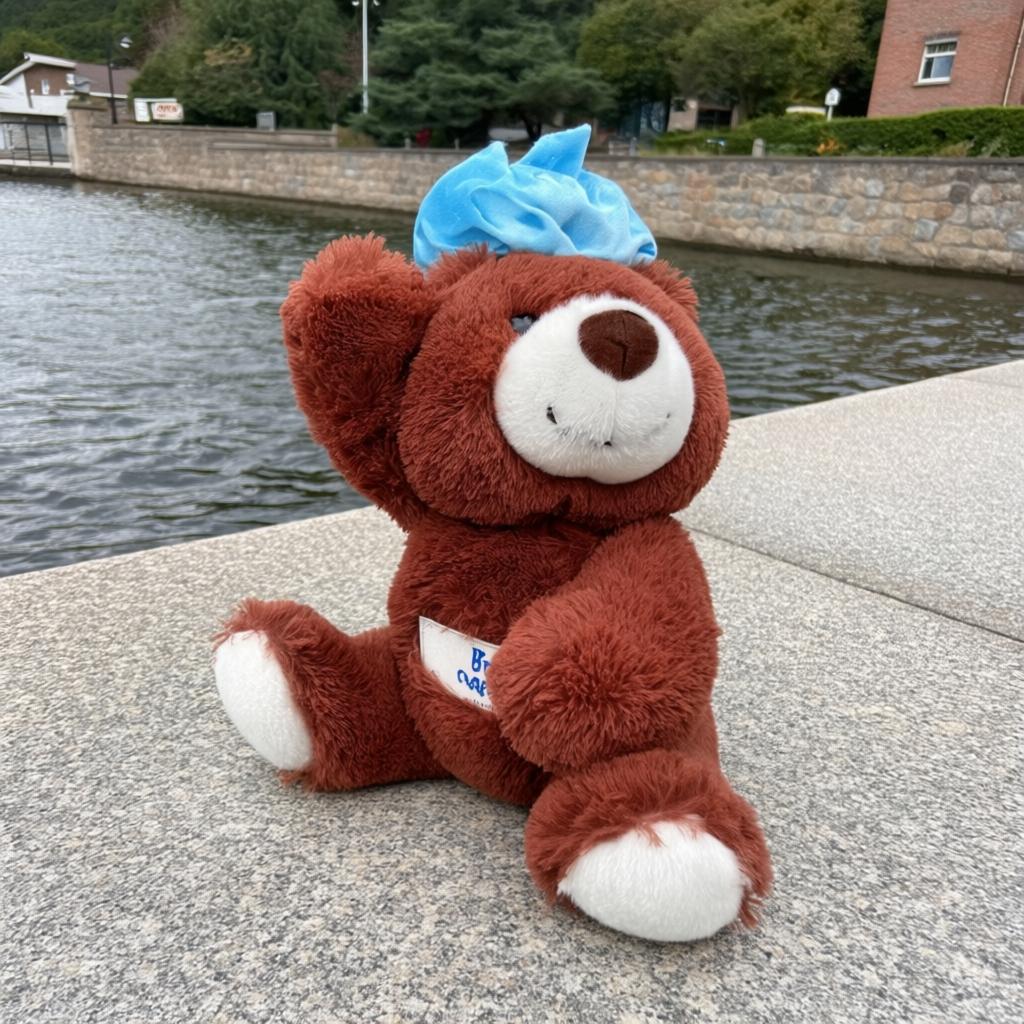
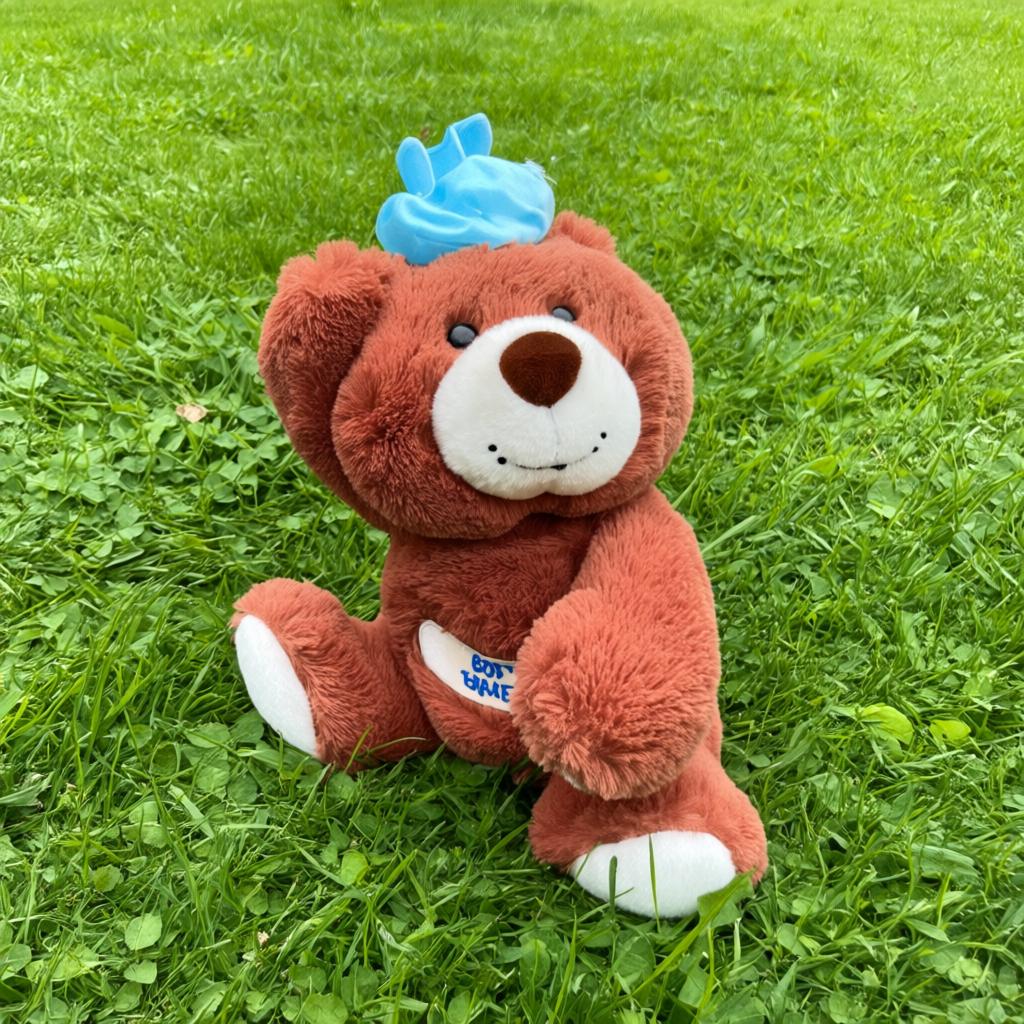
LoRA 数据集:小熊玩偶
训练数据:
 |
 |
 |
 |
 |
|---|
训练中的样图生成:
| 训练步数:100 | 训练步数:200 | 训练步数:300 | 训练步数:400 | 训练步数:500 | |
|---|---|---|---|---|---|
| 随机初始化 | 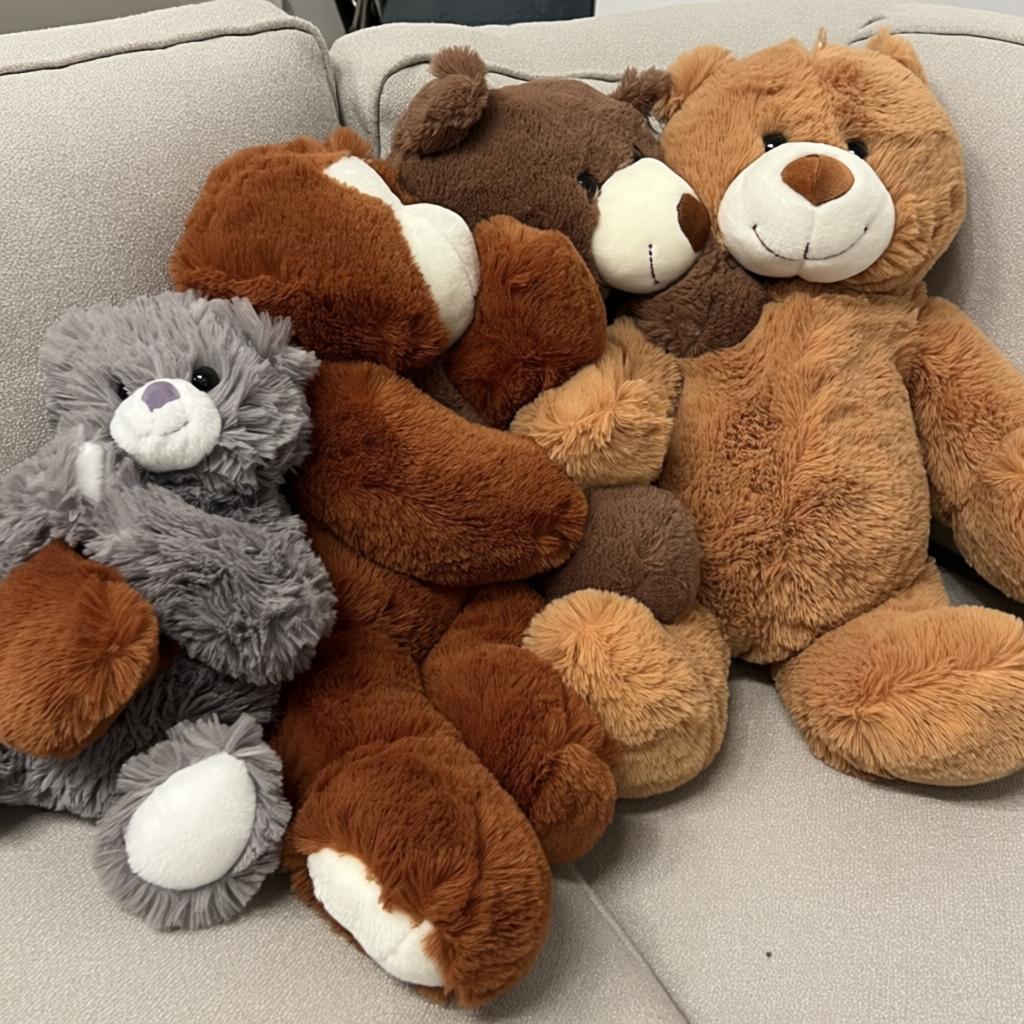 |
 |
 |
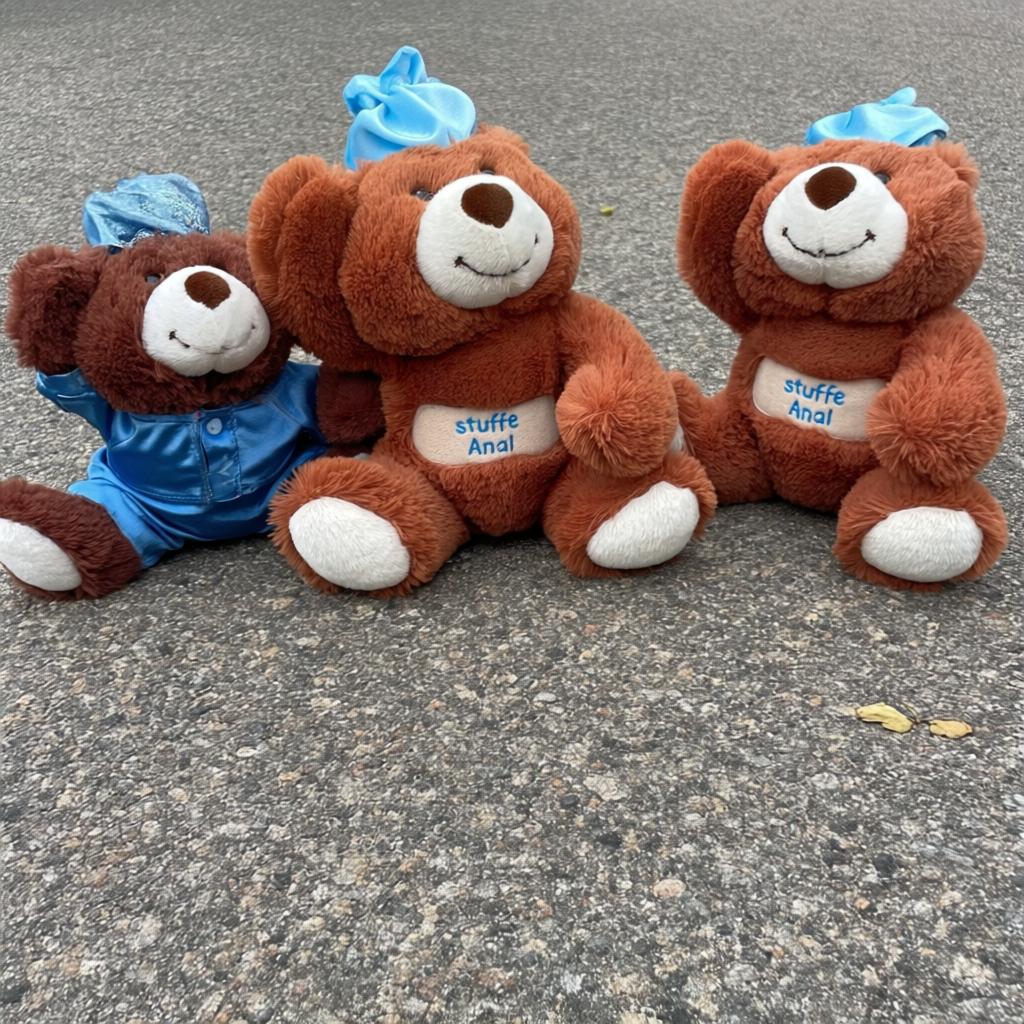 |
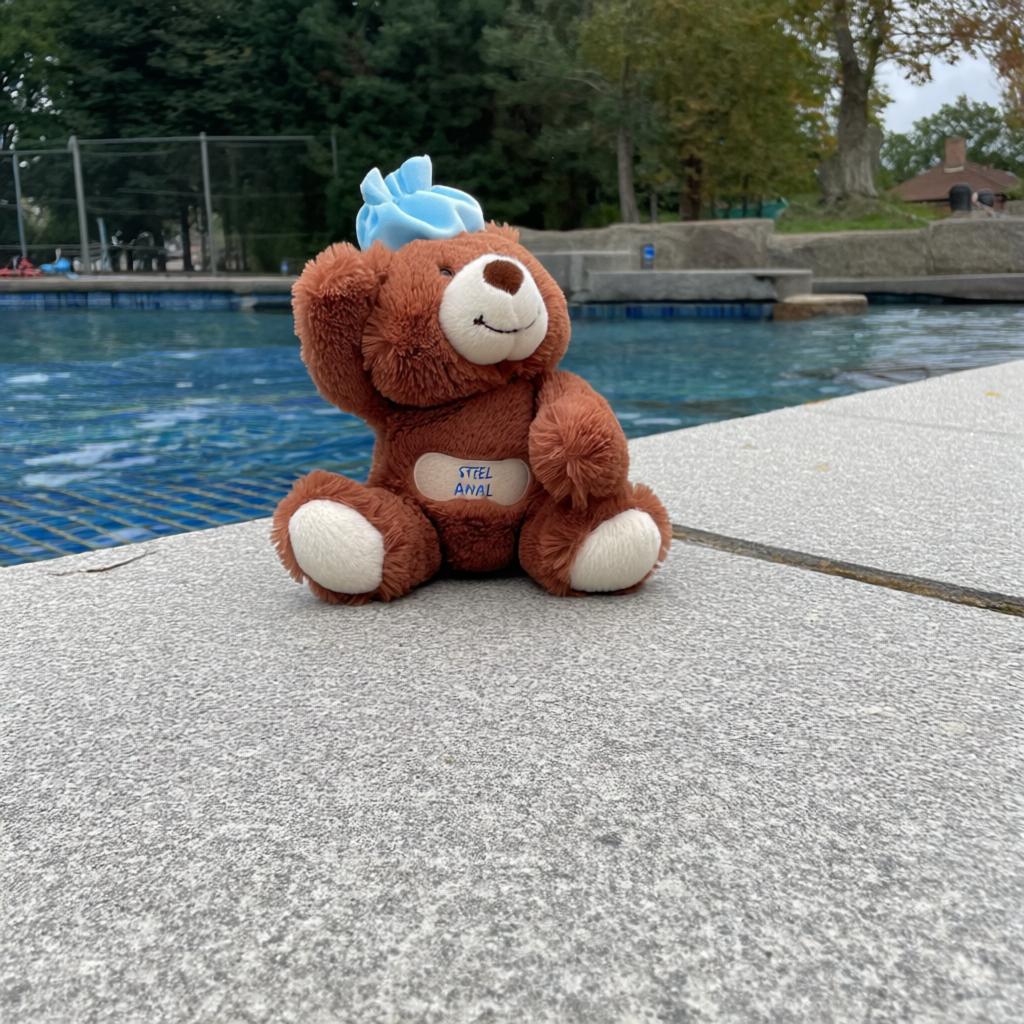 |
| Image to LoRA 初始化 | 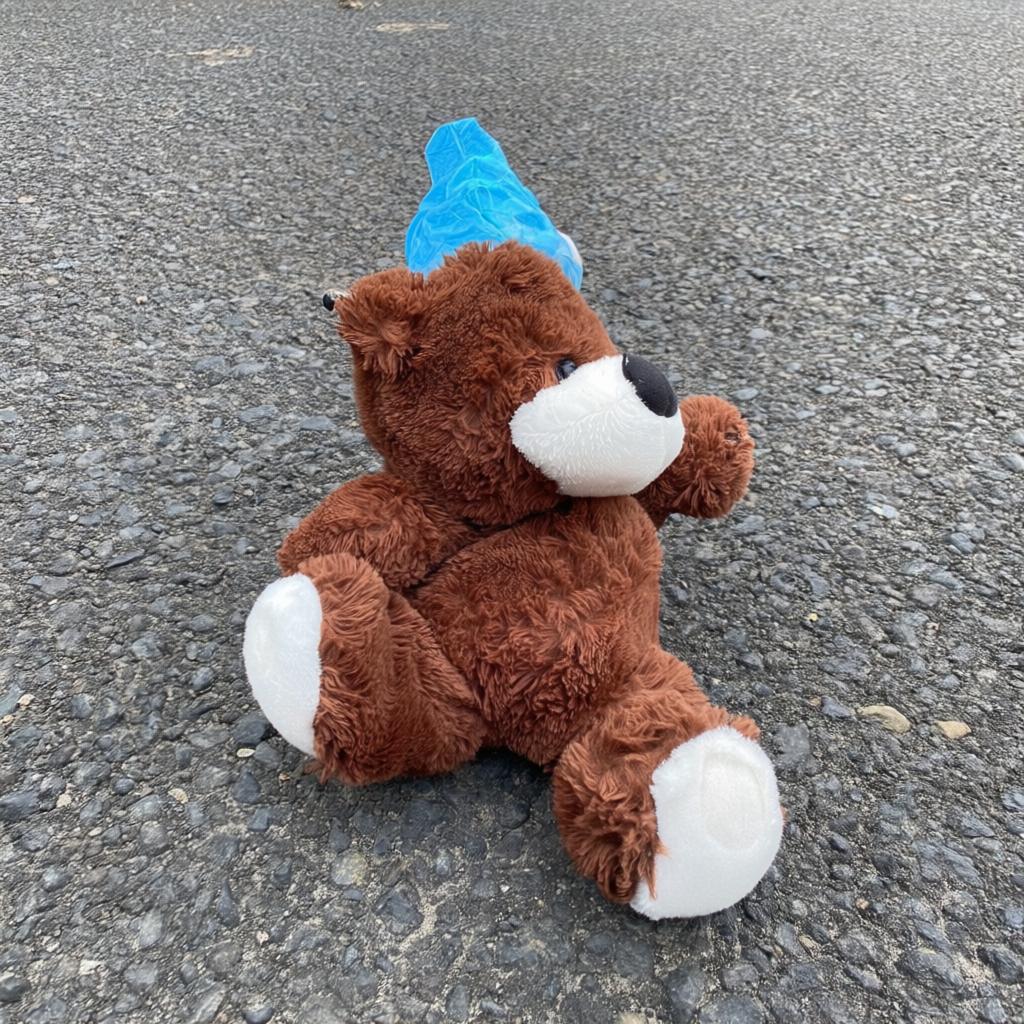 |
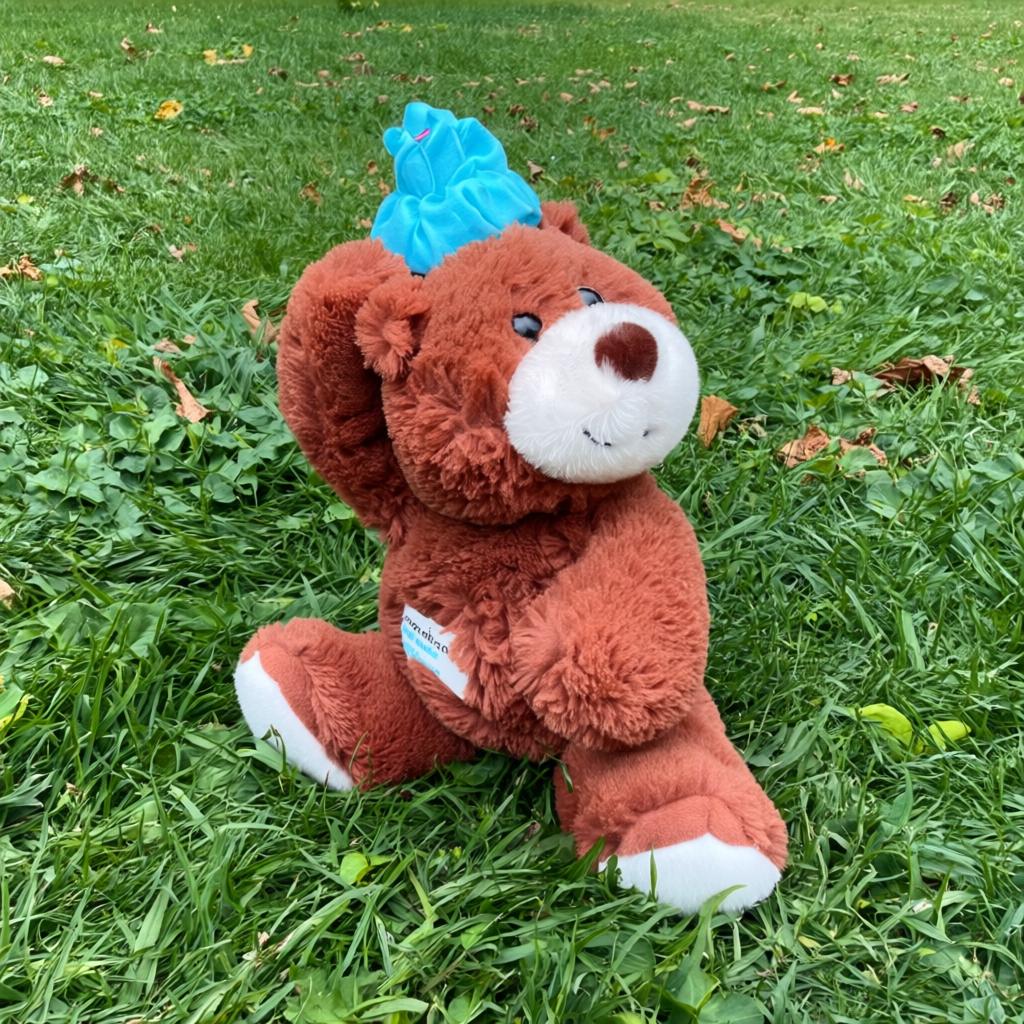 |
 |
 |
 |
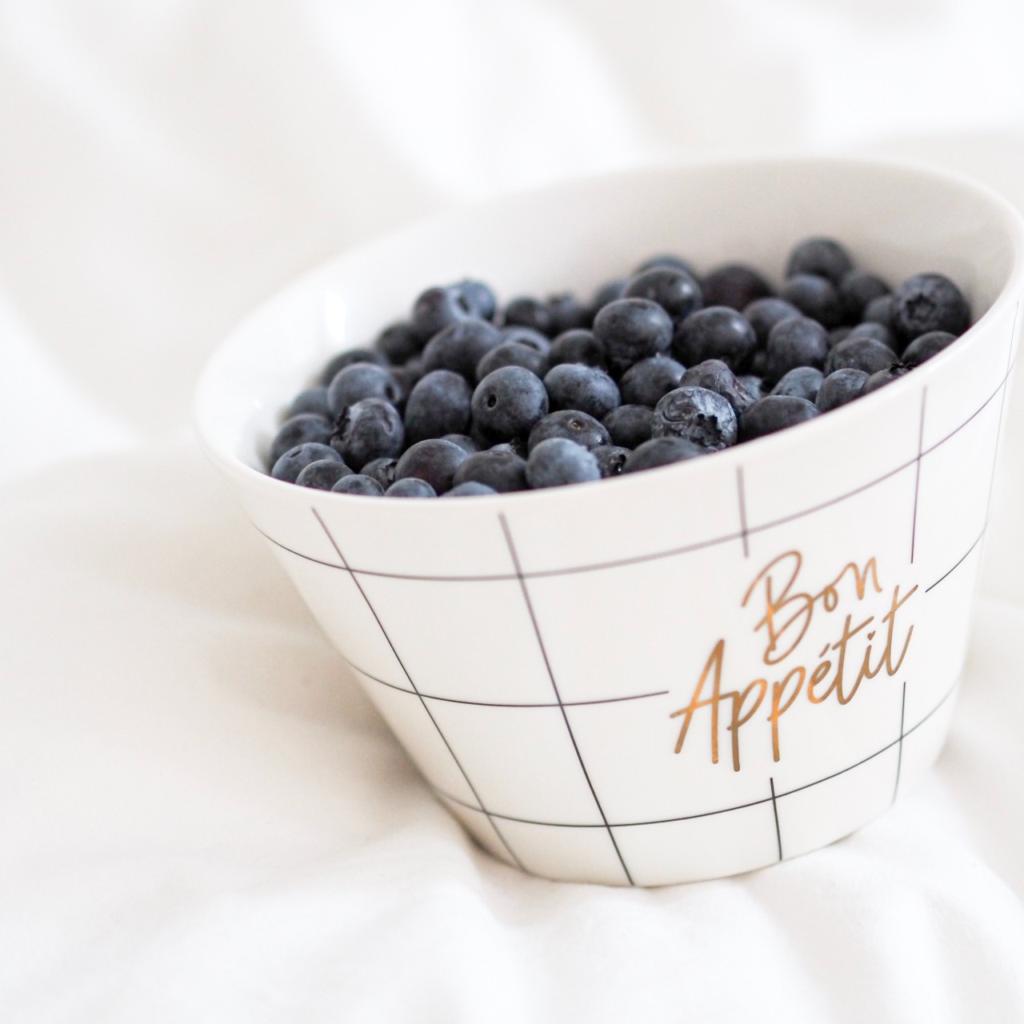
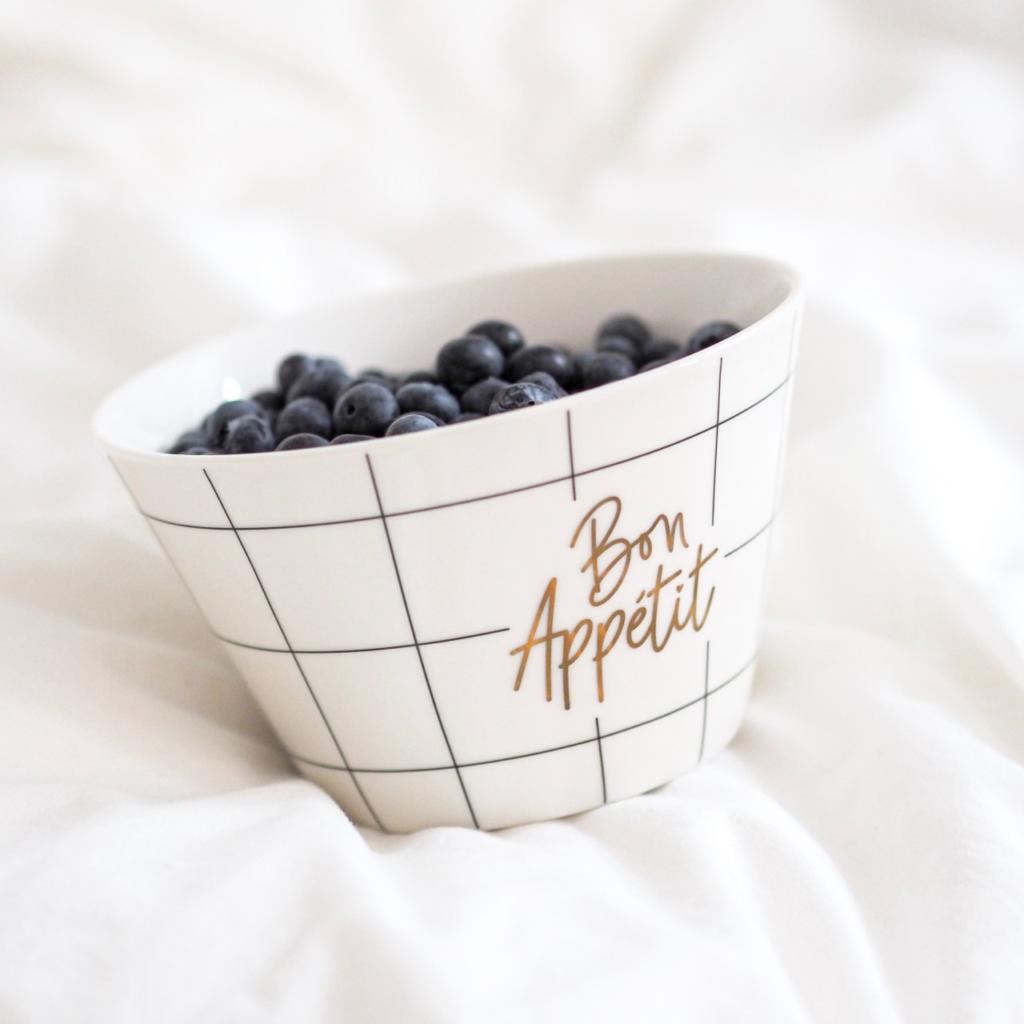
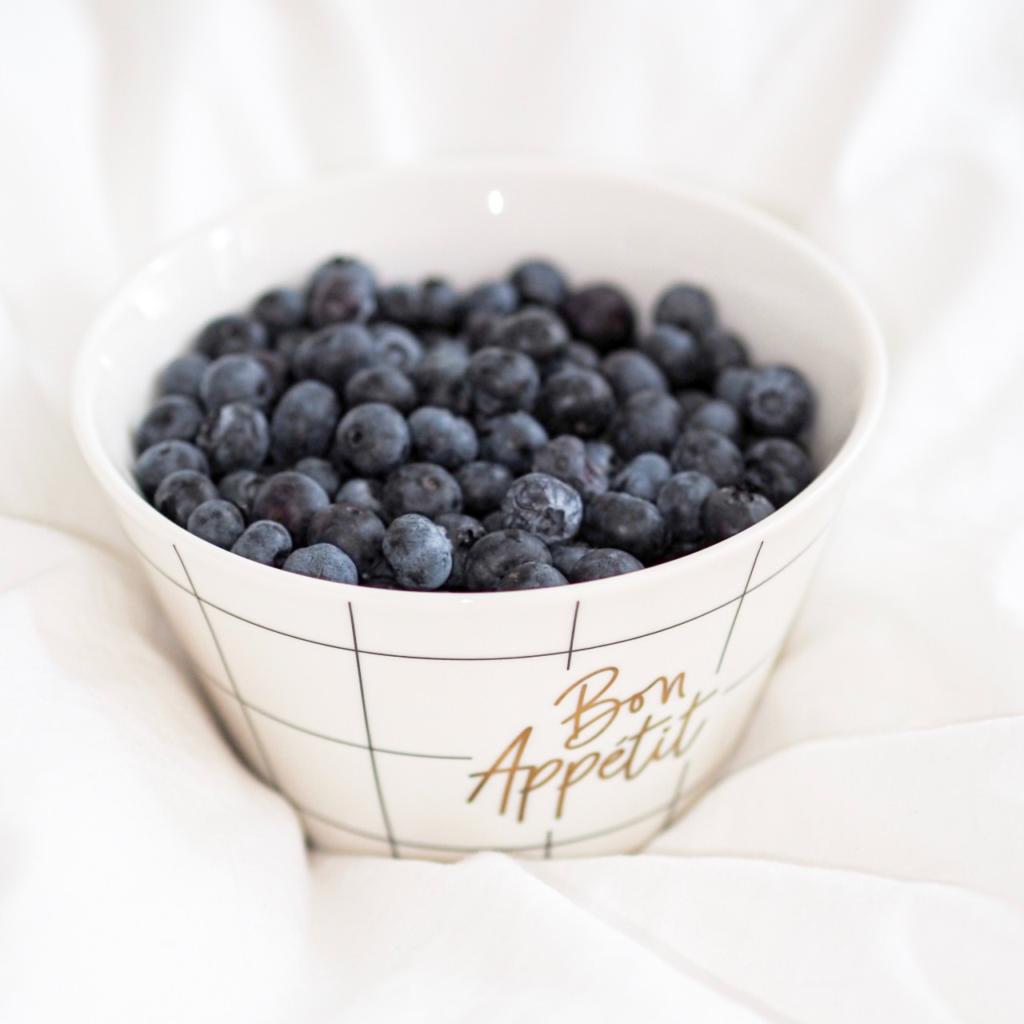
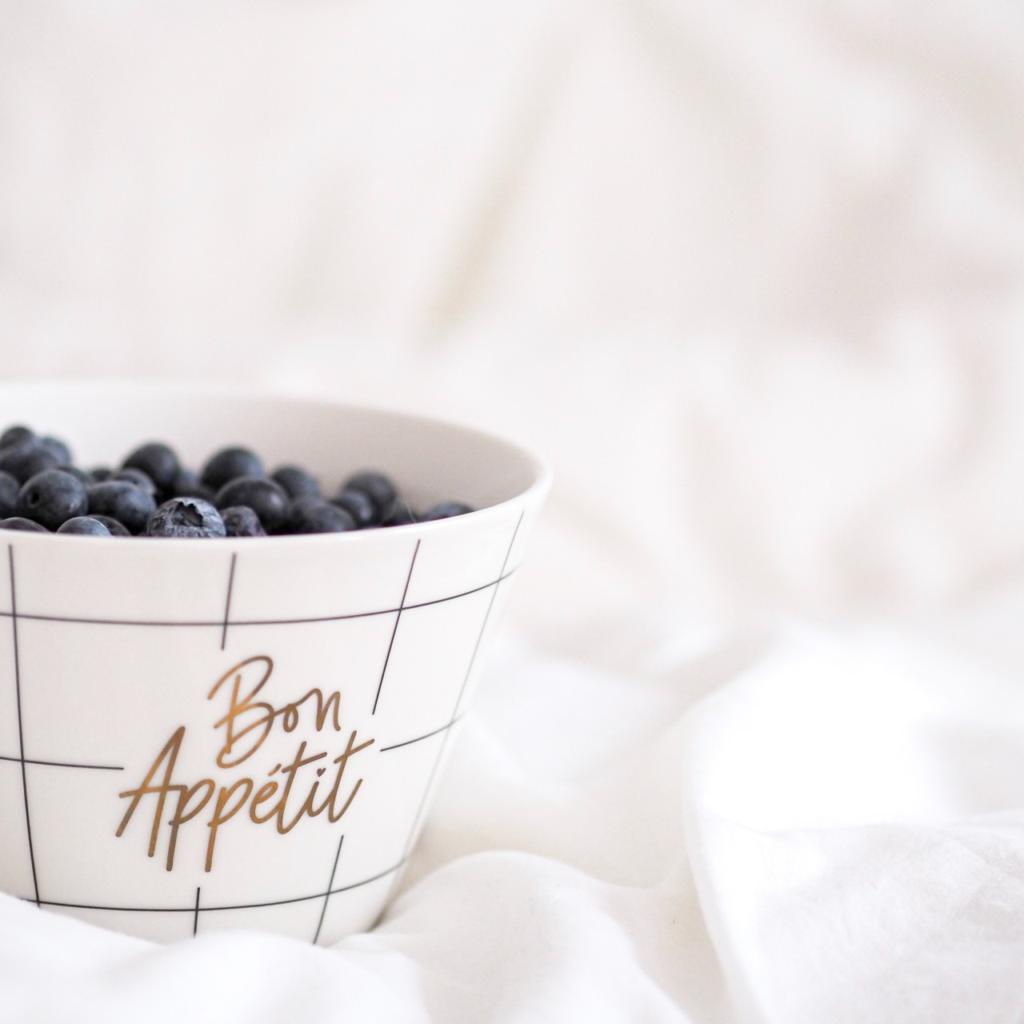
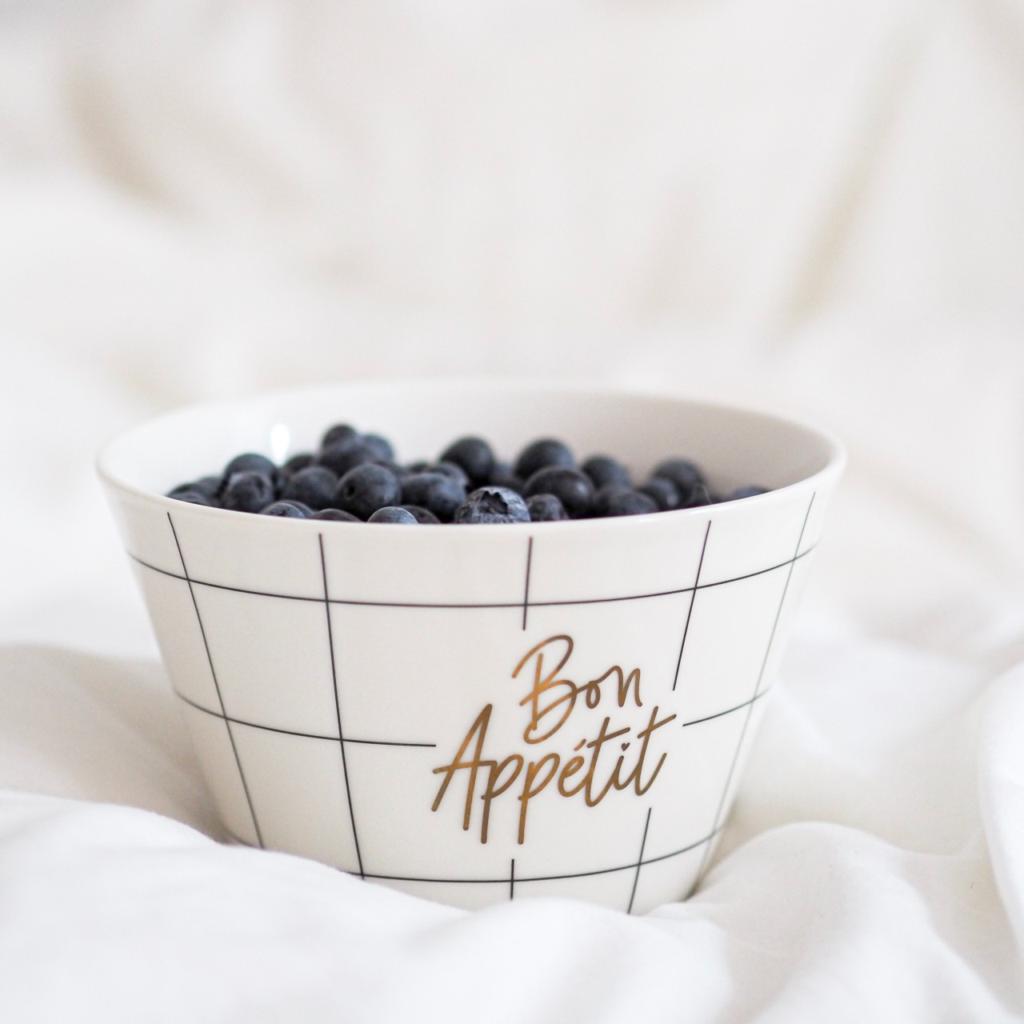
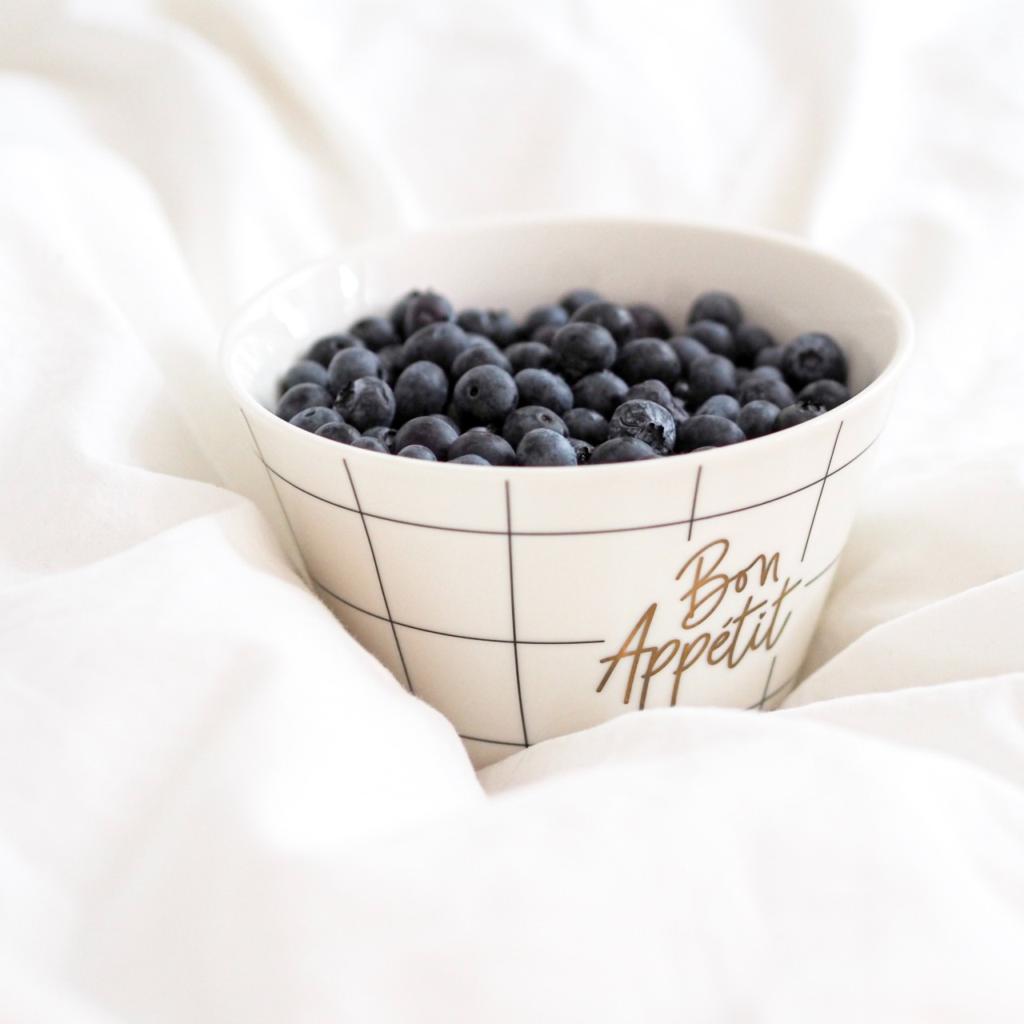
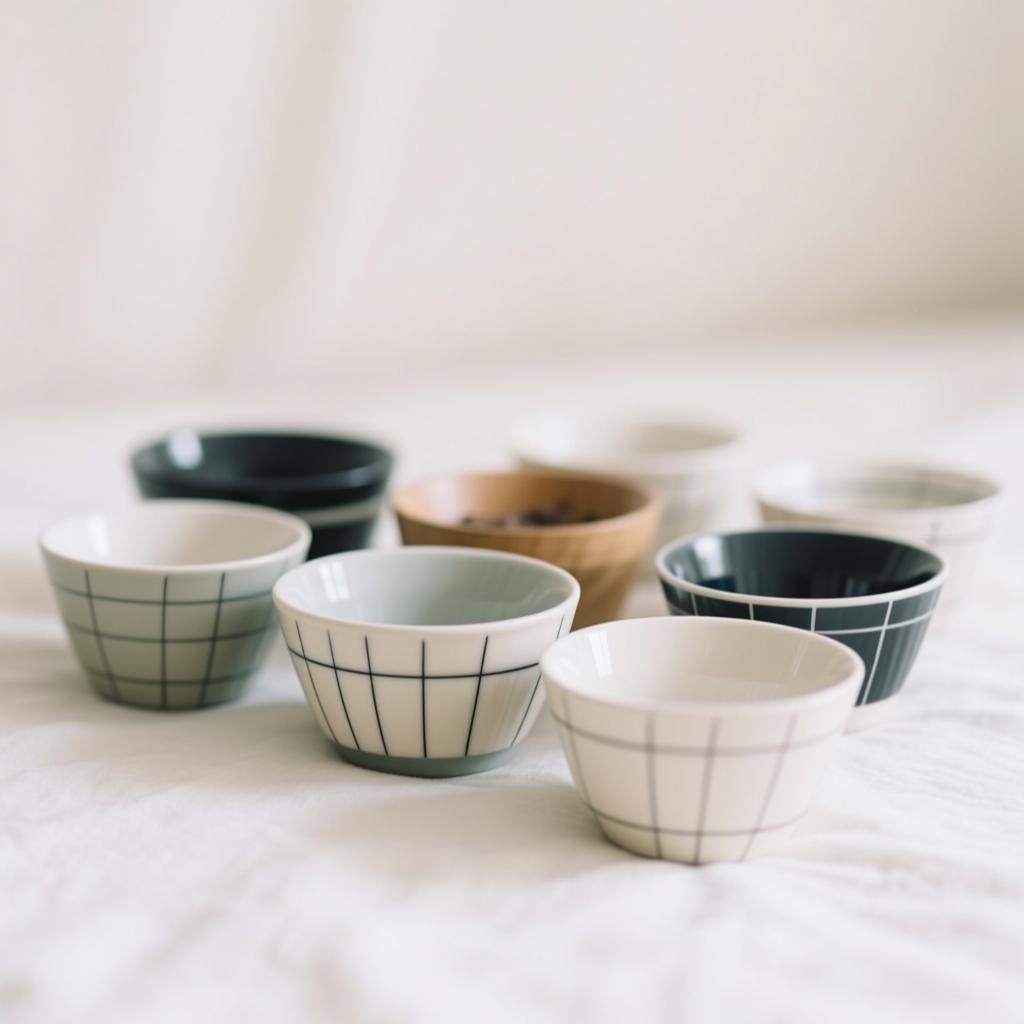
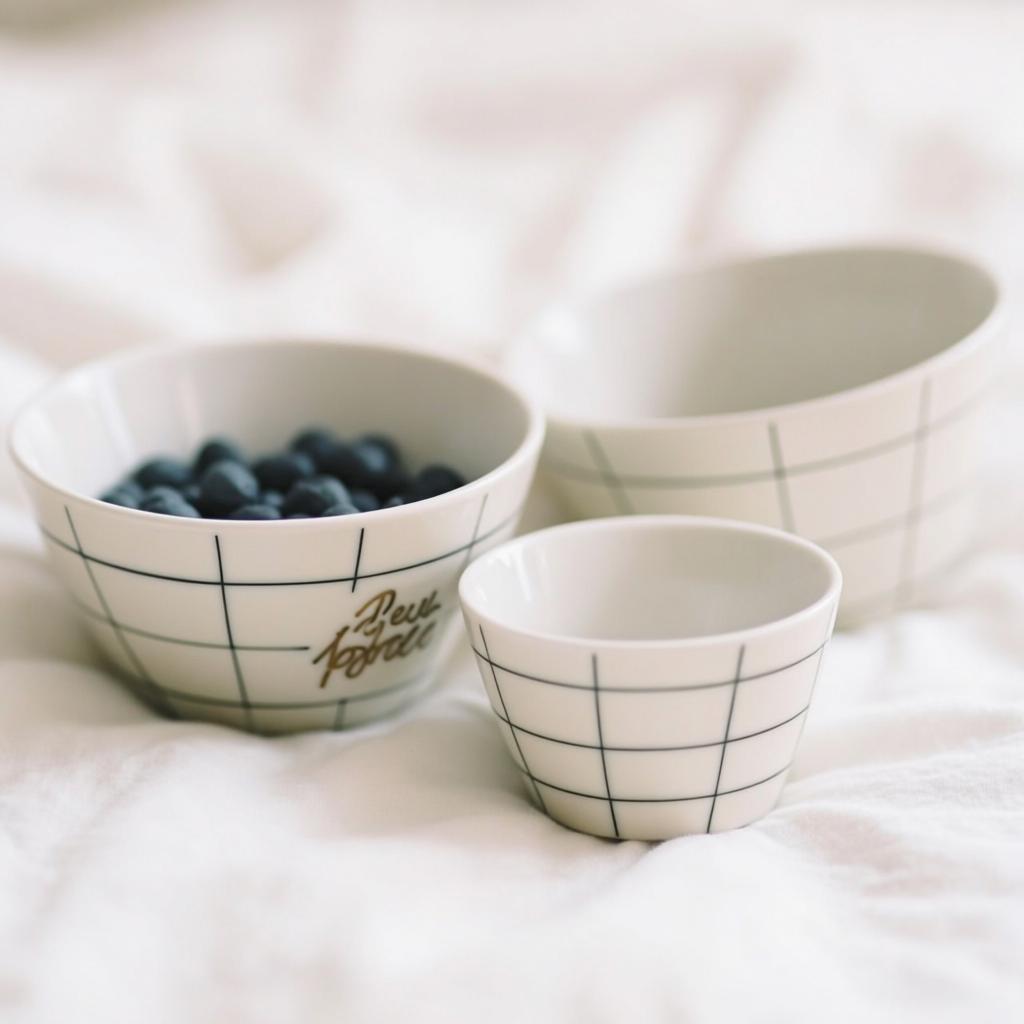
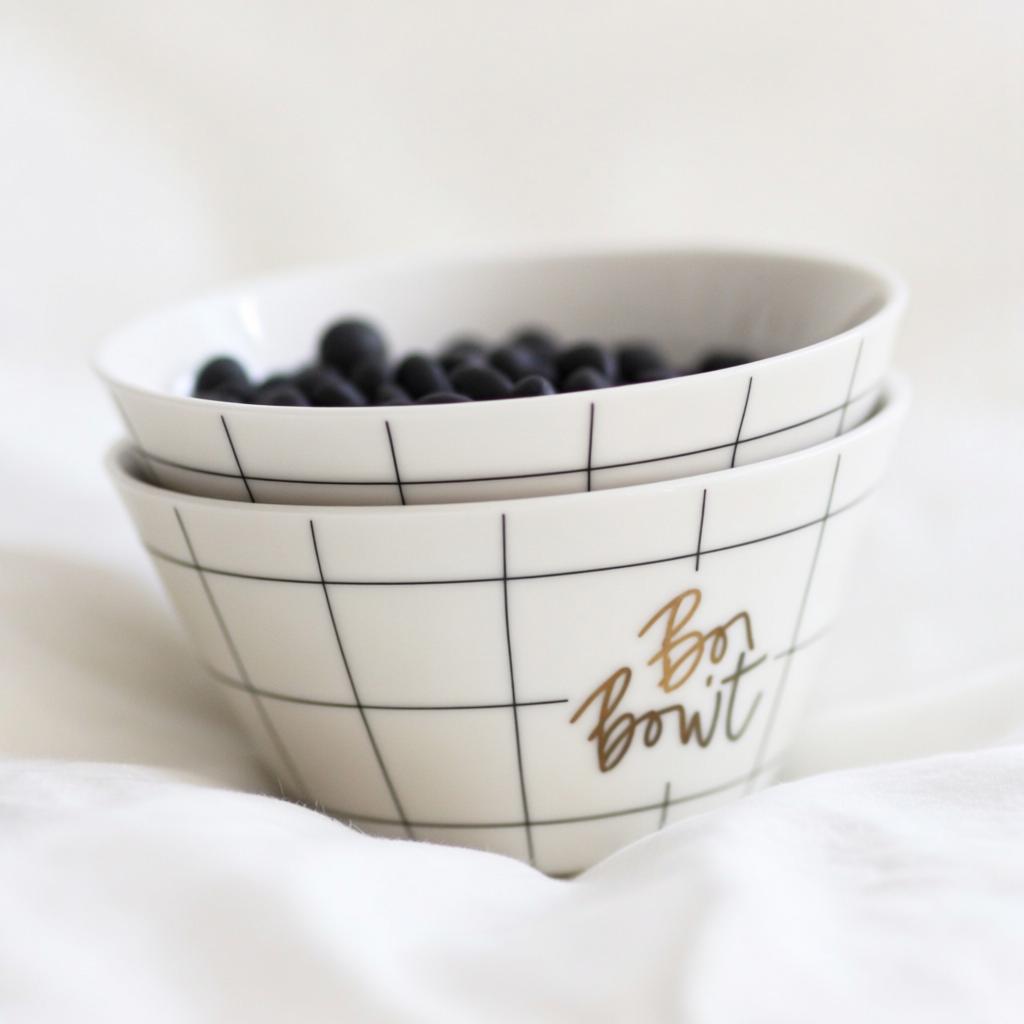
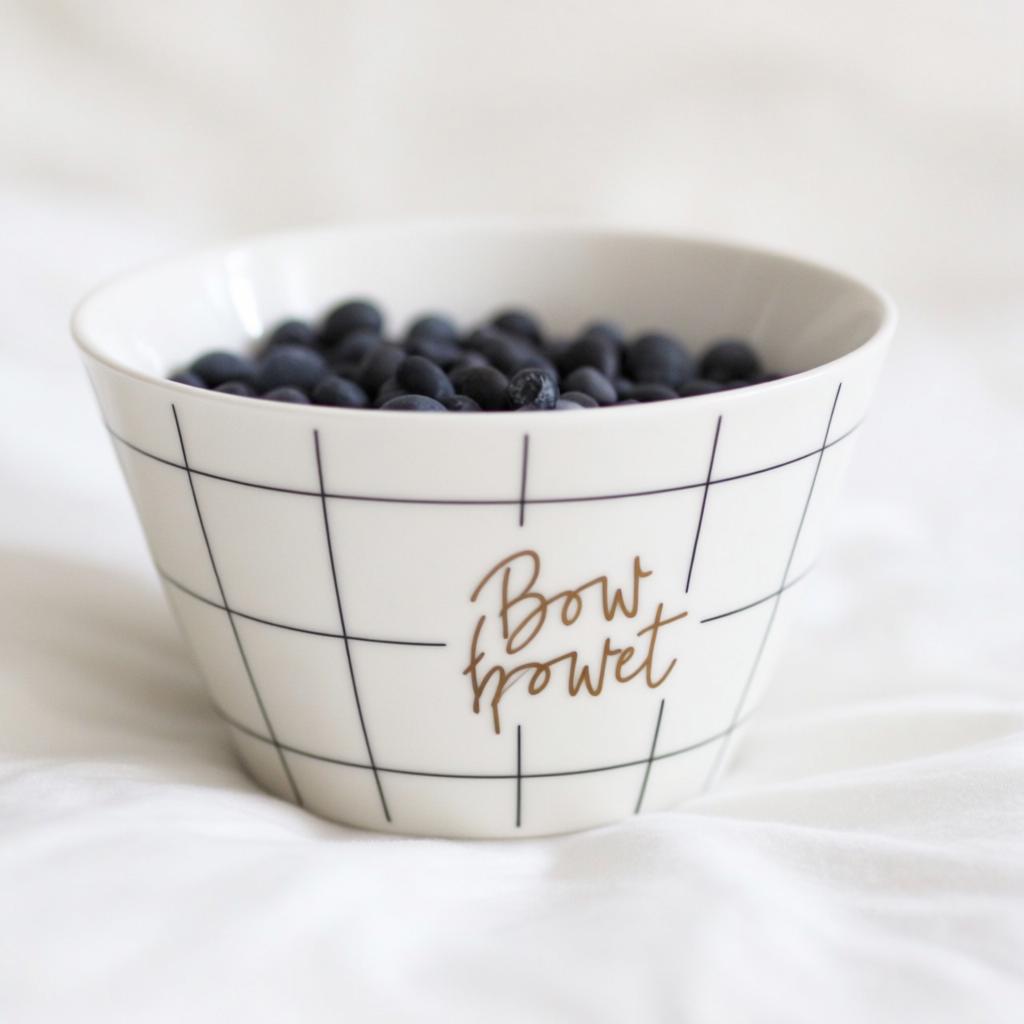
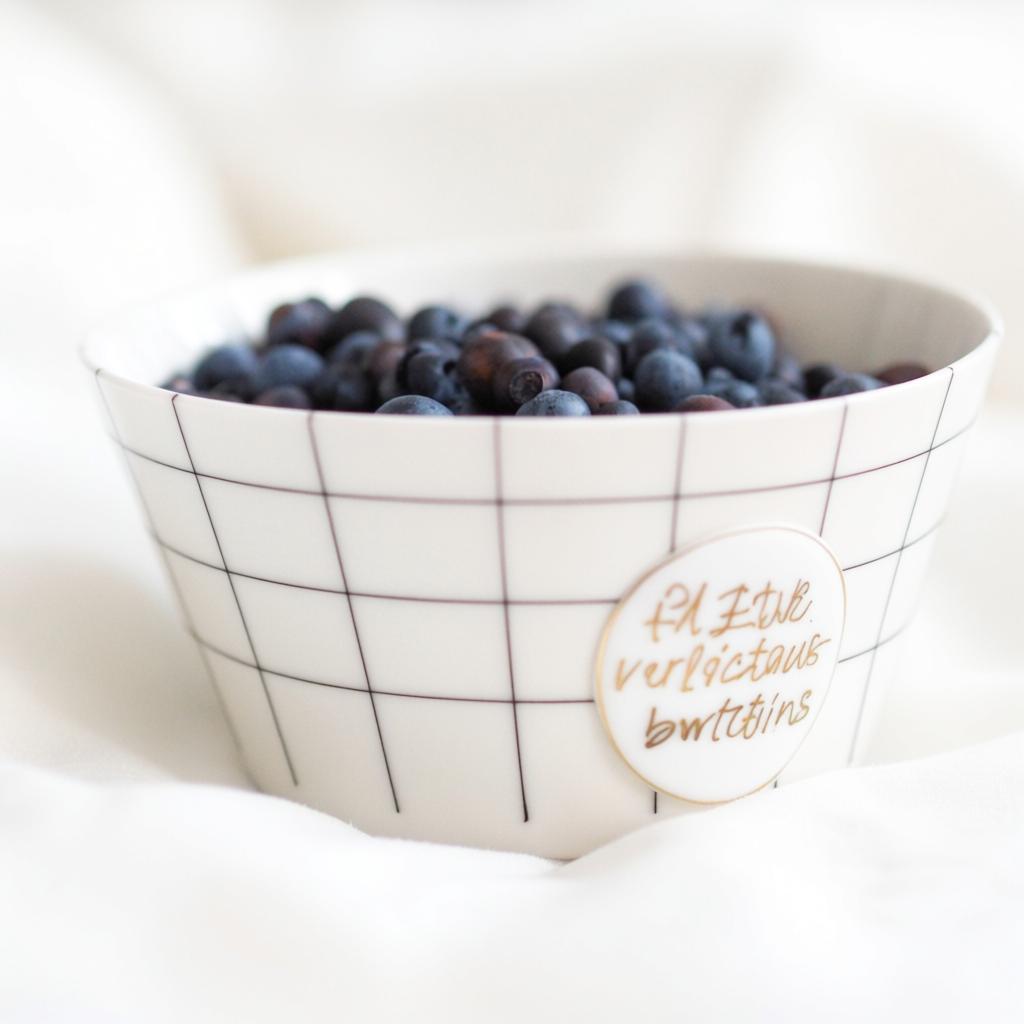
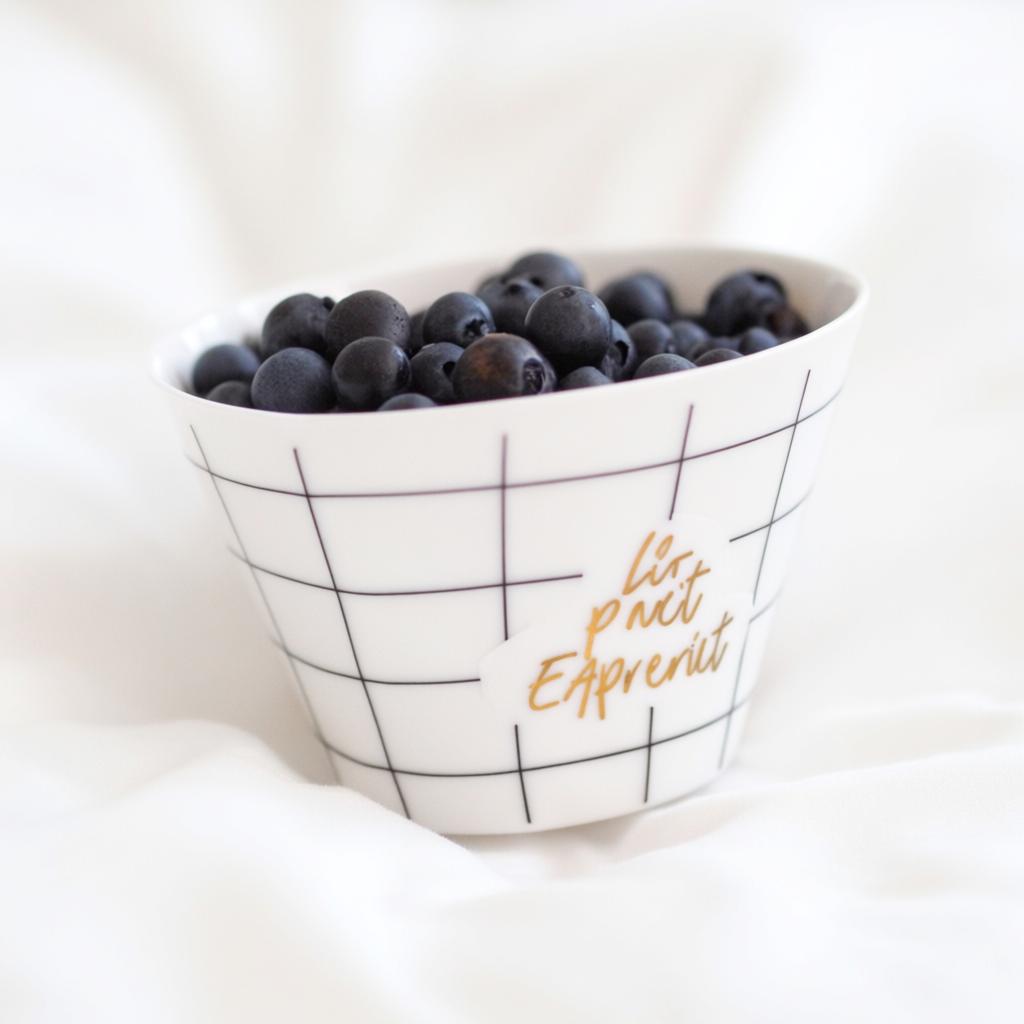
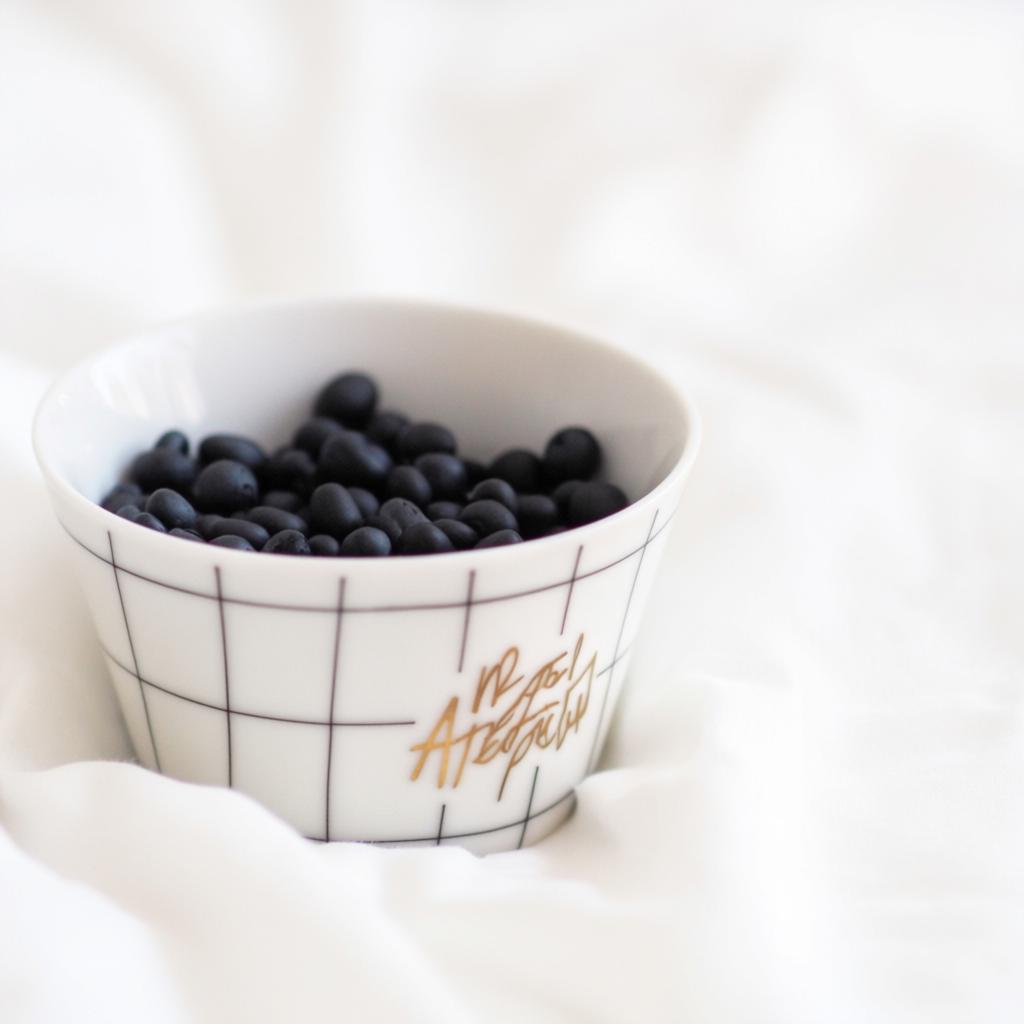
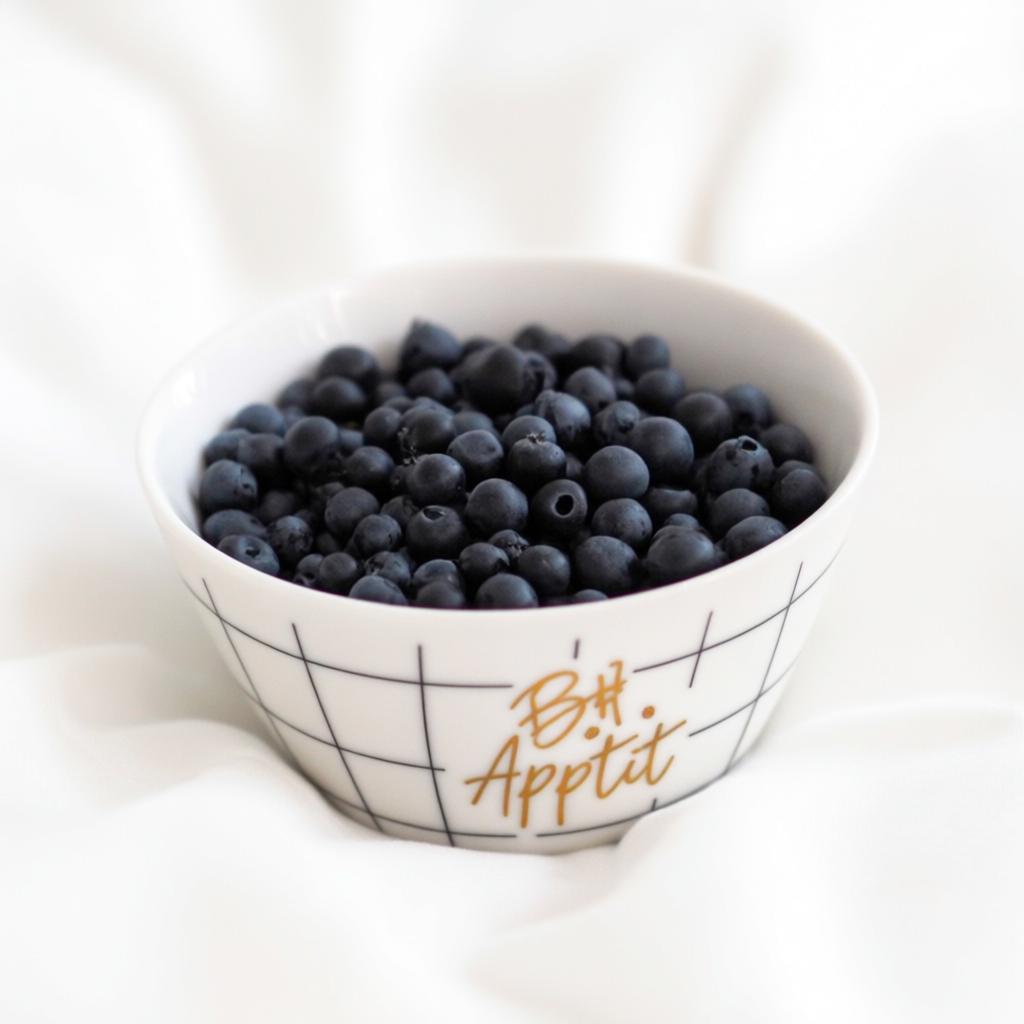
LoRA 数据集:蓝莓小碗
训练数据:
 |
 |
 |
 |
 |
 |
|---|
训练中的样图生成:
| 训练步数:100 | 训练步数:200 | 训练步数:300 | 训练步数:400 | 训练步数:500 | |
|---|---|---|---|---|---|
| 随机初始化 | 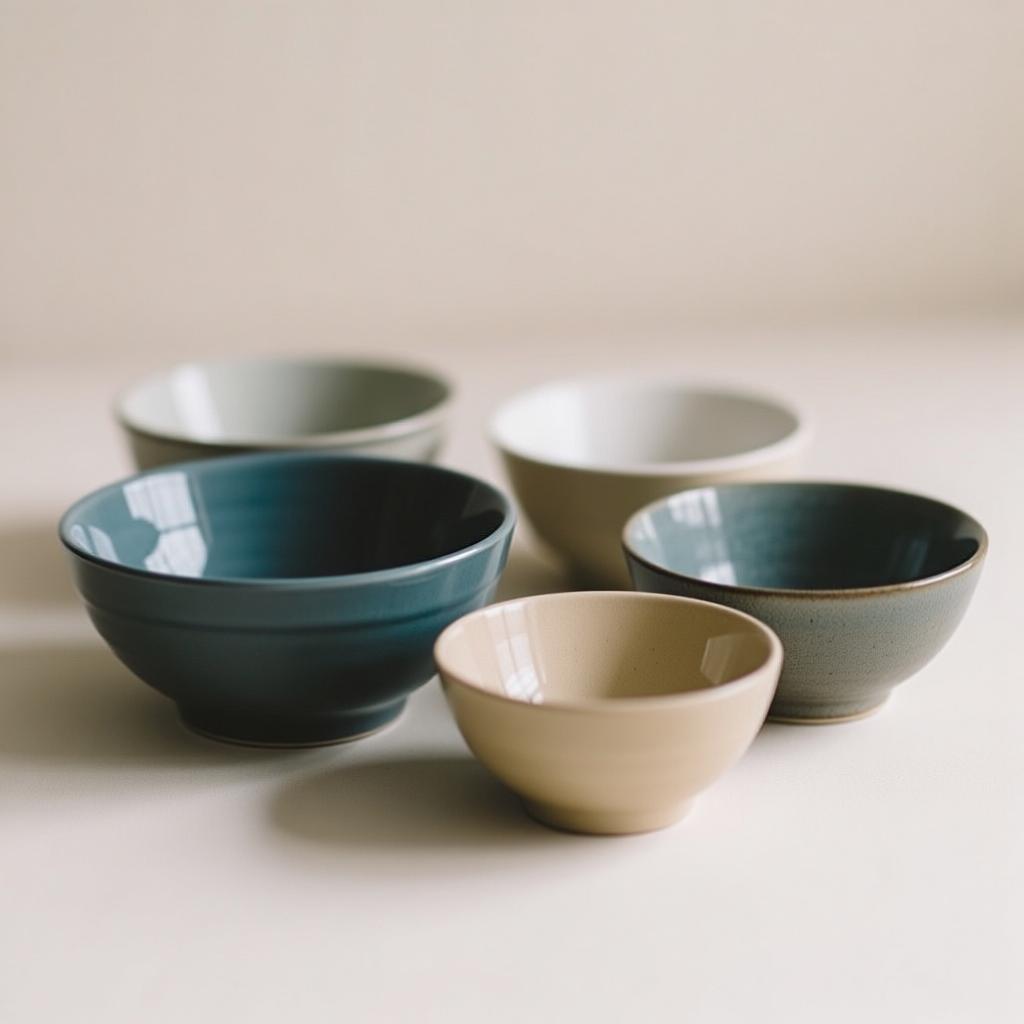 |
 |
 |
 |
 |
| Image to LoRA 初始化 | 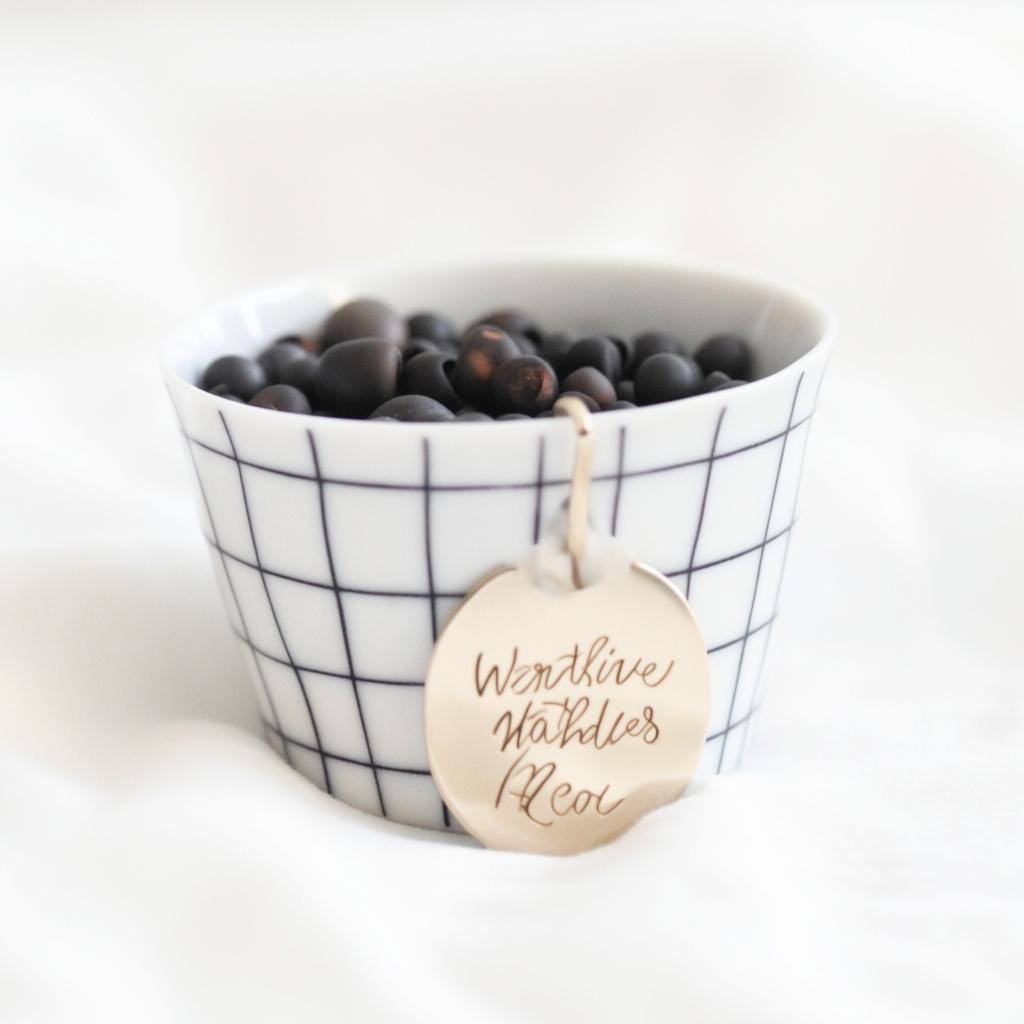 |
 |
 |
 |
 |
五、总结
可以预见的是,未来一年里,围绕 LoRA 的生态(市场、素材库、工具链)会越来越丰富。而 Qwen-Image-i2L 这种从“模型侧”降低门槛的尝试,大概率会拉开一波新的风格资产化浪潮。
对搞 AI 创作、做工具产品的同学来说,现在是一个非常值得盯紧、顺势布局的时间点。
感谢分享,看看