


一、SAM3介绍
Meta正式发布并开源新一代Segment Anything Model 3(SAM 3),一个用于图像和视频中可提示分割的统一基础模型,能够通过文本提示或点、框、掩码等视觉提示来检测、分割和跟踪目标。
图像分割方向一直以来的难题是用户往往希望分割那些不在预定义列表中的概念,但传统模型通常只能分割特定目标。比如,现有模型可以轻松分割“人”这类常见对象,却难以处理如“红色条纹伞”这样更精细、更具体的视觉概念。
SAM 3 通过引入“可提示概念分割”能力,有效克服了这一局限:它能够根据文本提示或示例图像,自动识别并分割出所有符合该概念的实例。
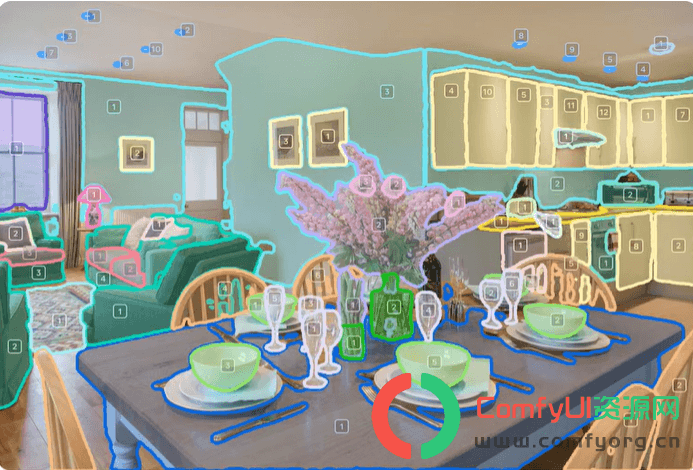
主要功能
多模态提示支持:SAM 3 支持通过文本、示例和视觉提示(如点击、框选)检测和分割图像及视频中的对象,适应多种用户需求。
图像和视频分割:SAM 3 能在图像中检测和分割所有匹配对象,支持在视频中跟踪对象,且能实时交互性修正分割结果。
零样本学习:SAM 3 能通过开放词汇的文本提示处理未见过的概念,无需额外训练即可分割新对象类别。
实时交互性:支持用户通过添加额外的提示(如点击或框选)修正模型的错误,进一步优化分割结果,提升用户体验。
跨领域应用:SAM 3 广泛应用在创意媒体工具(如 Instagram Edits)、家居装饰预览(如 Facebook Marketplace)和科学领域(如野生动物监测)。
二、相关安装
插件地址:https://github.com/PozzettiAndrea/ComfyUI-SAM3
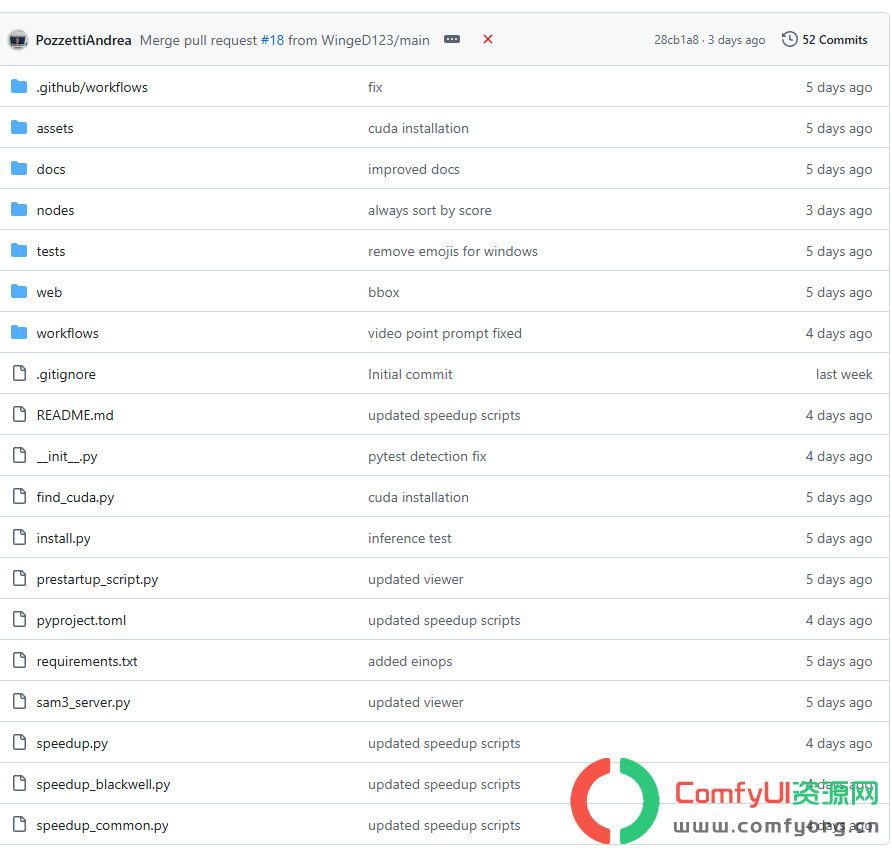
模型安装
下载sam3,放到models目录下就行。
模型路径:model/sam3/
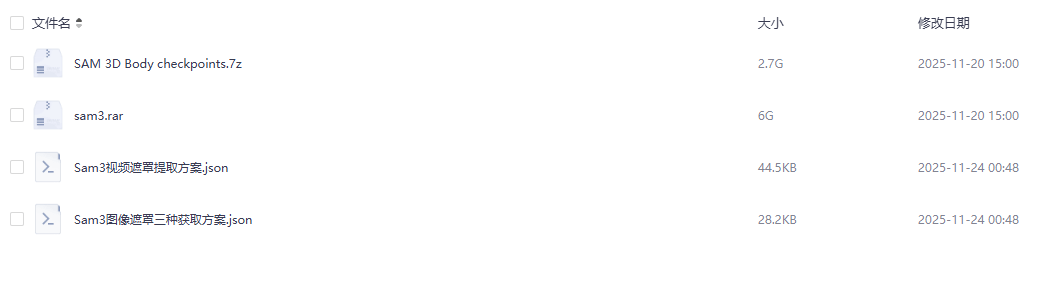
三、工作流
图片分割示例:
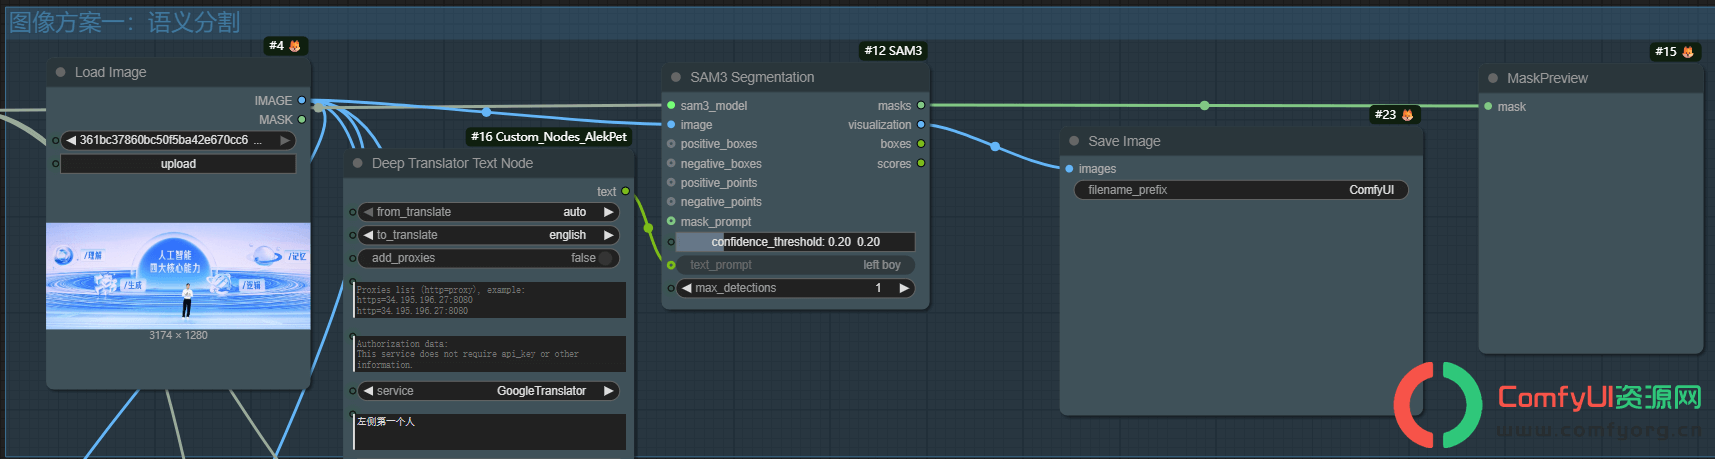
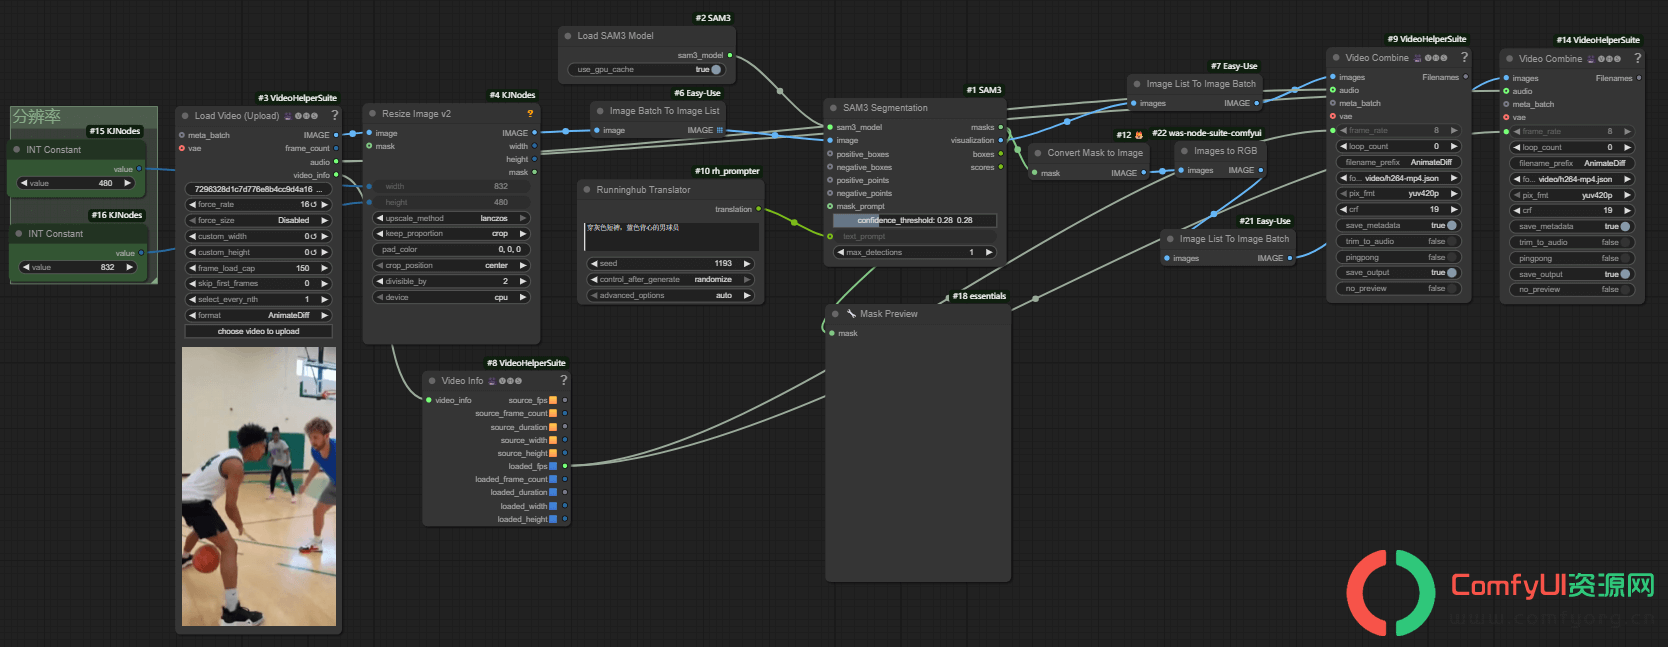
视频分割示例:
总结:
SAM 3 核心的“可提示概念分割”能力,彻底改变了传统模型依赖固定标签的工作模式。无论是“条纹红色雨伞”这样的具体描述,还是通过图片示例,模型都能准确理解并执行分割任务。为验证性能,团队构建了包含 21.4 万个概念的 SA-Co 基准数据集,其概念覆盖范围达到现有基准的 50 倍以上。