


🌈 Qwen-Image-Edit-MeiTu
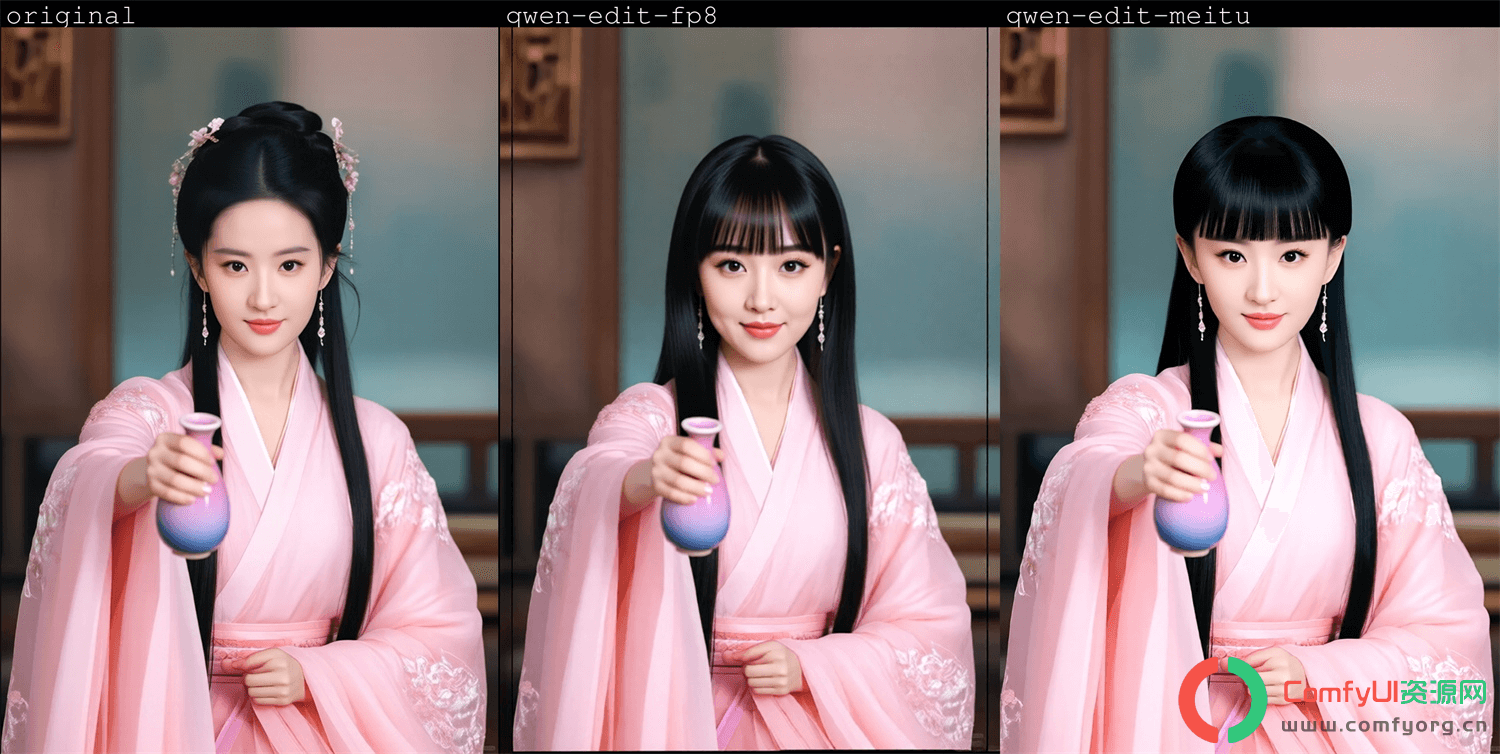
Qwen-Image-Edit-MeiTu是 Qwen/Qwen-Image-Edit 的改进版本,采用基于 DiT 的架构微调技术,旨在提升复杂编辑中的视觉一致性 、 美学质量和结构对齐 。Valiant Cat AI Lab正式发布Qwen-Image-Edit-MeiTu模型,作为Qwen/Qwen-Image-Edit的进阶版本,该模型通过基于DiT架构的深度微调,在视觉一致性、美学表现力和结构精准度三大核心维度实现突破性提升,为专业创作者和设计团队提供了更接近商业级需求的智能编辑工具。该版本致力于进一步缩小高保真语义编辑与连贯艺术渲染之间的差距,在各种提示和主题下实现更自然、更专业的输出效果。
- 增强一致性 :
采用 DiT(扩散 Transformer)微调技术,确保输入区域与编辑区域之间的结构稳定性 ,保持全局空间连贯性。 - 美学优化 :
使用美学判别器及精心策划的美学评分数据集进行训练,生成更令人愉悦的色彩、对比度和光线平衡 。 - 更好的细节保留 :
改进了低层重建,以保留精细细节,如纹理、面部和字体 。 - 更广泛的场景适应性 :
在肖像、环境、产品照片和插图上表现良好,支持语义和基于外观的编辑。
🌈相关模型与安装(文末网盘有合集)
模型(模型大小20GB+):
- qwen_image_edit_meitu_fp8_e4m3fn.safetensors
Diffusion model
- qwen_image_edit_fp8_e4m3fn.safetensors
- Edit-R1-Qwen-Image-Edit-2509.safetensors
- Qwen-Image-Edit-Lightning-8steps-V1.0.safetensors
Text encoder
- qwen_2.5_vl_7b_fp8_scaled.safetensors
VAE
- qwen_image_vae.safetensors
模型安装路径:
📂 ComfyUI/
├── 📂 models/
│   ├── 📂 diffusion_models/
│   │   └── qwen_image_edit_fp8_e4m3fn.safetensors
│   ├── 📂 loras/
│   │   └── >Edit-R1-Qwen-Image-Edit-2509.safetensors
│   │   └── Qwen-Image-Edit-Lightning-8steps-V1.0.safetensors
│   ├── 📂 vae/
│   │   └── qwen_image_vae.safetensors
│   └── 📂 text_encoders/
│ └── qwen_2.5_vl_7b_fp8_scaled.safetensors🌈工作流示例与体验
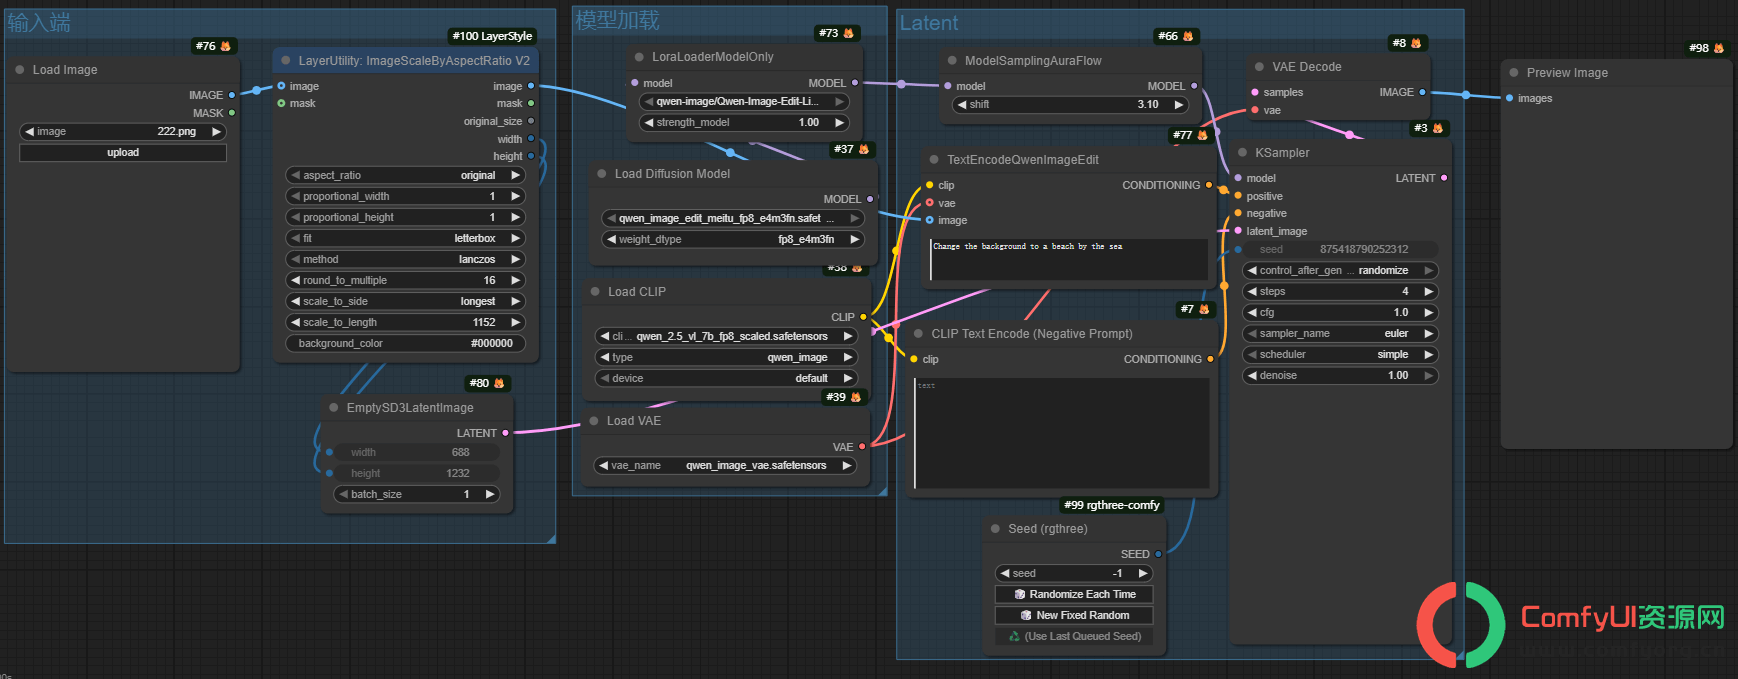
🌈效果预览
🌈总结
随着Qwen-Image-Edit-MeiTu的发布,AI图像编辑正从"技术实现"向"艺术创作"加速进化。这种将工程严谨性与美学创造力深度融合的技术路径,不仅为内容生产行业提供了效率工具,更重新定义了人机协作的创作模式。未来,随着多模态交互技术的发展,我们有理由期待AI编辑工具在"理解创意意图-实现视觉表达-优化呈现效果"的全链路中发挥更核心的价值。
温馨提示:本站提供的一切软件、教程和内容信息都来自网络收集整理,仅限用于学习和研究目的;不得将上述内容用于商业或者非法用途,否则,一切后果请用户自负,版权争议与本站无关。在未征得本站同意时,禁止复制、盗用、采集、发布本站内容到任何网站、书籍等各类媒体平台。如若本站内容侵犯了原著者的合法权益,可联系我们进行处理。
正从"技术实现"向"艺术创作"加速进化。这种将工程严谨性与美学创造力深度融合的技术路径,不仅为内容生产行业提供了效率工具,更重新定义
新人学习,感谢