


Qwen3-VL是什么
Qwen3-VL 是阿里通义推出的 Qwen 系列中最强大的视觉语言模型,具备卓越的多模态能力。模型能理解纯文本、图像和视频,支持长上下文、空间感知、代码生成等功能。Qwen3-VL-235B-A22B是该系列的旗舰模型,包含 Instruct 与 Thinking 两个版本, Instruct 版本在视觉感知任务中表现优异, Thinking 版本在多模态推理中达到领先水平。Qwen3-VL 能像人类一样操作界面、进行复杂推理、生成创意文案,将设计图转化为代码。模型支持多语言 OCR 和长视频理解,广泛应用在教育、开发、自动化等领域,是当前多模态模型中的佼佼者。
Qwen3-VL-30B-A3B 是最新开源的多模态 AI 模型,仅需 30 亿激活参数,能在 STEM、视觉问答、OCR、视频理解、智能体任务等多领域媲美甚至超越 GPT-5-Mini 和 Claude4-Sonnet。模型推出了 FP8 版本,且同步上线 Qwen Chat,支持免费体验。
-
Qwen3-VL-8B Instruct:在MIABench、OCRBench、SUNRGBD、ERQA、VideoMMMU、ScreenSpot等30项权威基准测试中取得了SOTA(行业最佳)成绩,超越了Gemini 2.5 Flash Lite、GPT-5 Nano以及Qwen2.5-VL-72B等顶尖模型。
-
Qwen3-VL-4B Instruct:以更少的参数量,在STEM、VQA、OCR、视频理解及Agent任务等测试中,能与Gemini 2.5 Flash Lite、GPT-5 Nano对打,展现出优秀的多模态性能。
-
Qwen3-VL-8B Thinking:在MathVision、MMStar、HallusionBench、MM-MT-Bench、CountBench等23项权威基准测试中取得了SOTA成绩,超越了Gemini 2.5 Flash Lite、GPT-5 Nano高版本以及其他同等级顶尖开源模型。
-
Qwen3-VL-4B Thinking:同样表现出“以小敌大”的成绩,在多模态性能方面表现优异。
二、相关安装
插件安装:
https://github.com/IuvenisSapiens/ComfyUI_Qwen3-VL-Instruct
将此仓库下载或 git 克隆到 ComfyUI\custom_nodes\ 目录,然后找到自己整合包python目录(一般路径D:\ComfyuiV2.7\python)
python -m pip install -r requirement.txtpython的transformers>=4.57.1,一般的插件有冲突,可修改成transformers>=4.53.0
下载模型
如果ComfyUI\models\prompt_generator\目录中找不到这些模型,运行工作流时会自动下载所有模型。文末有具体的模型,直接下载即可。
- Qwen3-VL-4B-Instruct
- Qwen3-VL-4B-Instruct-FP8
- Qwen3-VL-8B-Instruct
三、工作流体验
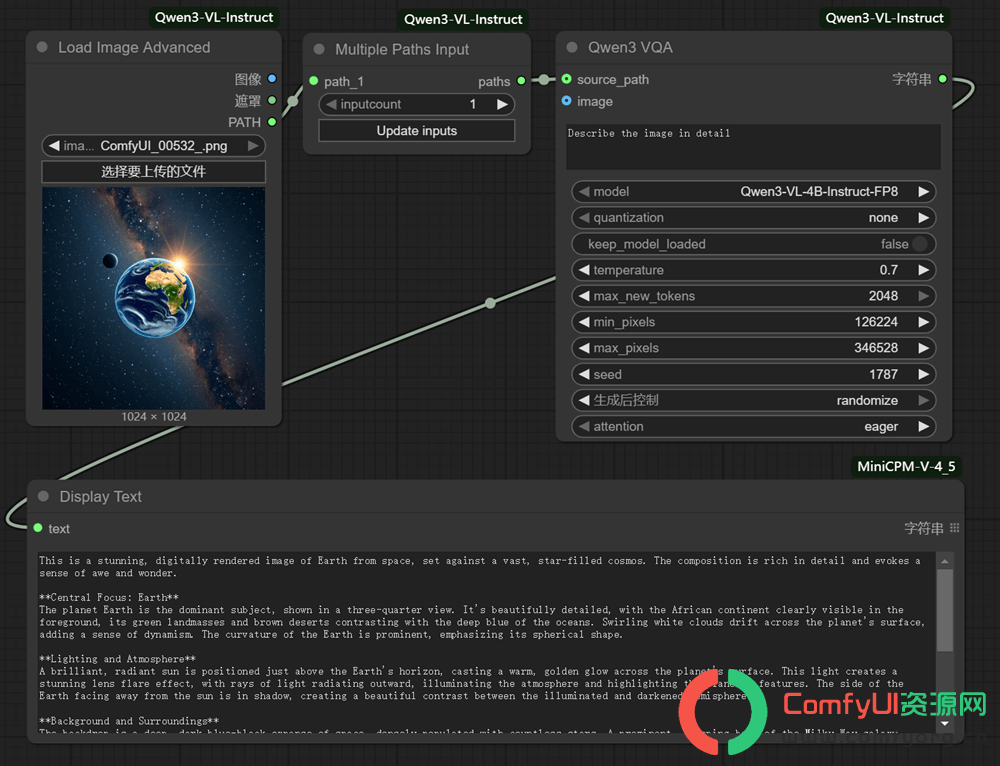
视觉模型最好的检验就是反推,官方示例如下:
单图查询:此工作流程支持为单张图片生成描述。用户可以上传一张照片并询问“这张图片展示了什么?”,从而得到类似“一头雄伟的狮子群在草原上放松”的描述。”
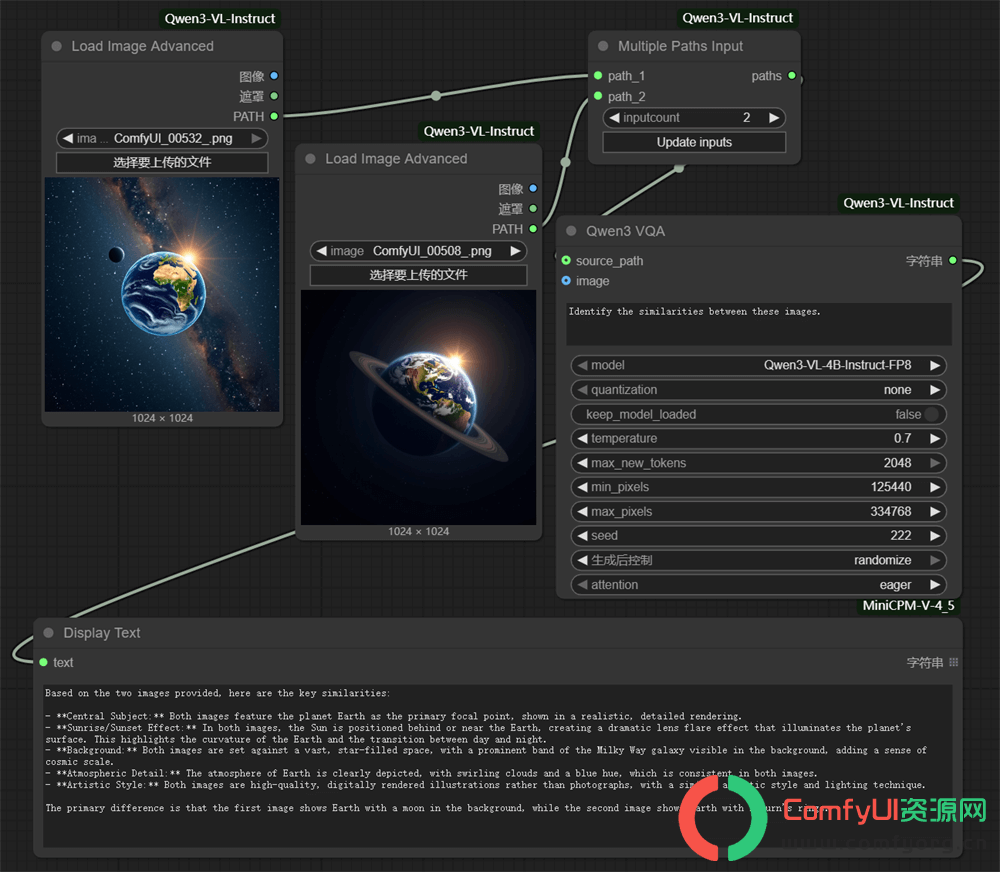
多图像查询:对于多张图像,系统可以提供整体描述或串联起图像的叙事。例如,“根据以下一系列图像创作一个故事:一张是情侣在海滩上的照片,另一张是婚礼仪式上的照片,最后一张是婴儿洗礼仪式上的照片。”
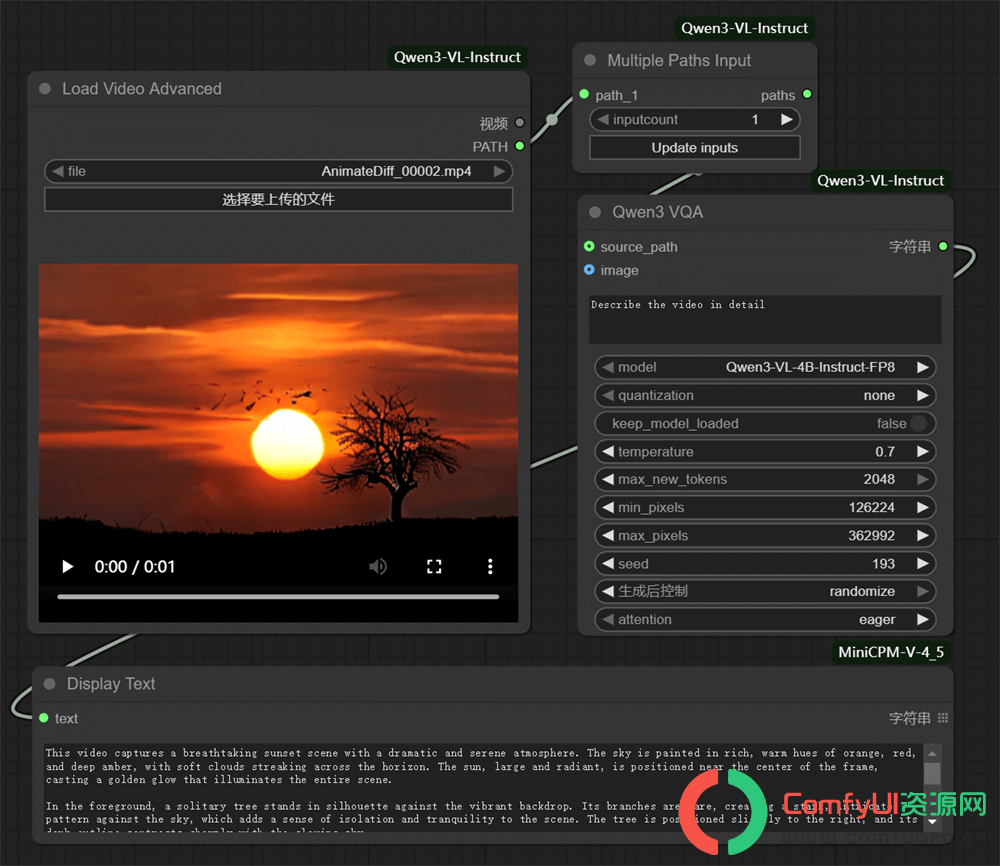
视频查询:当用户上传视频时,系统可以分析内容并为每一帧生成详细说明,或对整个视频进行总结。例如,“为给定视频生成说明。”
总结:
qwen3-vl模型成功实现了「视觉精准」与「文本稳健」的协同突破。针对小模型常见的「跷跷板」问题(即提升视觉能力往往牺牲文本性能,反之亦然),阿里团队通过架构创新与技术优化,在保持强大文本理解能力的同时,显著增强了多模态感知与视觉理解能力——真正做到了在「小身板」里塞进更强的视觉与文本双引擎。